GPT-Next泄露、Gemini 4 Argon临近:AI圈动态速览

OpenAI泄露GPT-Next并启动28天出货承诺,谷歌Argon密集升温,Anthropic订阅性价比报告引发热议。
本轮AI动态围绕头部实验室的竞争提速展开。OpenAI未发布模型GPT-Next泄露,早期估算显示其效率可能极高,或在28天出货承诺期内发布;该承诺要求团队每天交付有意义的改进,否则重置全体用户用量,首日已将GPT-6系列速度提升约50%。谷歌Gemini 4 Argon后端代号密集出现,发布窗口提前,Nano Banana 2.1已上线但表现平庸。此外,RSI疑云、Artificial Analysis的订阅性价比报告、OpenAI的TextString文本水印以及Reflection AI的开源模型Beam,共同勾勒出各家在效率、生态与合规上的较劲方向。
OpenAI的未发布模型GPT-Next在社区中露出端倪,谷歌Gemini 4 Argon的后端活动密集升温,Anthropic订阅的性价比被第三方报告推上风口浪尖。这一轮AI动态没有单一的重磅炸弹,但几条线索拼在一起,能看出头部实验室正在较劲的方向。
GPT-Next:神秘新模型泄露,价格可能才是杀手锏
据B站UP主「World of AI」的梳理,OpenAI内部有一个外界知之甚少的新模型,代号GPT-Next。它既不是GPT-Mini,也不是已被砍掉的GPT-6.1 Aster,而是与GPT-6.1系列非常接近的检查点——可能略强,但没有质的飞跃。最大的悬念在于价格:早期流传的估算称,约4万积分产出了价值约50亿Token的用量,如果属实,这意味着极高的效率。
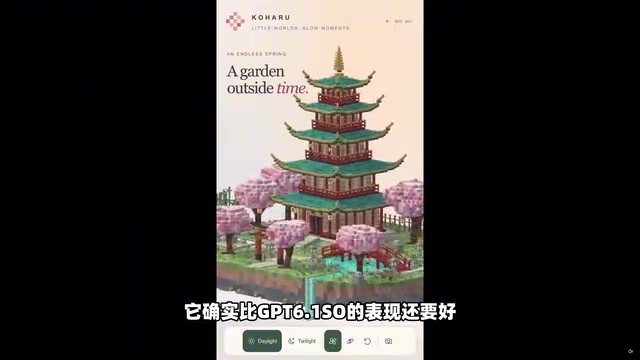
社区演示中,GPT-Next在三维场景搭建上表现亮眼——一个包含灯光、着色器和素材包的三维厨房场景,细节丰富到连不同宝可梦的动态模型都加了进去。需要说明的是,这类单一提速测试不足以定义模型能力,但它至少暗示OpenAI在「用心程度和创造力」上有细微调整。UP主推测,这款高效型号可能在这轮28天承诺期内发布。
OpenAI的28天承诺:每天不交付就重置用量
OpenAI产品负责人Tibor发起的28天出货承诺,是这轮动态里最有戏剧性的一笔。规则很直接:接下来28天里,团队要么给Codex和工作流用户带来有意义的改进,要么给所有人重置全部用量。第一天已经兑现——GPT-6 Aster和GPT-6.1的默认速度从每秒约30个Token提升到每秒50个左右,涨幅约50%,通过ChatGPT登录的合作伙伴(OpenCode、PIMP、Deven等)同样适用。
团队列出的四个专注方向是:简化产品、提升效率、让用户获得更多用量、交付突破性功能并发布新模型。UP主对此的解读颇为直白——Anthropic的新模型在效率和用量额度上全面施压,OpenAI这是被逼出来的冲刺。对用户来说,这28天无论如何都是双赢。
Gemini 4 Argon与Nano Banana 2.1:谷歌的双线推进
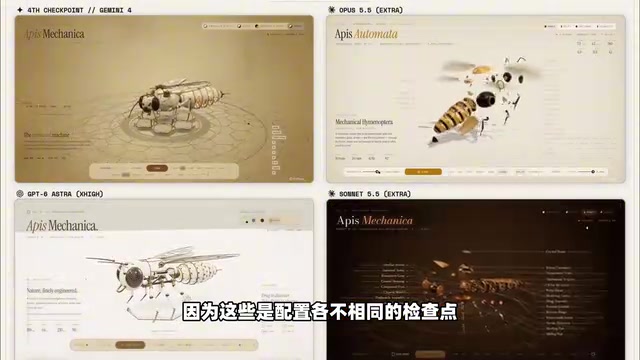
谷歌这边,Argon相关的模型代号正在后端日志里密集出现,包括多个实验性变体和Barium检查点,说明发布窗口比预期更近。这些检查点在配置上各不相同,涵盖修复、摘要功能和实验分支,反映的是积极打磨而非晾置原型。在SVG动画测试中,Argon完成了模拟银行卡支付的动画,包含刷卡和小票细节,表现优于对比模型。
图像侧,Nano Banana 2.1已出现在Gemini网页端和移动端。这个发布过程相当混乱:6月的Instant Ramen检查点被认为是Nano Banana 2,8月发布第二代时预计叫Nano Banana 2.5 Lite,两天后改名Spicy Mail,如今又以2.1的编号从Lite档调整到Flash档。与腾讯混元图像3.5的对比测试显示,Nano Banana 2.1在角色参考一致性上更扎实,混元则在灯光氛围和创意性上占优——但前者有一次完全无视「不要出现文字」的要求。整体评价:不算惊艳,但一致性可圈可点。
RSI疑云:谷歌在做自我改进系统吗
RSI指递归自我改善。此前相关说法多被视为传言,但谷歌后端日志里又出现了一个神秘的内部模型占位符,给「谷歌在实验RSI」的可能性添了一把火。考虑到谷歌近期Flash系列迭代速度之快,这个猜测并非空穴来风。不过UP主也明确提醒:单凭一个内部模型代号不足以证明谷歌攻克了RSI,它可能只是个命名,也可能是某种模仿机制。这条线索目前只能算拼图上的一块,不宜过度解读。
递归自我改善(RSI) 是AI安全与能力评估中的一个关键概念,指系统能够自主改进自身架构、训练流程或代码,并将改进后的版本用于下一轮自我提升,形成正反馈循环。它与常规的模型迭代有本质区别:后者依赖人类研究员设计实验、调整超参数和筛选数据,而RSI意味着AI开始承担部分甚至全部研发工作。学界通常把RSI视为通往超级智能的可能路径之一,也因此把它列为重点监控的“阈值能力”。目前所有公开模型都未达到真正RSI,但模型在代码生成、实验设计和自我评估上的进步,让“部分自动化AI研发”成为现实议题。谷歌后端出现内部模型占位符之所以引发联想,正是因为其Flash系列迭代节奏异常密集,外界猜测是否有自动化流程参与。
订阅性价比报告:Anthropic给的算力是OpenAI的数倍
Artificial Analysis发布了一份覆盖主流AI订阅的报告,结论相当扎眼。按API等效价值计算,同样约200美元档位,Claude Max能提供价值约12500美元的Sonnet用量、约12000美元的Opus用量;而ChatGPT Pro约为2000美元的GPT-6.1用量或3000美元的GPT-6 Aster用量。
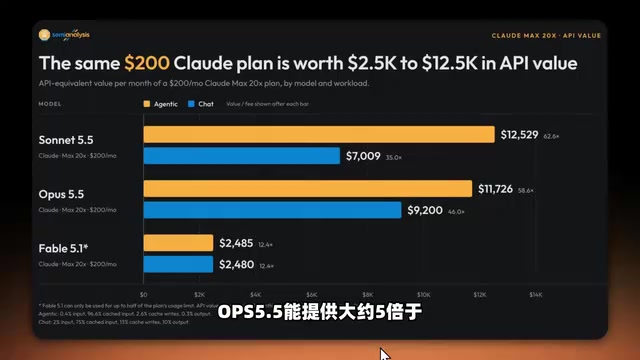
报告还提到,OpenAI近期把200美元档ChatGPT套餐的容量额度砍掉了一半左右,理由是GPT-6.1效率更高——这也被视为其为上市铺路的动作之一。高端档位存在例外:ChatGPT Pro在GPT-6 Aster上的给量略多于Anthropic对应套餐。
需要泼一盆冷水:API等效成本只回答「你花的钱换来多少原始用量」,不回答「哪个订阅更好」。模型质量、速度、上下文长度、编程与智能体能力、内置工具和生态整合,都不在这套数字里。Anthropic在原始算力上占优,不代表Claude Max在体验上就自动领先五倍。
API等效价值是订阅性价比评估中常用的换算方法:把订阅套餐内可用的token量按官方API的每百万token单价折算成美元金额,再与订阅费对比。它的优点是直观、可跨厂商比较,但局限也很明显——它假设所有token价值相同,忽略了模型质量差异、速率限制、上下文窗口、工具调用额度和高峰期限流等因素。此外,订阅条款通常禁止转售或批量API式调用,因此“等效价值”只是理论上限,实际可用量往往低于折算值。Artificial Analysis在报告中特别注明,该指标只反映原始算力配额,不构成体验优劣的判断依据。
其他值得留意的动态
文本水印:为响应欧盟AI法案,OpenAI将在欧盟通过ChatGPT和Codex生成的文本中嵌入不可见水印TextString。它不是塞隐形标记,而是把统计信号嵌入模型选词,事后可检测。OpenAI称其在文本水印测试中追平或超过谷歌的SynthID,且不明显损害输出质量,并计划开源。局限也很明显:改写、翻译都能破坏水印。
开源模型Beam:美国新实验室Reflection AI发布Beam,总参数约5010亿,激活参数仅230亿,专为推理、编程和智能体负载设计。
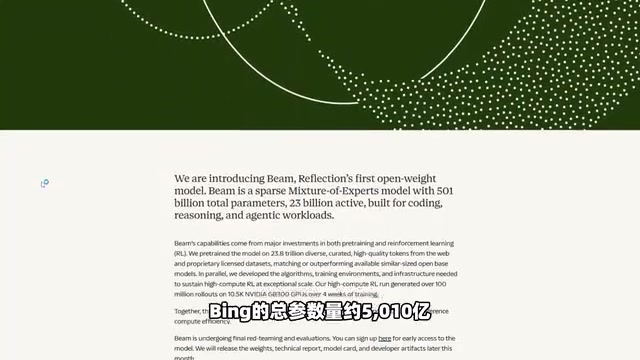
据其说法,Beam是从零端到端训练的,而非在现有开源模型上改造,完整权重将在本月晚些时候开放。
工具链更新:Google AI订阅用户可在Anti-Gravity中使用GPT-5.5 Medium和Sonnet 5.5 Medium,但额度有限。Claude Code新增Mode功能,其中Cache Control这个Mode用可视化进度条显示5分钟提示缓存窗口并发送通知,帮助维持缓存热度、降低Token消耗。Claude Projects则支持直接连接本地文件夹,云端会话可授权读写指定本地文件。
Fable 5.5演示:有人用单个单词提示让Fable 5.5做一个宝可梦混搭卡牌游戏,约一小时产出可玩成果,机制完整。这类演示的说服力有限,但确实展示了模型在长任务上的完成度。
文本水印(TextString) 属于统计水印的一种:模型在生成每个token时,依据一个只有检测方掌握的密钥,对候选词的概率分布做轻微偏置,使输出中隐藏着人类不易察觉、但统计上可检测的选词模式。检测时无需原始模型,只需密钥和足够长的文本即可计算似然比,判断文本是否由该模型生成。相比在文本中插入零宽字符或特定标记,统计水印更难被肉眼发现,也不改变可读性。其核心弱点是鲁棒性有限:同义改写、翻译、插入干扰文本或让另一个模型复述,都可能破坏水印信号。OpenAI称TextString在测试中追平或超过谷歌SynthID,并计划开源检测工具,但欧盟AI法案对水印的具体技术要求仍在细化中。
混合专家(MoE)架构 是理解Beam参数规模的关键。Beam总参数约5010亿,但每次前向推理只激活约230亿参数,这正是MoE的典型特征:模型由多个“专家”子网络组成,路由器根据输入token动态选择少数专家参与计算。这样可以在不显著增加单次推理成本的前提下扩大总参数量,从而提升知识容量与推理能力。MoE的挑战在于负载均衡、专家利用率和训练稳定性,端到端从零训练一个5000亿级MoE对数据和算力要求极高。Reflection AI强调Beam并非在现有开源模型上改造,若完整权重如期开放,它将成为开源社区中少见的超大规模MoE推理模型。
小结
这一轮动态的共同底色是竞争提速:OpenAI用28天承诺逼自己出货,谷歌用密集检查点缩短发布周期,Anthropic则在用量经济性上拿下第三方报告的高分。GPT-Next是否真如估算般便宜、Argon能否兑现打磨后的完成度、RSI是真是假,接下来几周应该会有更清晰的答案。
相关推荐

MIT讲座:法律学者谈用AI拯救与超越民主
MIT Compton Lecture上,法律学者Martha Minow警告AI可能导致“启蒙的丧失”,主张民主既要借助AI提升参与和透明度,也需以制度与公民空间超越算法逻辑,防止技术掏空民主实质。
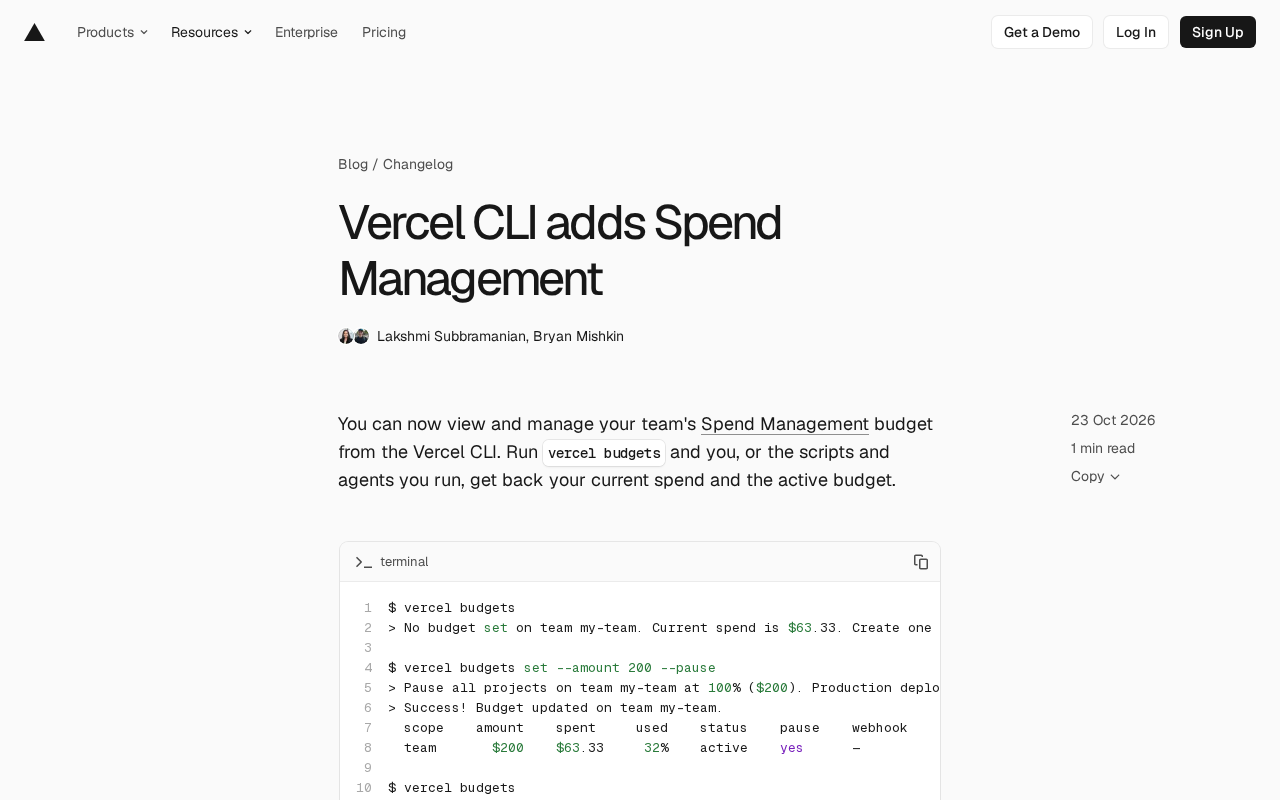
Vercel CLI 上线预算管理:终端管控团队花费
Vercel CLI 新增 Spend Management 预算管理功能,支持通过 vercel budgets 命令查看、设置和删除团队预算,并能查询预算告警历史,支持 --pause 在超支时暂停生产部署。

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。