SlickToken:GPU集群与智能体工作流规划工具深度解析

GPU资源规划:AI落地的隐形门槛
随着大模型和智能体(Agentic)应用的快速普及,企业对GPU算力的需求呈爆发式增长。当前主流AI训练与推理所依赖的高端GPU(如NVIDIA H100、A100系列)单卡售价普遍在2万至4万美元区间,一个中等规模的8卡节点采购成本即可达到数十万美元。加之配套的高速互联网络(InfiniBand或NVLink)、散热基础设施与运维人力,企业自建GPU集群的总拥有成本(TCO)往往比表面硬件成本高出2-3倍。云端按需租用虽然灵活,但H100实例每小时费用可达30美元以上,长期运行同样代价不菲。这一成本结构使得"用多少、买多少"的精准规划成为企业降本增效的核心议题。然而,GPU集群的建设成本高昂,如何在有限预算内合理配置资源、优化工作流,成为许多技术团队必须直面的现实难题。
近期,一款名为 SlickToken(www.slicktoken.ai)的工具在Reddit上引发讨论,它主打 GPU集群与智能体工作流规划 能力,试图为这一痛点提供系统性解决方案。
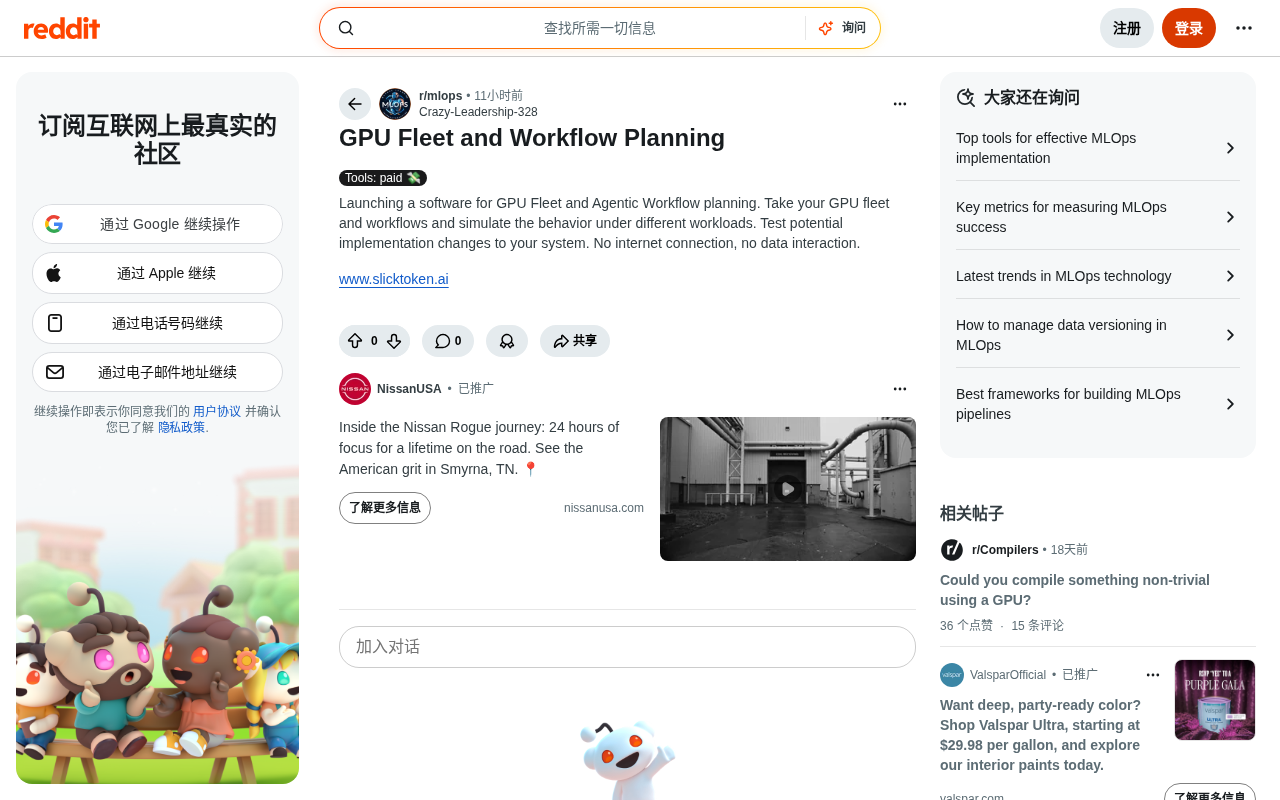
本文结合该产品的公开信息,分析其核心定位、技术价值及在AI基础设施领域的潜在意义。需要说明的是,目前该产品公开资料较为有限,以下分析基于其官方描述展开。
SlickToken 的核心功能:仿真驱动的资源规划
模拟GPU集群的真实负载行为
根据官方描述,SlickToken 的核心能力是让用户导入自己的GPU集群配置与工作流,并在不同负载场景下模拟系统行为。这一功能的价值在于:在正式部署或大规模上线之前,团队可以通过仿真提前预判系统在高并发、峰值流量等场景下的表现。
对于运行大模型推理或训练任务的团队而言,GPU资源的调度策略与排队机制直接影响成本和响应延迟。在大模型推理场景中,主流的调度优化技术包括:连续批处理(Continuous Batching),即在请求执行过程中动态加入新请求,显著提升GPU利用率;PagedAttention(由vLLM项目首创),通过将KV Cache分页管理降低显存碎片化;以及优先级抢占调度,在SLA(服务等级协议)要求不同的任务之间动态分配算力。排队模型方面,推理服务通常需要平衡首Token延迟(TTFT)与整体吞吐量(Tokens Per Second)之间的矛盾——激进的批处理能提高吞吐,但会增加单请求等待时间。借助仿真工具,工程师无需在真实环境中反复试错,从而节省昂贵的算力开销与调试时间。
安全验证系统变更方案
SlickToken 的另一核心能力是允许用户测试对系统实现的潜在变更。当团队考虑调整调度算法、增减GPU节点或改变工作流拓扑时,可以先在仿真沙盒中验证这些变更的实际影响,而不必冒险在生产环境中直接操作。
这种"沙盒式"规划思路,本质上是将传统**容量规划(Capacity Planning)**与现代AI工作流相结合。容量规划是IT基础设施管理中的经典方法论,其核心目标是在满足业务性能需求的前提下,以最低成本配置计算、存储与网络资源。传统容量规划依赖历史监控数据与统计模型(如排队论中的M/M/c模型)预测资源需求。进入AI时代,大模型推理的负载特征与传统Web服务截然不同:单次请求的显存占用高达数十GB,且不同请求长度导致计算时间高度不均匀,批处理策略和KV Cache管理机制都会显著影响吞吐量与延迟的权衡关系。这些复杂性使得传统容量规划方法难以直接套用,专门针对LLM推理场景的仿真工具因此具有独特价值。对于涉及多步骤、多模型协作的智能体系统,提前建模与仿真验证显得尤为关键。
离线运行与数据安全:企业级用户的核心诉求
无需联网,数据完全本地化
在产品描述中,有一句话格外醒目:"No internet connection, no data interaction"(无需互联网连接,无数据交互)。这意味着 SlickToken 可以完全在本地或隔离环境中运行,用户的集群配置与工作流数据不会上传至任何外部服务器。
对于金融、医疗、政府及有严格合规要求的企业而言,这一特性极具吸引力。数据主权(Data Sovereignty)是指企业或国家对其数据拥有完全的控制权与管辖权,近年来已从法律概念延伸为IT采购的核心评估维度。在监管层面,欧盟GDPR、中国《数据安全法》及《个人信息保护法》均对数据跨境传输设置了严格限制;在行业层面,金融机构通常须遵循DORA(数字运营弹性法案)及各地金融监管要求,医疗机构面临HIPAA等合规约束。这些背景推动了"私有化部署"(On-Premises Deployment)与"气隙隔离"(Air-Gap)架构的回潮。GPU集群的拓扑结构和工作流设计往往涉及企业核心技术机密,离线运行的设计直接消除了数据泄露风险,契合当前企业对数据主权与私有化部署的普遍诉求。
精准命中企业安全痛点
近年来,随着AI工具的广泛普及,企业对第三方SaaS工具的数据安全审查日趋严格。许多组织宁可牺牲部分便利性,也要优先选择本地化、可控的解决方案。SlickToken 的离线定位,将"安全可控"作为核心差异化卖点,在市场上形成了清晰的竞争区隔。
智能体工作流规划:填补新兴市场空白
从单模型调用到多智能体协作
SlickToken 特别强调了 Agentic Workflow(智能体工作流) 的规划能力,折射出AI应用正从单一模型调用向多智能体协作复杂系统演进的行业趋势。
Agentic Workflow是指由多个AI智能体协作完成复杂任务的系统架构。与单次模型调用不同,智能体工作流通常包含:Orchestrator(编排器)负责任务分解与调度、多个专职子智能体(如检索、代码生成、推理等)、工具调用层(Tool Use,包括搜索引擎、代码解释器、数据库接口)以及多轮对话与反馈循环机制。代表性框架包括LangGraph、AutoGen、CrewAI等。这类系统的GPU负载呈现出高度的突发性和不规律性——某些节点可能在等待外部API响应时完全空闲,随后又在短时间内产生密集的并发推理请求,形成"突发-静默"交替的复杂负载曲线,对资源调度器提出了远超传统批处理任务的挑战。专门针对智能体工作流的仿真与规划工具,正是为此而生。
算力规划走向数据驱动与精细化
过去,GPU资源规划往往依赖经验估算和粗放式扩容。随着算力成本持续攀升,这种方式越来越难以为继。SlickToken 这类工具的出现,标志着AI算力规划正朝着数据驱动、仿真验证的精细化方向发展。通过量化不同配置下的性能与成本,团队能够做出更理性的资源决策,避免过度采购或资源浪费。
冷静审视:现阶段的局限与观察
作为一款刚刚发布的产品,SlickToken 目前公开的信息仍相当有限。其仿真引擎的精度如何、支持哪些GPU型号与主流框架、定价模式怎样,以及仿真结果与真实环境的偏差程度——这些都是评估其实用价值的关键因素,目前尚无法得出明确结论。
此外,仿真工具的核心挑战在于建模的准确性。GPU集群的真实性能受多重底层因素影响:PCIe与NVLink带宽瓶颈、CUDA核心利用率与显存带宽之间的Roofline模型约束、多卡张量并行(Tensor Parallelism)与流水线并行(Pipeline Parallelism)的通信开销、NCCL集合通信(AllReduce、AllGather)的延迟,以及操作系统中断与驱动层调度抖动等。业界常用的仿真精度评估方法包括与真实压测数据的吞吐量误差对比(通常要求<15%)和P99延迟预测准确率等指标。此外,不同CUDA版本、cuDNN优化和特定硬件代际(如Ampere vs. Hopper架构)之间的性能差异也难以完全泛化建模,这是所有GPU仿真工具共同面临的方法论局限。因此,用户在使用此类工具时,应将仿真结果作为决策参考而非绝对依据,并结合真实环境进行交叉验证。
结语:一个值得关注的细分方向
SlickToken 所瞄准的"GPU集群与智能体工作流规划"是一个正在快速崛起的细分赛道。随着AI应用规模扩大与算力成本攀升,能够帮助团队提前规划、降低试错成本的工具将日益受到重视。其离线运行、数据不外传的设计,更是精准命中了企业级用户在数据主权与合规监管方面的安全痛点。
产品的最终价值,仍取决于仿真精度与实际易用性的持续打磨。对于关注AI基础设施优化与GPU资源管理的技术团队而言,这类工具值得持续跟踪,但也应在实际项目中审慎验证其落地效果。
核心要点
相关推荐
投票权失守之后:美国民主的隐性代价
探讨美国民主党未能通过《约翰·刘易斯投票权促进法案》和《自由投票法案》后,各州限制性投票立法、最高法院削弱《投票权法案》以及党派杰利蝾螈对选民参与和公平代表性的影响。

AI编程Agent最难的不是写代码,而是知道何时该动手
一位开发者分享构建AI编程Agent的经验:最难的不是让模型更聪明,而是让它知道何时直接动手、何时询问确认、何时完全不碰,配合自检沙箱与模型路由实现可控行为。

陶哲轩:AI正将优美数学变成训练废料
陶哲轩批评硅谷用AI强攻数学难题,将优美数学降格为原始训练材料,产生大量缺乏结构美感的证明。本文解析其“有毒废料”比喻背后的数学审美与激励冲突。