GRACE:检索增强修正,让医学图像分割更通用

GRACE 用检索增强的通用修正器替代逐器官训练的医学分割修正模型。
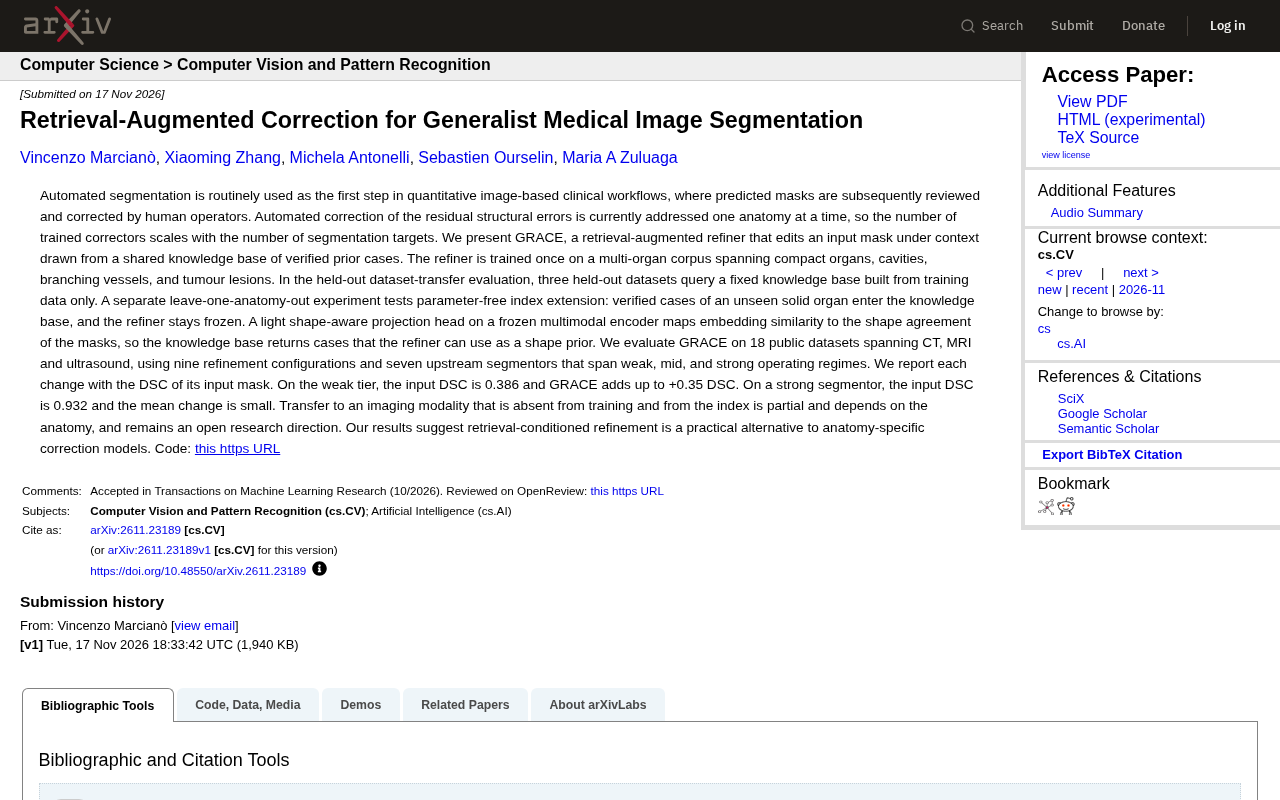
医学图像分割掩码的人工修正长期受制于“一个解剖结构一个模型”的范式,模型数量随目标增多而线性膨胀。GRACE 提出检索增强的通用修正器:在冻结的多模态编码器上训练轻量形状感知投影头,使共享知识库能按形状相似度返回已验证病例作为先验,从而在无需重新训练的情况下编辑输入掩码。研究在 18 个公开数据集、CT/MRI/超声三种模态、7 个上游分割器上评估,弱分割器(输入 DSC 0.386)上 DSC 最高提升 +0.35,强分割器(输入 DSC 0.932)上提升有限。跨模态迁移效果仍部分依赖解剖结构,是待解决的开放问题。
医学图像分割模型输出的掩码常需人工修正,传统方法需为每个解剖结构单独训练修正器,成本高昂。GRACE 提出一种检索增强的通用修正器,基于共享知识库中的先验病例来编辑输入掩码,无需针对特定解剖结构重新训练。
传统修正方法的局限
自动化分割是临床定量分析流程的第一步,但预测掩码往往存在结构误差,需人工审查修正。现有自动修正方案通常针对单一解剖结构(如肝脏、肾脏)设计,每新增一个分割目标就要训练新的修正器,导致模型数量随目标数量线性增长。这种“解剖特异性”范式不仅维护成本高,也难以适应多器官、多模态的临床场景。
GRACE 的核心思路是:用一个在多种解剖结构上训练过的通用修正器,借助检索机制从知识库中获取相似病例的形状先验,从而动态适应不同的分割任务。
DSC(Dice Similarity Coefficient,Dice 相似系数) 是医学图像分割中最常用的重叠度评价指标,计算为预测掩码与真实掩码交集的 2 倍除以两者像素总数之和,取值 0 到 1,越接近 1 表示重合度越高。它本质上衡量的是两个集合的匹配程度,对体积较大的结构更为敏感,对小病灶的局部错误反应相对迟钝。在修正任务中,研究者常用修正前后 DSC 的变化量(ΔDSC)来量化修正器带来的增益,因此输入 DSC 的高低直接决定了修正空间的上下限——输入越差,可提升的幅度通常越大。
GRACE 如何工作:检索增强的掩码编辑
GRACE 是一种检索增强的修正器(refiner),它在共享知识库提供的上下文下编辑输入掩码。知识库由经过验证的历史病例构成,修正器在包含紧凑器官、腔体、分支血管和肿瘤病灶的多器官语料库上训练一次。
具体而言,GRACE 在冻结的多模态编码器上添加了一个轻量的形状感知投影头,将嵌入相似度映射为掩码的形状一致性。因此,知识库能够返回与当前输入在形状上相近的病例,修正器则将这些病例作为形状先验来指导掩码编辑。这种设计让修正器无需针对新解剖结构重新训练,只需将已验证病例加入知识库即可扩展。
检索增强(retrieval augmentation) 源自自然语言处理中的 RAG 范式:模型不把全部知识固化在参数里,而是在推理时从外部知识库检索相关条目作为上下文,从而在不更新权重的情况下获得新信息。在 GRACE 中,知识库存储的是经过人工验证的历史病例及其掩码,检索依据是形状嵌入的相似度,而非文本语义。这种“冻结模型 + 可扩展索引”的组合带来一个关键性质:新增器官或新数据集时只需往库里追加病例,模型本身无需再训练,避免了灾难性遗忘,也让知识库可以持续积累临床经验。
投影头与形状一致性 是理解检索为何有效的重要环节。深度编码器输出的嵌入通常针对分割任务优化,未必保留可供相似度比较的形状信息。GRACE 在冻结编码器之上附加一个轻量投影头,用嵌入相似度去回归掩码的形状一致性,相当于把嵌入空间“校准”成形状度量空间。这样,最近邻检索返回的就是形状上真正可借鉴的病例,而不是仅在外观或纹理上相似的病例。由于编码器冻结、只训练投影头,参数量与训练成本都很低,也使多模态输入(CT、MRI、超声)能共享同一套检索结构。
实验评估:跨数据集与跨解剖结构的泛化
论文在 18 个公开数据集上评估了 GRACE,覆盖 CT、MRI 和超声三种模态,使用了 9 种修正配置和 7 个上游分割器(涵盖弱、中、强性能区间)。每个修正结果以输入掩码的 DSC 变化来衡量。
在留出数据集迁移评估中,三个留出数据集查询一个仅由训练数据构建的固定知识库。另有一项留一解剖结构实验测试无参数索引扩展:将未见过的实体器官的已验证病例加入知识库,而修正器保持冻结。
结果显示,在弱分割器上,输入 DSC 为 0.386,GRACE 最多可提升 +0.35 DSC;在强分割器上,输入 DSC 为 0.932,平均变化较小。这表明 GRACE 主要在中低质量掩码上发挥作用,对高质量输入则修正幅度有限。
留一解剖结构实验(leave-one-anatomy-out) 借鉴了机器学习中留一交叉验证的思想,但检验对象不是样本而是解剖类别:训练与建库时刻意排除某一器官,测试时再将该器官的已验证病例加入知识库、修正器保持冻结,以此考察系统能否仅靠检索就泛化到未见结构。这一设置直接对应临床中“新任务不断出现”的现实,也区分了两种泛化能力——参数层面的泛化(模型见过类似结构)与检索层面的泛化(仅靠相似先验迁移),后者正是 GRACE 主张的核心优势。
多模态与跨解剖的挑战
GRACE 在训练和索引中均未出现的成像模态上的迁移效果是部分的,且依赖于解剖结构,这仍是一个开放研究方向。例如,模型在超声上的表现可能因器官而异,说明检索增强修正的泛化能力仍有提升空间。
尽管如此,研究结果表明,检索条件化的修正(retrieval-conditioned refinement)是解剖特异性修正模型的一种实用替代方案。代码已在 GitHub 开源,便于社区复现和进一步研究。
实践意义与未来方向
GRACE 的通用性设计减少了为每个解剖结构单独训练修正器的需要,有望降低临床部署的工程负担。其无参数索引扩展特性允许在不重新训练的情况下纳入新器官的病例,为持续学习提供了新思路。
未来工作可探索如何提升跨模态迁移的鲁棒性,以及如何将检索增强修正扩展到更多临床场景。对于医学图像分析研究者而言,GRACE 展示了检索机制在分割后处理中的潜力,值得进一步关注。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。