Graphicle:用 Rust 重写 Graphify,为编程 Agent 加装记忆

Graphicle 用 Rust 重写 Graphify,为 coding agent 在代码图上叠加可检索的长期记忆。
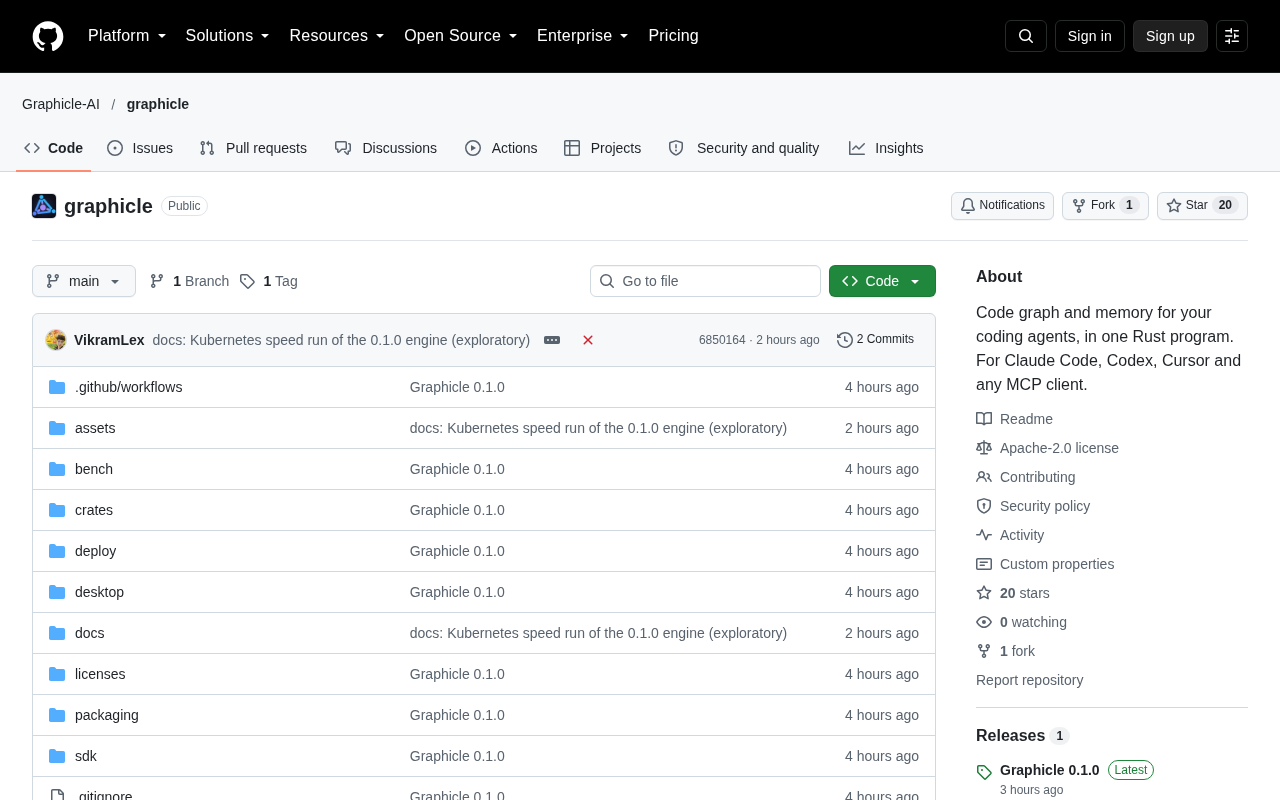
Graphicle 是 Hacker News 上受关注的新项目,定位为 Graphify 的 Rust 重写版,核心增量是为 coding agent 提供记忆能力。Graphify 把代码库组织成图结构,让文件、函数、依赖与调用链成为可查询的节点与边,是 agent“看懂代码库”的前置条件。Graphicle 选择 Rust 而非从零设计,意在继承原有图模型与查询语义,同时补齐运行时性能与分发便利性。其最受关注的设计是把记忆锚定在代码图节点上,而非扁平的文本摘要,使 agent 能检索与特定函数、依赖相关的历史决策。文章还分析了 Rust port 在跨语言互操作、并发可变图与错误处理模型上的实际取舍,并指出代码图工具的首要用户正从人类转向 AI agent,评价标准也随之迁移。
在 Hacker News 的 Show HN 版块,一个名为 Graphicle 的新项目引起了不少开发者关注。它的定位很直接:用 Rust 重写 Graphify,并在此基础上为 coding agent 增加一层「记忆」能力。
为什么是 Graphify,又为什么是 Rust
Graphify 这类工具的初衷,是把代码库以图结构的方式组织起来——文件、函数、依赖关系、调用链都成为可被查询的节点与边。对于人类开发者,这是理解大型项目的辅助手段;对于 coding agent,这几乎是「看懂代码库」的前置条件。
Rust 在此处并非为了追逐语言潮流。图结构的构建、遍历和增量更新,天然是高并发、重内存管理的场景。Rust 在内存布局与所有权上的约束,让这类工具能在保持较低资源占用的同时,获得接近系统级的执行效率。对于一个需要被反复调用的 agent 后端组件来说,启动速度和常驻开销往往比绝对峰值性能更关键。
Graphicle 选择做 Rust port 而非从零设计,意味着它试图继承 Graphify 已建立的图模型与查询语义,同时把运行时性能与分发便利性补齐。
代码图(Code Graph) 是理解本文的基础概念。传统代码检索依赖文本匹配或正则,只能回答“哪里出现了某个字符串”;代码图则把代码库抽象为带类型的节点(文件、类、函数、变量)和带语义的边(导入、调用、继承、引用)。这种结构让查询从“找文本”升级为“找关系”——例如“哪些函数间接调用了这个被废弃的 API”“改动这个接口会影响哪些下游模块”。代码图通常由静态分析或语言服务器协议(LSP)在索引阶段构建,可持久化为图数据库或内存中的邻接结构。对 coding agent 而言,代码图相当于一张可程序化查询的“代码地图”,使其无需把整个仓库塞进上下文,就能定位相关代码片段。Graphify 正是这一思路的早期实践者,Graphicle 则在此模型上做语言与能力的延伸。
「记忆」对 coding agent 意味着什么
这是 Graphicle 相比普通代码图工具更有意思的部分。当下多数 coding agent 的上下文窗口有限,长会话或跨任务时,早期的关键结论会被挤出上下文——它「做过」某件事,却不「记得」为什么这么做。
把记忆挂在代码图上是个务实的选择。记忆的载体不再是扁平的自然语言摘要,而是锚定在具体节点上:某个函数为什么被重构、某个依赖为什么被替换、某段逻辑的已知坑点是什么。当 agent 再次触及同一区域时,检索的是与该节点关联的历史决策,而不是模糊的全库语义搜索。
这种设计的隐含前提是:代码的语义不只是当下的文本,还包括它被修改的历史与理由。图结构天然适合承载这种带位置的信息。
上下文窗口(Context Window) 指模型单次推理能容纳的 token 上限,它是理解 agent“失忆”问题的关键。主流模型窗口从数万到数十万 token 不等,但即便窗口很大,长会话中早期信息仍会因“中间遗忘”(lost in the middle)现象而难以被有效利用,且 token 成本随长度线性上升。因此 agent 工程普遍采用外部记忆方案:把历史决策、任务状态、观察结果写入向量库、键值存储或结构化数据库,需要时按相关性检索回上下文。这类方案通常称为 RAG(检索增强生成)。Graphicle 的差异化在于,检索单元不是自由文本块,而是代码图上的节点,使记忆与代码位置强绑定,避免了纯语义检索“找得到相似文本却对不上具体函数”的错配问题。
Rust port 的实际取舍
跨语言重写很少是纯粹的翻译。Graphify 原有实现中的动态类型便利、库生态依赖,在 Rust 里都需要重新落位。常见的取舍包括:
- 序列化与互操作:agent 生态多以 Python、TypeScript 为主,Rust 侧通常需要暴露 C ABI、WASM 或本地 RPC 接口,这会带来一层不可忽视的集成成本。
- 增量索引:Rust 的所有权模型让「共享可变图」变复杂,常见的解法是引入专门的并发数据结构或采用阶段式重建,性能与实现复杂度需要权衡。
- 错误处理哲学:从异常式转向 Result 式,会改变上层调用方对失败路径的处理方式,对 agent 场景而言反而更利于显式地处理「索引不完整」这类状态。
这些细节决定了 Graphicle 是「更快但更难接」还是「更快且更稳」,也是社区最可能在评论区追问的点。
C ABI、WASM 与本地 RPC 是把 Rust 组件接入 Python/TypeScript agent 生态的三条常见路径,各有代价。C ABI 通过 #[no_mangle] extern "C" 暴露函数,配合 ctypes、cffi 或 Node 的 FFI 调用,性能接近原生,但需手工管理内存与错误码,跨语言类型映射易出错。WASM 把 Rust 编译为可移植字节码,在浏览器与 Node 中沙箱运行,安全性好、分发简单,但受限于线性内存模型,难以直接操作文件系统,I/O 密集的索引任务需通过宿主接口绕行。本地 RPC(如 gRPC、JSON-RPC over Unix socket)把 Rust 进程做成常驻服务,语言无关、易调试,代价是序列化开销与进程间通信延迟。对需要反复调用的 agent 后端,常驻服务 + 轻量协议往往是均衡之选。
这类工具正在被重新定位
代码图工具过去被视为 IDE 插件或静态分析器,服务对象是人。Graphicle 的出现延续了一个明显趋势:这类基础设施的「第一用户」正在变成 AI agent。这带来评价标准的迁移——
人类在意的是可视化是否清晰、跳转是否顺手;agent 在意的是查询延迟、结果确定性和能否被程序化调用。一个面向 agent 的图后端,其 API 设计、去重策略和记忆淘汰机制,重要性不亚于图本身的准确度。
如果 Graphicle 能把「图 + 记忆」稳定地做成一个低开销的常驻服务,它填补的就不只是一个语言移植的空缺,而是 coding agent 长期记忆这一相对薄弱环节的一块拼图。当然,这一判断成立与否,仍取决于它能否在真实的 agent 循环中证明记忆检索确实提升了任务成功率,而不只是增加了上下文长度。
记忆淘汰机制(Memory Eviction) 是长期记忆系统能否稳定运行的关键设计。记忆不可能无限增长,必须决定何时写入、何时遗忘。常见策略包括:基于时间的 TTL 过期、基于访问频率的 LRU 淘汰、基于重要性的打分(如是否导致任务成功)、以及基于冲突检测的合并或覆盖。在代码图场景下,淘汰还需考虑代码演进——当某个函数被删除或重写,锚定其上的历史决策是否仍有效,是保留为“考古记录”还是标记失效。策略选择直接影响检索信噪比:过于激进会丢失关键决策,过于保守则让噪声淹没信号。面向 agent 的记忆系统,其淘汰逻辑往往比图本身的构建算法更能决定实际体验。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。