Grok 4.6发布:xAI收购Cursor后AI竞赛进入三足鼎立时代

三足鼎立:AI竞赛迎来第三极
在过去两年里,行业普遍认为AI大模型领域只有两个主导玩家——OpenAI和Anthropic。OpenAI成立于2015年,最初作为非营利研究机构运营,2019年转型为"有限盈利"公司后开始商业化运作。GPT-3(2020年)的发布标志着大语言模型从学术研究走向商业应用的转折点,而2022年底ChatGPT的推出则引爆了全球AI热潮,凭借GPT系列模型开创了大语言模型的商业化先河。Anthropic由前OpenAI核心成员(包括Dario Amodei和Daniela Amodei)于2021年出走创办,其核心理念是"负责任的AI开发",提出了Constitutional AI(宪法AI)等安全对齐方法论,以安全导向的Claude系列模型迅速崛起。两家公司在技术路线上形成鲜明对比:OpenAI追求能力边界的快速扩展,Anthropic则强调安全与能力的平衡发展,两者长期形成双寡头格局。但仅仅在几天之内,一个新的强力竞争者浮出水面,值得所有人认真对待。据科技博主Matthew Berman的分析,Grok(xAI旗下模型)曾经高调入场,却很快沉寂,长期没有太多动作。xAI是马斯克于2023年创立的AI公司,初期主要服务于X平台(原Twitter),其Grok模型虽早早发布但在通用能力上一直未能跻身第一梯队。而如今这一切彻底改变了。
转折点在于xAI收购了Cursor这家公司,从而补齐了它成为主导玩家所缺失的关键拼图。Cursor是一款基于VS Code架构的AI原生集成开发环境(IDE),由Anysphere公司开发。VS Code是微软开发的开源代码编辑器,基于Electron框架构建,凭借其轻量化设计和丰富的插件生态系统,已成为全球市场占有率最高的代码编辑器(据Stack Overflow调查超过70%的开发者使用)。Cursor在VS Code的开源内核基础上重新构建了编辑器架构,将AI能力从"插件附加"提升为"系统原生"——这意味着AI不仅能补全当前行代码,还能理解整个项目的代码库结构、跨文件依赖关系,并执行涉及多个文件的复杂重构操作。这种架构级的差异使Cursor能提供GitHub Copilot等插件方案无法实现的深层能力。它率先将大语言模型深度嵌入编程工作流,支持代码补全、多文件编辑、自然语言指令执行等功能,迅速积累了大量开发者用户。就在近日,xAI正式发布了最新模型Grok 4.6——一款在多个维度上都相当独特的模型。
值得说明的是,Grok 4.6并非全新训练的模型,而是在Grok 4.5基础上的一次".x"迭代升级。但它相比前代实现了巨大的进步,尤其在编程和知识工作方面的能力持续增强,而这正是xAI当前的核心战略焦点。
Grok 4.6基准测试:全面提升,性价比突出
从基准测试来看,Grok 4.6的表现相当亮眼。早期AI模型评测主要依赖HumanEval、MMLU等学术基准,但这些测试往往存在"教考分离"不足的问题——模型可能在训练中已接触过类似题目。近年来行业转向更贴近真实场景的评测方法,强调端到端任务完成能力,而非孤立的知识问答。
前代Grok 4.5已经在Cursor中成为默认的子智能体(sub agent)模型,以能力强、速度快著称。所谓子智能体,是指在AI编程工具的多步骤任务执行中,负责完成具体子任务的底层模型——比如当主智能体将一个复杂需求拆解为多个文件修改时,子智能体负责逐一执行。而4.6在此基础上几乎全面提升,速度甚至更快。

具体来看:
- GDP Val(OpenAI推出的衡量真实知识工作任务效能的基准):Grok 4.6 high取得第一名,超越了竞品。GDP Val测试覆盖了写作、分析、总结等典型知识工作者的日常任务,被认为比传统学术基准更能反映模型的实用价值。
- Cursor Bench:意外没有拿到第一,但基本与Fable 5 Max持平。这一基准专门衡量模型在IDE环境中完成代码编辑任务的能力。
- DeepSuite(许多人认为最贴近真实编程体验的基准):Grok 4.6得分65.9,排名第三,落后于GPT 5.6 Sol Max(73分)和Fable 5(70分)。DeepSuite之所以受到开发者信赖,是因为它使用真实的开源项目issue作为测试用例,从GitHub上抽取问题并验证模型能否成功提交通过CI/CD的代码修改,而非人工构造的编程题。
- Terminal Bench:从前代的15%跃升至26%。这一基准测试模型在终端环境中完成系统管理和DevOps任务的能力,模拟系统管理员日常遇到的服务器配置和故障排除场景。
- Harvey Lab(法律场景):以15.8%的成绩压倒性领先。Harvey是一家专注于法律AI的公司,其基准测试衡量模型处理合同审查、法律研究等专业任务的能力。
每任务成本才是关键指标
Matthew Berman特别强调,仅看质量分数是不够的,成本同样重要。Token是大语言模型处理文本的基本单位,英文中大约每个单词对应1-2个token,中文中每个字约对应1-2个token。模型API通常按输入和输出的token数量分别计费,但"每任务成本"更具实际参考意义,因为不同模型完成同一任务所消耗的token总量差异巨大。
推理型模型(reasoning models)是2024年以来大模型领域最重要的技术突破之一。以OpenAI的o1系列为代表,这类模型在生成最终答案前会进行大量"内部思考"——将复杂问题分解为多个推理步骤逐一解决。这种思维链(Chain-of-Thought)机制显著提升了模型在数学、编程和逻辑推理等任务上的表现,但代价是产生大量"思考token",这些token虽然用户不一定看到,却需要付费。一个推理型模型完成任务可能消耗普通模型10-50倍的token,因此"每任务成本"比"每token价格"更能反映真实使用开销。
在Artificial Analysis(一家独立AI模型评测机构)的智能指数榜单上,Grok 4.6 high从4.5的位置一跃升至第四名,与GPT 5.6 Sol并列,仅次于Claude Opus 5、Fable 5和GPT 5.6 Sol。
但更值得关注的是「每任务成本」这一维度。它取决于两个因素:模型消耗多少token,以及每个token的价格。Grok 4.5 high的每任务成本约为0.36美元,智能指数约0.55;而Grok 4.6虽然智能指数提升至0.60,但成本也上升到约0.83美元。尽管变贵了,但相比智能水平相当的GPT 5.6 Sol Max,Grok 4.6依然更便宜。这意味着对于需要大规模调用API的企业用户而言,Grok 4.6在性能与成本之间提供了更优的平衡点。
实测对比:Grok 4.6设计能力仍有差距
Berman用同一个提示词让三个顶级模型生成一张设计感强的单一资料卡片。结果颇具戏剧性:
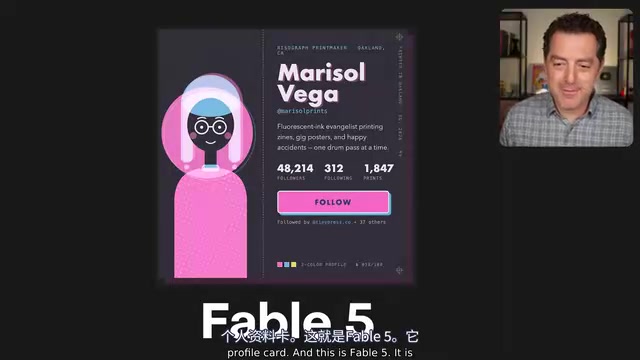
- Fable 5:表现糟糕,生成的图像被形容为「最差劲的SVG画图软件作品」
- GPT 5.6 Sol:生成了精美的人物图像,设计干净、视觉吸引力强,明显胜出
- Grok 4.6:不错但不算出色,虽然也生成了人物图像,但存在关注按钮被裁切、底部无留白、文字间距怪异等问题
尽管设计类基准主观性很强,但从实测看,GPT 5.6在这一环节明显领先,而Grok 4.6处于中游水平。值得注意的是,前端设计和UI生成能力正成为AI模型的新竞争维度,因为越来越多的非设计师用户希望通过自然语言直接获得可用的界面原型。这一趋势背后是"设计民主化"的更大浪潮——当AI能够将自然语言描述转化为像素级精确的界面设计时,专业设计工具和设计师的角色将面临根本性重塑。
Grok 4.6价格与可用性:定位主力工作模型
Grok 4.6现已上线,可通过Cursor、Grok build、API以及OpenRouter、Vercel、Cloudflare等渠道使用。OpenRouter是一个AI模型聚合平台,允许开发者通过统一接口调用多家厂商的模型;Vercel和Cloudflare则是主流的云服务和边缘计算平台,它们的接入意味着开发者可以在现有技术栈中无缝使用Grok。
定价方面,输入每百万token为2美元、输出每百万token为6美元——相当有竞争力。作为对比,GPT 5.6 Sol的价格是其数倍,Fable更贵。因此Grok被Berman定位为「主力工作模型」(workhorse model),即那些不需要追求极致性能、但需要在日常大量任务中保持高性价比的使用场景。此外还有一个价格翻倍但速度更快的Fast变体,而Grok build和Cursor用户在首周还能享受双倍使用额度。
xAI收购Cursor:数据与算力的完美结合
要理解xAI今天的强势地位,必须回顾这场收购的来龙去脉。今年4月,xAI收购了Cursor。Cursor是最早将AI深度集成到IDE中、开创全新AI编程方式的公司。与GitHub Copilot的插件模式不同,Cursor从底层重构了IDE体验,让AI参与到代码理解、跨文件修改、项目级重构等深层任务中。但在Claude Code和Codex相继推出后,Cursor一度落后,开发者纷纷转向其他产品。Claude Code是Anthropic推出的命令行AI编程工具,Codex则是OpenAI的对标产品,两者凭借更强的底层模型能力对Cursor形成了竞争压力。
这场收购之所以关键,在于双方形成了完美互补:Cursor手握海量、极具价值的编程数据,却没有数据中心和GPU来训练自己的模型;而xAI在122天内建成了包含20万块GPU的数据中心(位于孟菲斯)。这一速度在业界极为罕见——20万块GPU(主要为NVIDIA H100)的集群规模意味着数十亿美元的硬件投入,加上电力供应(预计峰值功耗超过100兆瓦)、冷却系统和网络互联等基础设施成本。作为对比,Meta的同等规模集群建设周期约为18个月。马斯克团队采用了预制模块化数据中心方案和并行施工策略来压缩工期,这种"速度即壁垒"的思维与SpaceX的快速迭代文化一脉相承。然而xAI虽有惊人算力,却缺乏一个受欢迎的好模型,导致大量GPU闲置。当数据与算力合并,就诞生了Grok 4.5乃至4.6这样强大的编程模型。
递归式自我改进:用Grok训练Grok
有意思的是,xAI在博客中明确表示,他们使用Grok 4.5来训练Grok 4.6——用前代模型重新生成SFT(Supervised Fine-Tuning,监督微调)训练轨迹,覆盖推理、智能体框架,以及STEM、软件工程、知识工作等领域。SFT是将预训练模型调整为能够遵循指令、产出高质量回答的关键步骤,训练轨迹指的是模型完成复杂任务时的完整推理和执行过程记录,包括中间步骤、工具调用和最终输出。
用前代模型生成下一代的训练数据,本质上是一种合成数据(synthetic data)策略——让强模型扮演"教师"角色,产出大量高质量样本供新模型学习。这一技术路线已在业界广泛采用:Meta的Llama系列使用GPT-4生成的数据进行微调,微软的Phi系列小模型几乎完全依赖合成数据训练。虽然还称不上完全闭环的自我改进AI(即模型完全自主地发现并修正自身不足),但当前各大实验室的模型确实都在训练下一代模型,Grok也不例外。
这种方法的风险在于可能导致"模型坍缩"(model collapse)——2024年《Nature》上的一篇论文严肃警告了这一现象:如果训练数据中合成内容比例过高,模型可能逐渐丧失对真实数据分布尾部的覆盖能力,合成数据中的偏差被逐代放大,输出趋于同质化。但目前来看各实验室通过混合真实数据、使用多样化的教师模型、精心设计覆盖边缘案例的课程学习策略等方法有效缓解了这一问题。
Grokbot:面向大众的AI编程智能体
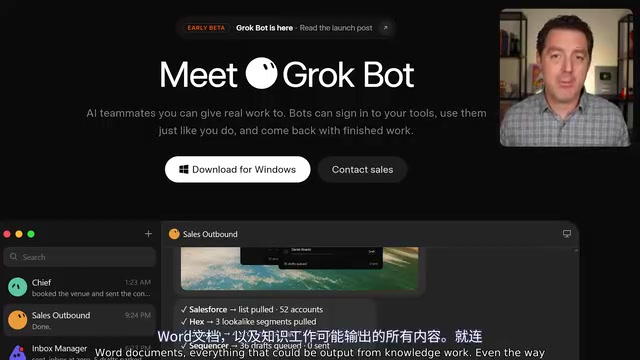
Grok 4.6还驱动着Cursor最新推出的产品Grokbot。与面向开发者的Cursor不同,Grokbot明确面向更广泛、技术门槛更低的用户群体。它剥离了模型选择功能,用户甚至无法知道自己在用哪个模型,也不显示任何代码,只展示文本和PPT、Word文档等产出物。
这一产品策略与此前的趋势形成鲜明对比——过去一年里,AI编程工具主要在争夺开发者用户,而Grokbot试图将AI编程的能力"包装"成对非技术用户透明的服务。界面上,每个对话线程都是一个智能体,每个智能体都有专属的小吉祥物形象。这种「强大却极其简单易用」的设计理念,体现了xAI转向更广阔市场的战略意图——毕竟整个知识工作市场本质上都是建立在代码之上的。从自动化报告生成到数据分析可视化,从流程自动化到文档处理,几乎所有知识工作的数字化效率提升最终都依赖于代码执行。
AI竞争格局:Anthropic面临隐忧
一个耐人寻味的细节是:Anthropic与xAI达成了合作,正在向xAI购买算力。在当前GPU供应紧张的市场环境下,算力本身已成为稀缺战略资源。NVIDIA H100/H200芯片的需求远超供给,从下单到交付通常需要6-12个月的等待期,且大客户(Microsoft、Google、Meta等)已锁定了未来数年的产能。这种供不应求的局面使得"算力"本身成为可交易的战略资产——拥有闲置GPU的公司可以通过出租算力获得可观收入。各大AI实验室也在积极投资自研芯片(如Google TPU、Amazon Trainium)以减少对NVIDIA的依赖。
Berman形容这「就像向敌人出售武器」,考虑到马斯克此前对Anthropic的诸多负面评价,这笔交易想必让他颇为受用。
但反过来看,如果Grok 4.6持续吸引需求,那么合约到期后,xAI很可能将全部GPU产能倾斜给Cursor和Grok自身。对Anthropic而言,这是一个需要警惕的信号——它不仅面临模型能力层面的竞争,还可能在基础设施层面受制于对手。即便Anthropic融资额度巨大(已融资超过70亿美元),如果芯片到货速度跟不上模型训练需求,资金优势也无法转化为算力优势。
而且xAI的脚步并未停止。马斯克已发推透露,Grok 4.7「显著优于4.6」,预计三到四周内就绪,且将加入大量来自SpaceX等旗下公司的补充训练数据。马斯克旗下的公司矩阵——包括SpaceX(火箭工程数据、轨道力学计算)、Tesla(自动驾驶感知数据、工厂自动化数据)、Neuralink(神经科学与脑机接口数据)、The Boring Company(基础设施工程数据)等——为xAI提供了其他AI实验室难以获得的独特数据源。这些来自真实物理世界的高质量专业数据,在STEM和工程推理任务上可能为模型带来显著优势,成为其长期差异化竞争力。
结语:押注编程就是押注AI的未来
从Grok 4.6的发布可以清晰看到一个行业规律:押注编程,就是押注未来。这套「深耕编程用例—构建数据飞轮—训练下一代模型」的打法最初由Anthropic凭借Claude Code验证,随后被OpenAI通过Codex复制并追平,如今又被收购Cursor后的xAI成功套用。
所谓数据飞轮(data flywheel),是指产品使用产生数据、数据改进模型、更好的模型吸引更多用户的正向循环。在AI编程场景中,这一效应尤为显著:开发者使用工具编写代码时,其接受或拒绝AI建议的行为、代码修改记录、项目上下文等都构成了极高价值的训练信号,远比公开代码仓库更具针对性。这些信号本质上是人类专家对模型输出质量的实时标注——每一次接受建议等同于正样本,每一次拒绝或修改等同于负样本,这种RLHF(基于人类反馈的强化学习)信号在规模化后极为宝贵。谁能率先建立起这个飞轮,谁就能在编程AI赛道上获得自我强化的领先优势。
AI竞赛正式进入三足鼎立时代。虽然xAI在综合实力上仍处于第三,但它加速的势头不容小觑。对用户而言,更激烈的竞争意味着更好、更便宜的模型,这无疑是件好事。
核心要点
核心要点
相关推荐

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。