Grok 4.7 名不副实?基准测试与Token效率遭质疑
Grok 4.7被马斯克高调预告将超越所有模型,但实测基准得分下滑且token成本近乎翻倍。
马斯克在Grok 4.7发布前大力宣传其将「超越所有现有模型」,并声称新版本拥有更好的Token效率。然而独立实测数据显示,Grok 4.7在多项基准测试中得分反低于前代Grok 4.6,而每任务Token消耗更从38k飙升至81k,成本接近翻倍,甚至超过Fable 5.1等竞品。这一案例揭示了AI模型发布中营销话术与客观性能之间的普遍落差,提醒用户和开发者在评估新模型时,应以独立基准测试得分、真实Token消耗成本和响应速度为核心参考,而非依赖官方宣传或版本号递增带来的心理预期。
Grok 4.7 的高预期与现实落差
马斯克(Elon Musk)为 Grok 4.7 的发布造势已超过一个月。早在 Grok 4.5 推出时,他就放话称 4.7 将是「重磅版本」,性能会「超越当前所有模型」。这种高调预告,为后续的实测结果埋下了对比的伏笔。
然而据 YouTube 频道的实测分析,Grok 4.7 在多项基准测试中的得分反而低于前代 Grok 4.6,这与官方宣传形成了鲜明反差。当一款被寄予厚望的模型在客观跑分上不进反退时,此前的高预期就显得颇为尴尬。
宣传口径与实测结果的矛盾
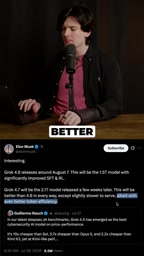
官方对 Grok 4.7 的定位是「在各方面都优于 Grok 4.6」,唯一的代价是「服务速度略慢」,但号称拥有「更好的 Token 效率」。这套说辞听上去是一次全面升级——更强、更省。
但实测数据推翻了「更好 Token 效率」这一核心卖点。视频作者直指这是一个「谎言」(lie),因为真实的资源消耗情况与宣传完全相反。
Token 效率的真相:成本翻倍
宣传与现实最大的裂缝出现在 Token 消耗上。所谓「Token 效率更好」,本应意味着完成同样任务消耗更少的 Token、成本更低。但实测数据讲述了一个相反的故事。
据该频道给出的数据:Grok 4.6 x high 在每个任务上大约消耗 38k tokens,而 Grok 4.7 则飙升至 81k tokens——这是接近 2 倍的增长。换句话说,完成相同任务的成本几乎翻倍,与「更好效率」的说法背道而驰。
与其他模型的横向对比
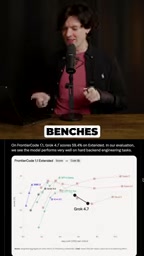
更值得关注的是横向对比。视频指出,Grok 4.7 的 81k tokens 消耗甚至超过了 Fable 5.1 这类模型,在成本维度上处于劣势。
对于依赖 API 计费的开发者和企业用户而言,Token 消耗直接等同于真金白银的支出。一个模型如果在跑分上没有明显优势,却在成本上翻倍,那么它在实际生产环境中的性价比就要打上一个大大的问号。
Token(令牌)是大语言模型处理文本的基本计量单位。模型并不直接读取字符,而是将输入和输出文本切分为若干 token——大致上,英文约每 4 个字符对应 1 个 token,中文通常每个汉字对应 1–2 个 token。API 计费通常以「每百万 token」为单位定价,因此 token 消耗量直接决定调用成本。所谓「Token 效率」,衡量的是模型在完成相同质量任务时所消耗 token 的多少:消耗越少,效率越高、成本越低。对于需要大规模批量调用的开发者和企业而言,token 效率往往比模型跑分排名更具实际意义——一个稍逊于顶尖模型但 token 消耗减半的方案,在生产环境中的综合价值可能反而更高。
如何看待模型发布的营销话术
这次围绕 Grok 4.7 的争议,折射出当下 AI 模型发布中一个普遍现象:营销预期与客观基准之间的落差。厂商往往在发布前用「超越所有模型」这类绝对化措辞拉高期待,而真正决定模型价值的,是可复现的基准跑分和实际使用成本。
对于普通用户和开发者来说,评估一款新模型时不应只看官方宣传,而要关注三类硬指标:一是独立基准测试的得分,二是每任务的 Token 消耗(即真实成本),三是响应速度。Grok 4.7 的案例恰好说明——「新版本」不等于「更好版本」,版本号的递增并不必然带来实用价值的提升。
需要说明的是,本文数据来自单一 YouTube 来源的实测,具体基准项目和测试环境的细节有限。在做出最终判断前,建议交叉参考更多独立评测,以获得更全面的结论。
基准测试(Benchmark)是评估 AI 模型能力的标准化测试集,常见的包括 MMLU(多学科知识推理)、HumanEval(代码生成)、MATH(数学推理)等。这些测试由学术界或第三方机构设计,旨在提供可跨模型横向对比的客观指标。然而,基准测试本身也存在局限:模型厂商可能针对特定基准进行优化(即「刷榜」),导致跑分亮眼但实际任务表现平平;不同测试环境、提示词设计也会影响结果。因此,业界通常建议同时参考多个独立机构的评测,以及真实业务场景下的 A/B 测试,才能对一款模型的实用价值形成较为可靠的判断。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。