Grok 4.7 vs MiMo V2.6 Pro/Flash 三模型实测对比
实测对比Grok 4.7与MiMo V2.6系列,性价比和任务适配性比榜单分数更重要。
本文记录了UP主KatenGlock对Grok 4.7、MiMo V2.6 Pro与V2.6 Flash三款模型的横向实测。三者在Artificial Analysis榜单上的综合分数相近,但实际表现分歧明显。Grok 4.7因Token消耗大、推理过程冗长而体验低于预期,在3D折纸等推理密集型任务上有优势,但多数场景甚至不及上一代4.6。MiMo V2.6最大的意外来自Flash版本——这款参数更小、速度更快、价格更低的轻量模型,在3D建模、游戏关卡、抓娃娃建模等多项任务上意外强于旗舰级的Pro版本,只有写作任务中Pro以更具文学质感的表达胜出。测评结论指向一个核心判断:榜单分数与实际手感存在结构性差距,具体场景下的任务适配性与性价比才是选型的真正依据。
三款新模型同台竞技
Grok 4.7 与小米 MiMo V2.6 系列近期陆续发布,B站UP主 KatenGlock 用一组高难度实测任务对三款模型进行了横向对比。从 Artificial Analysis 榜单来看,Grok 4.7 得分为 46,与 MiMo V2.6 Pro 持平,但两者在实际体验中的差异远比一个分数所能概括的复杂。
Grok 4.7 提供多档推理强度,官方定价与上一代 4.6 保持一致。不过它有个较为明显的短板:单个任务需要消耗的 Token 数量非常庞大。测试中UP主在 Grok Build 里选择了 X-High 推理强度并开启 Fast 模式,虽然吞吐速度不慢,但思考过程冗长,整体完成任务偏慢。UP主坦言,很多任务他宁可退回到 Grok 4.6 High 来处理。
MiMo V2.6 分为 Pro 与 Flash 两个版本。Pro 总参数 1.02T、激活 42B;Flash 总参数 310B、激活 15B,速度比 Pro 快了接近一倍。小米还提供了超速模式,并开放了 MiMo 桌面端。值得关注的是,V2.6 Pro 的 AA 得分与 Grok 4.7 一致,但价格便宜非常多,性价比优势突出。
Artificial Analysis(简称 AA)是一个专注于 AI 模型基准测试与性能追踪的第三方评测平台,通过综合智能指数(Intelligence Index)对模型在推理、编程、数学、语言理解等多个维度进行加权评分。该分数并非单一任务的成绩,而是跨多个标准化基准测试的聚合结果,因此相同分数的模型在具体任务上仍可能表现截然不同。值得注意的是,AA 榜单测试的是模型在受控环境下的"峰值能力",而实际使用中的 Token 消耗速度、推理延迟、上下文窗口利用率等因素同样影响用户体验,却不在评分范围之内。这也是为何本次测评中 Grok 4.7 与 MiMo V2.6 Pro 同分,实际体验却差异明显的原因之一。
MiMo V2.6 Pro 采用的是混合专家架构(Mixture of Experts,MoE)。MoE 模型拥有庞大的总参数量,但每次推理时只激活其中一小部分"专家"子网络,从而在保持较高模型容量的同时大幅降低单次计算成本。V2.6 Pro 总参数 1.02T 但激活仅 42B,意味着实际运算量相当于一个 42B 的稠密模型,这也是其能在成本上远低于同等能力稠密模型的核心原因。Flash 版本同样是 MoE 架构,激活参数仅 15B,速度因此提升近一倍。理解这一架构有助于解释为何 Flash 在某些任务上能以更低延迟实现接近甚至超越 Pro 的效果——激活参数更少意味着推理更快,而路由机制是否能为特定任务选中最合适的专家,才是决定质量差异的关键变量。
3D 建模:清明上河图与机械蝴蝶
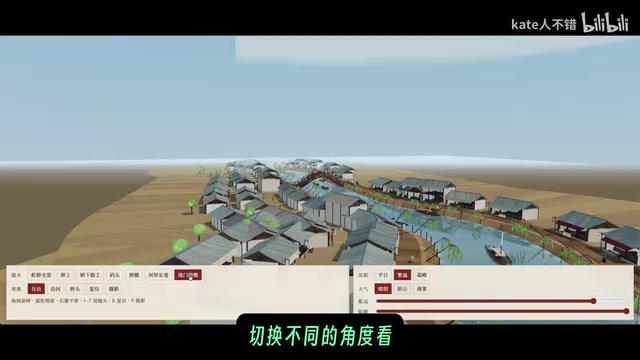
第一组任务是生成《清明上河图》场景。Grok 4.7 生成的画面房屋偏少,船只有穿模现象,岸边柳树、右侧招牌尚可,拱桥造型还行,但整体一眼就能看出精度不足,UP主评价为“表现一般,未达预期”。
有意思的是,V2.6 Flash 在这个任务上反而给出了不错的效果,房屋密度更高、桥面制作出色,尽管遮阳棚过于现代化、人物行走方向和穿模存在问题,但考虑到它的参数规模,表现可圈可点。而 V2.6 Pro 的结果令人意外——桥面很一般、商铺稀少、屋顶平坦,反而不如同门的 Flash。UP主推测模型搭配自家工具链本应表现更好,Pro 的失常确实反常。
在“机械蝴蝶”任务中,参照组 Extra 表现最佳,Grok 4.7 生成的质感非常不错,V2.6 Flash 造型可以但齿轮转动不符合物理,而 V2.6 Pro 再次表现平平。
游戏与交互任务:穿模也是一种趣味
“快乐向前冲”闯关任务里,Grok 4.7 展现出大量类似真人的滑稽动作,虽然穿模频繁,但关卡设计五彩斑斓、观赏性强,UP主认为这种“像 bug 却很有趣”的效果反而好玩。
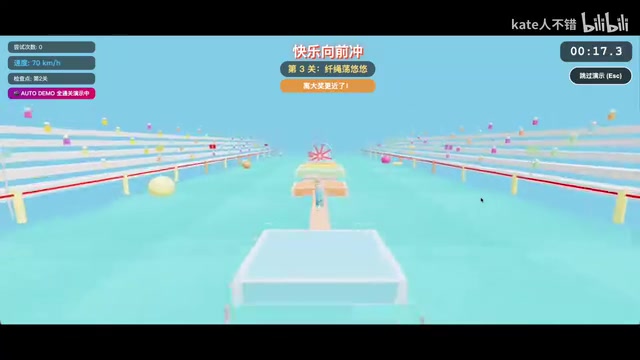
V2.6 Flash 的关卡更简洁,但没能满足提示词中“一次性通关”的要求,多次落水失败。V2.6 Pro 的人物跑得飞快,但道具缺失严重、关卡衔接断裂,同样未能完整通关。
在“抓娃娃 Blender 建模”任务中,模型需要从零建模并实现投币、移动、抓取、落动等操作。Grok 4.7 表现尚可,V2.6 Flash 依旧优于 V2.6 Pro,这一结果继续印证了 Flash 在部分任务上强于 Pro 的反常现象。
Web 页面与还原任务
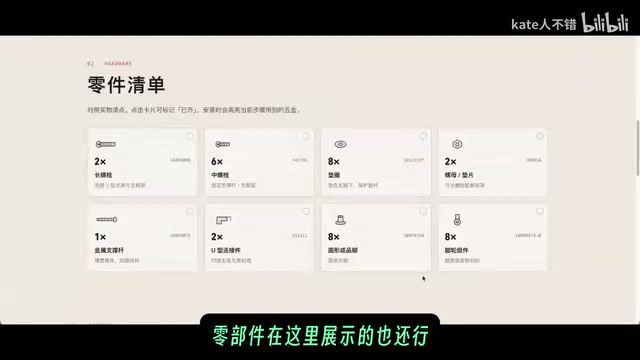
三款模型还被要求根据宜家安装指南 PDF 生成一个 Web 页面。Grok 4.7 一次提示即生成,安装动画约 60% 得以呈现,下方还列出了五金件清单。V2.6 Pro 页面初看清爽,但右侧沙发预览图错误明显,动画反而让用户更迷糊,且需要提示两次才补全部件。
在“还原机械腕表”任务中,三款模型都表现平平:Grok 4.7 表盘与原图差距过大;V2.6 Flash 表盘不错但表带缺失;V2.6 Pro 表盘干净但内部机械结构位置完全错误。这类高精度还原任务对当前模型仍是难点。
3D 折纸与写作能力
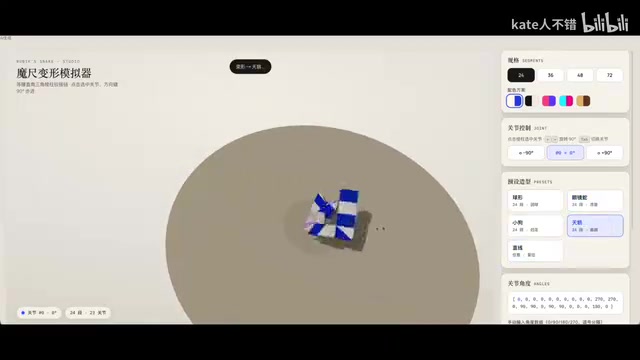
3D 折纸任务对模型的算法与推理能力要求很高。Grok 4.7 生成的眼镜蛇、小狗、双球、骆驼等造型辨识度较高,其中骆驼翻转后相当传神。相比之下,V2.6 Pro 生成的球形、眼镜蛇、天鹅辨识度都偏低。这个任务上 Grok 4.7 明显占优。
最后是写作测试,提示词要求以第一人称内心独白,把医院、房东、亲人三条消息编织进同一个下午,输出 500 字故事。Grok 4.7 的版本 UP主认为不如 DeepSeek广告 系列;V2.6 Flash 的表述略显生硬;反倒是 V2.6 Pro 写得最出色,“四个字干净得近乎残忍”“三件事像三种天气叠进同一片云”等句子颇具文学质感,超过了 Grok 4.7 与 Flash。
总结:性价比是 MiMo 的杀手锏
综合来看,UP主对 Grok 4.7 的整体体验偏矛盾——期待已久却因 Token 消耗大、速度慢而未达预期,多数任务甚至不如 Grok 4.6。Grok 4.7 在专业知识、办公工作、电气工程等领域有优势,3D 折纸这类推理任务表现也更好。
MiMo 这边最大的意外是 Flash 在多个任务上强于 Pro,而 Flash 本身价格低、速度快,性价比极高。对预算敏感、追求响应速度的用户来说,MiMo V2.6 Flash 是一个值得认真考虑的选项。模型的实际表现与榜单分数并不总是一致,具体任务下的手感差异,才是选型时更该看重的维度。
Flash 在多个任务上强于 Pro 的"反常"现象,在 MoE 模型中并不罕见。较小的激活参数规模有时反而能带来更集中的专家路由,避免大模型在简单任务上的"过度思考"或注意力分散。此外,训练数据配比、指令微调策略以及小米为 Flash 针对特定任务场景做的专项优化,都可能是 Flash 表现超预期的原因。这一现象提醒用户:在 MoE 架构普及的当下,"参数更多=效果更好"的直觉判断需要谨慎,针对目标任务的实际测试仍是选型的最可靠依据。
相关推荐
StrictlyVC登陆TechCrunch Disrupt:AI如何重塑风投规则
StrictlyVC将亮相TechCrunch Disrupt 2026大会,深入探讨AI如何改变风险投资规则。了解AI时代VC估值逻辑的变化、投资人通行证优惠及会议核心看点。
YouTube上新创作者工具:视频A/B测试、动态缩略图与实时配音
YouTube为创作者推出视频A/B测试、动态缩略图和实时配音等新工具,这些功能均依托生成式AI帮助创作者优化视频表现、提升点击率并覆盖多语言观众。
YouTube推出Short Series:让Shorts走向剧集化观看
YouTube在Made On YouTube活动上推出全新Shorts Series功能,允许创作者将短视频按电视剧的季与集结构组织,带来剧集化追更体验,正面回应微短剧应用的走红趋势。