GrokBot之父:月合千个PR,智能体自动合并的工程心法
SpaceX背景工程师分享如何通过验证技能、EVAL和硬约束建立对智能体的信任,实现自动合并PR。
一位SpaceX背景的AI工程师分享了其五个月内提交约1000个PR的工作流,核心在于围绕“信任”构建工程体系。他提出工程师应转型为“智能体的工程经理”,重点设计环境、制定约束并验证结果。验证技能让智能体能真正运行应用、抓取跟踪、操作模拟器,形成闭环;EVAL作为技能的单元测试,配合多模型交叉评审持续优化。云端代理和Dune架构将约束硬编码进CI,如禁用useEffect和注释、导入检查等,确保智能体走“最短路径即正确路径”。他强调硬约束优于软规则,Token投入应视为投资回报,最终赋能非工程角色直接交付功能。
一位SpaceX背景的AI工程师在分享中抛出一组令人咋舌的数字:上个月提交并合入约1000个PR,而当月才到12号,已合入近800个。更关键的是,他醒来发现约20个PR已被智能体自动合并进主分支,且质量不错。这套工作流的背后,不是某个神秘工具,而是一套围绕「信任」构建的工程体系。
从「环路内」到「信任曲线」:工程师角色的迁移
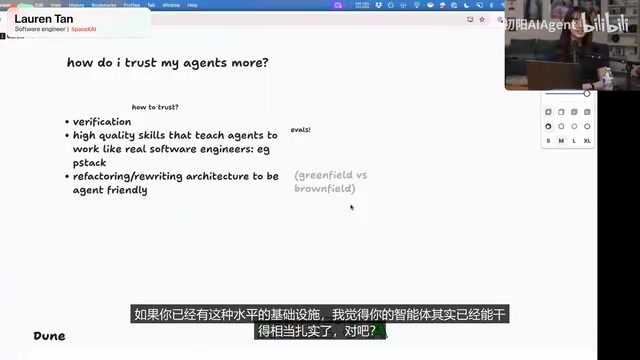
分享者用一张手绘图描述自己五个月来的变化:早期他深度介入,盯着一两个智能体的每一个输出,不停写提示词,无法并行。原因很直接——如果连一个智能体的输出都不信,就不可能扩展到一百个。这被归结为管理上的类比:不信任团队成员的工程经理,只能微观管理,花大量时间检查每一处细节。
随着信任提升,他逐渐让智能体承担更多职责,直到自动合并PR。有意思的是,Cursor合入贡献量的曲线与信任曲线大致呈反向关系——信任越高,亲自介入越少。他将自己定位为「智能体的工程经理」,核心职责从写代码转向设计环境、制定约束、验证结果。
验证技能:让智能体真正「跑起来」
整套方法论中被他称为最重要的技能是验证。所谓验证,指智能体能够真正运行代码、抓取CPU跟踪记录、打开iOS模拟器,或通过Chrome开发者工具协议控制应用——应用以什么方式呈现给用户,智能体就能以同样方式操作。这不能保证写出好代码,但至少能让它写出正确的代码,是建立信任的关键一步。
他分享了一个早期案例:加入Cursor第一周就被拉去帮忙做Agent Window,截止日期极紧,而代码库完全陌生。当时他只能自己打开性能面板抓跟踪记录、看火焰图,再把截图发给智能体,智能体自信地指认问题所在,实际却南辕北辙。那段时间他就是瓶颈,无法并行。后来构建的Control Glass技能让智能体可以程序化地运行应用、抓取跟踪、定位问题,才把闭环真正合上。
技能里有个特别的设计叫「功能地图」:它教智能体如何走到产品的每一个功能入口,包括侧边栏的子功能、键盘快捷键,以及通过CDP选择元素时用到的属性。没有它,智能体会在面对模糊的用户反馈时空转。有了它,一张截图甚至一句「???」都能被映射到具体功能上。他开发的PStack插件内置了创建页面,可以自动翻代码生成初始功能地图,并附带验证技能的创建与维护流程。
EVAL:给技能做单元测试
技能会随产品迭代而过时,怎么维护?他的答案是把EVAL当作技能的单元测试。流程大致是:协调代理先为技能制定评分标准,再派生多个子代理执行测试,子代理的目录名刻意命名为让它们察觉不到自己正在被评估——因为代理一旦察觉,就会改变行为。同一套技能可以在多个模型上评估,尤其关注实际会用的模型。
评估还能做爬山式优化:让评分迭代上升,用不同模型的评审代理交叉核对以避免偏见,配合Cursor的slash loop循环到各项满分。他用同样的流程打磨出Control Glass技能和命令行界面技能,过程需要大量迭代。
维护技能被他形容为需要「品味和观察力」,类似于结对编程时坐在旁边不断追问「你为什么不这么做」。在搭建技能的初期,要牢牢坐在驾驶位,展开所有工具调用,读代码、读代理的思考块,看清它在哪里失败。他特别提到一个观察:智能体常常自信地声称问题在某处,但查看实际工具调用记录会发现,它根本没读受影响的代码——这种幻觉是信任崩塌的起点。
EVAL(Evaluation)在AI智能体语境中,指的是对智能体行为进行系统性评估的测试套件,类似于软件工程中的单元测试或回归测试。其核心在于定义明确的评分标准(rubric),通过多次运行来检验智能体在特定任务上的表现是否稳定、可靠。与传统测试不同,EVAL通常需要处理自然语言输出的非确定性,因此常采用多模型交叉评审、多次采样取平均等策略来降低评估偏差。爬山式优化(hill-climbing)则借鉴了优化算法中的思想:每次迭代后根据评分调整技能描述或提示词,逐步逼近更优表现。这种评估驱动的开发方式,使得智能体技能可以像代码一样被持续迭代和版本管理。
云端代理与Dune架构:把约束硬编码进CI
当本地信任建立后,他建议把重心转向云端代理。一个叫Benny的代理会接收所有缺陷报告,自动在云端桌面环境里运行Cursor,用同样的控制技能复现问题。有个案例中,Benny确认缺陷在主分支上已修复,他只需发布一个新构建,省掉了人工复现的一小时。他强调不要跳步:如果在本地还不信任智能体,就贸然生成上千个代理,只会浪费大量Token且极其昂贵。
GrokBot所用的架构代号Dune,被他形容为「给Electron应用用的Next.js」,专为智能体编写代码而设计。CI严格到「烦人」:禁用了React的useEffect,甚至禁用代码注释——因为智能体写的注释往往在描述与代码无关的历史情况,比如把一句针对某个PR的临时评论当成全局规则写进注释。目录结构按Electron主进程与渲染进程分离,导入检查CI会校验依赖图与导入边界,防止跨目录误引。这些规则在BugBot代码审查、agents.md中同步落地。
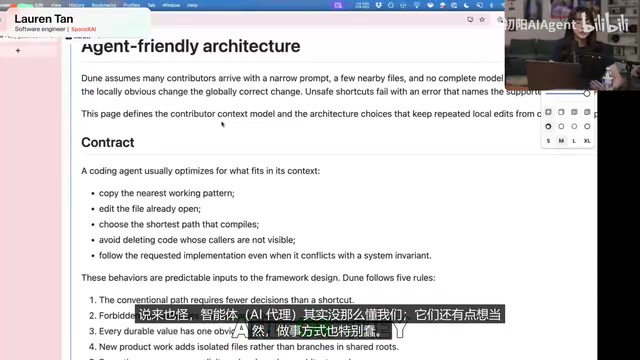
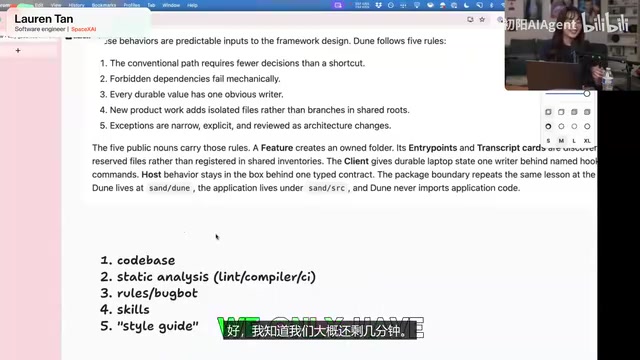
他的核心原则是「最短路径就是最佳路径」:既然智能体天生爱走捷径,那就把捷径设计成正确做法。功能模块全部收敛在单个目录,智能体做新手引导功能就只改那个目录,八成工作都在封装隔离中完成。他反复强调分层:代码库与静态分析是硬约束,规则、技能和BugBot则偏软,仅靠后者迟早让代码库失控。技术栈选择也有讲究——Rust编译器严格,借用检查器能提供额外信心,只要确保不写unsafe块,代码能编译大概率就能工作。
CI(持续集成) 在此处的作用被扩展为“硬约束的执行者”。传统CI主要关注构建与测试,而文章中的CI增加了禁用特定React Hook、禁止注释、导入边界检查等规则,将架构决策和编码规范编码为自动化检查。这种做法本质上是将“社会性约束”转化为“机器可执行的验证”,确保智能体在提交代码时无法绕过规则。借用检查器(borrow checker) 是Rust语言的核心特性,它在编译期静态分析内存所有权与生命周期,防止数据竞争和悬垂指针。对于智能体生成的代码,严格的编译器意味着大量潜在错误在编译阶段就被拦截,减少了人工审查的负担,这也是作者强调“代码能编译大概率就能工作”的原因。
重写还是重构:新项目的最大风险与最大机会
他提到一个常被回避的话题:什么时候该重写。存量应用处境其实不错,尤其当基础设施已经具备大厂级的护栏——他在Meta见过庞大单一仓库与成千上万工程师的协作,框架、约定、权限限制本就是为照顾团队中最弱的工程师设计的。这种护栏下,智能体不容易把代码库搞乱。
风险最大的是从零起步的全新项目。GrokBot本身就是氛围编程快速生成的产物,人类几乎不读代码,没有护栏时智能体会用最方便的方式解决问题,代码库逐渐失控。他算过一笔账:能在醒来时看到20个PR自动合并,是因为在600个PR的过程中投入了大量时间。把GrokBot迁移到新架构后,他已基本不看代码,但这背后是大量Token和持续强化的约束换来的。
平均PR规模从50行、几百行到约1000行不等,没有硬性上限,但他鼓励智能体把工作拆成多个原子PR,便于回滚和定位问题——Git历史本身就是丰富的上下文来源。
氛围编程(vibe coding) 指的是人类通过自然语言描述意图,由智能体快速生成代码而人类几乎不阅读或审查细节的开发模式。这种模式在早期能极大提升速度,但缺乏护栏时,智能体会选择最便捷的路径,导致代码库逐渐积累隐性债务和结构混乱。文章指出,存量项目因有成熟框架和约定作为护栏,反而风险较低;而全新项目缺乏这些约束,更容易失控。因此,作者建议在项目初期就投入时间建立硬约束(如CI规则、目录边界),而非事后补救。这也解释了为何他能在600个PR的迭代后才达到“醒来看到20个PR自动合并”的信任水平。
技术栈选择的隐藏价值
他提到GrokBot和Cursor的虚拟化由Pretax这个新库支持,但这并非重点。真正值得玩味的是他对技术栈的工具性判断:强类型、严格编译器意味着更多不变量由机器强制,减少人工审查的负担。最糟糕的处境是靠真人在代码审查中逐行读代码来执行约束——每次不得不这样做,都应该视为反模式,并追问:能不能把它变成静态检查规则、CI失败,或者干脆从设计上消除这个问题。
非工程师也能交付:GrokBot的组织意义
分享尾声谈到产品团队如何跟上交付速度。GrokBot让非技术背景的人第一次有了顺手的智能体入口:界面像iMessage,可以给代理起名字,像管理一个小团队一样编排。每个账户有11个代理由用户管理,产品经理可以让代理总结昨晚的工程进展,也可以直接说「这里有个bug,我来修」,再交由工程师评审。设计师和产品经理现在能直接交付功能,这套严格约束的架构经受住了考验。
关于Token成本的质疑,他的回应是投资回报视角:前期在模型调用上花很多钱,换来的是一个人无法独立完成的约束强度。如果全靠自己勾框架、做重构、测试验证,需要数年;而他的薪水不低。对工程负责人而言,真正的问题是雇人来做,还是花Token搭一个让最笨的智能体也能干好的代码库。他的选择是后者,因为它同时赋能了自己、团队和非工程角色。
要点回顾
从验证技能起步,先本地建立信任,再扩展到云端代理,最后才走向自动合并。没有捷径,因为信任无法伪造。硬约束优先于软规则,最短路径优先于灵活设计,机器强制优先于人工审查。这套心法的底层逻辑,是把工程标准编码成智能体能执行、能验证的东西——然后你才敢在睡觉时把主分支交给它。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。