Grokking新解:秩压缩是顿悟的标志而非成因
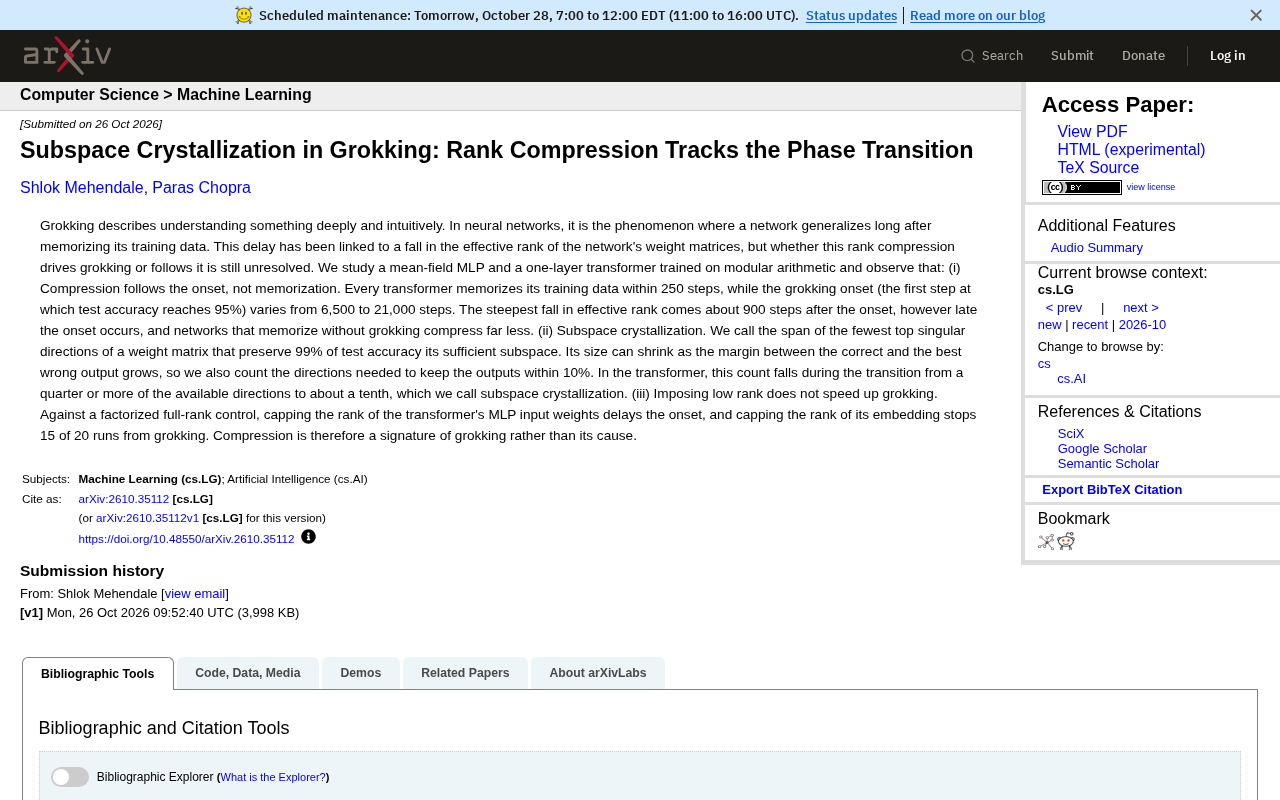
新研究证明权重矩阵的秩压缩发生在顿悟之后,是伴随信号而非驱动因素。
一项新研究通过模运算任务上的系统实验,重新审视了神经网络顿悟现象中有效秩下降的作用。研究发现,Transformer在250步内记住训练集,但顿悟起点从6500步到21000步不等,而有效秩最陡峭的下降始终出现在顿悟起点之后约900步,只记忆不泛化的网络压缩程度更小。研究进一步提出“子空间结晶”概念:相变期间,保留99%测试准确率所需的方向数从可用方向的四分之一以上降至约十分之一。因果对照实验显示,对MLP输入权重强制低秩会延迟顿悟,对嵌入层强制低秩则在多数运行中完全阻止顿悟。结论是压缩是顿悟的伴随特征而非驱动因素,监控有效秩可作为检测泛化阶段的指标,但不能通过强制低秩来催生顿悟。
神经网络中的“顿悟”(Grokking)现象——模型在长时间记忆训练数据后突然泛化——一直吸引着研究者的目光。此前有观点认为,权重矩阵有效秩的下降是驱动顿悟的关键因素,但一项新研究通过系统实验给出了不同答案:压缩跟随顿悟发生,而非导致顿悟。
核心发现:压缩滞后于顿悟起点
研究团队在模运算任务上训练了平均场MLP和单层Transformer。他们观察到,所有Transformer都在250步内记住了训练集,但顿悟起点(测试准确率首次达到95%的步数)却从6,500步到21,000步不等。有趣的是,无论顿悟发生得多晚,有效秩最陡峭的下降始终出现在顿悟起点之后约900步。那些只记忆而不泛化的网络,压缩程度要小得多。
这组数据直接挑战了“秩压缩驱动泛化”的假说。如果压缩是原因,它理应出现在顿悟之前,但事实恰恰相反。
有效秩(effective rank) 是衡量矩阵“实际使用维度”的指标,通常由奇异值分布定义:将奇异值归一化为概率分布后计算其熵的指数,或统计覆盖给定能量比例所需的方向数。当权重矩阵的有效秩下降时,意味着网络把信息集中到少数几个奇异方向上,而非均匀分布在全部维度中。在神经网络中,有效秩常被用作表示复杂度或压缩程度的代理指标,因此有研究者猜测它是泛化的驱动力。但有效秩下降本身只是描述性的几何变化,并不直接说明因果方向,需要结合训练时间线判断其与泛化相变的先后关系。
子空间结晶:从四分之一到十分之一
研究还提出了一个更精细的概念:子空间结晶。他们定义“充分子空间”为权重矩阵中最少的顶部奇异方向张成的空间,能保留99%的测试准确率。由于该子空间的大小会随着正确输出与最佳错误输出之间的间隔增大而缩小,研究者还统计了将输出误差控制在10%以内所需的方向数。
在Transformer中,这个方向数在相变期间从可用方向的四分之一以上下降到约十分之一。形象的比喻是,网络仿佛在顿悟过程中“结晶”出一个低维子空间,把关键信息浓缩到少数几个方向上。
奇异值分解(SVD) 将任意矩阵分解为两个正交矩阵与一个对角奇异值矩阵的乘积,奇异值按从大到小排列,对应的左、右奇异向量张成矩阵的行空间与列空间的主方向。在分析权重矩阵时,顶部奇异方向对应网络最敏感、携带最多信息的输入输出方向;丢弃小奇异值方向相当于低秩近似。文中“顶部奇异方向张成的子空间”正是基于SVD定义的:保留前k个奇异方向即可近似原矩阵。子空间大小随输出间隔增大而缩小,意味着泛化后的网络可以用更少的方向保留关键功能,这正是“结晶”的几何含义。
强制低秩反而拖慢顿悟
为了检验因果关系,研究者设置了对照实验:对Transformer的MLP输入权重施加秩上限,与全秩分解控制组相比,顿悟起点被延迟;而对嵌入层施加秩上限,则在20次运行中有15次完全阻止了顿悟。
换言之,人为压低秩并不能加速泛化,反而可能阻碍顿悟。这进一步支持了“压缩是顿悟的伴随特征”的结论。
模运算任务(如模加法、模乘法)是研究顿悟的经典基准:输入是两个整数及其运算,输出是模某个素数后的结果。这类任务具有离散的代数结构,网络必须先记忆训练样本,再在训练后期突然学到可泛化的算法规则。模运算的样本空间有限,便于精确控制训练集与测试集划分,且泛化行为对架构和超参数敏感,因此常被用来观察顿悟起点、有效秩变化等相变信号。平均场MLP和单层Transformer在此类任务上的对比,有助于区分架构因素与优化动力学因素对顿悟的影响。
对理解泛化的启示
这项研究将顿悟重新定位为一种相变过程,而秩压缩和子空间结晶是这一相变的标志性信号。对于实践者而言,这意味着监控有效秩可以作为检测模型是否进入泛化阶段的指标,但不能指望通过强制低秩来“催生”顿悟。理解泛化的内在机制,仍需从优化动力学和表示学习的角度深入探索。
相关推荐
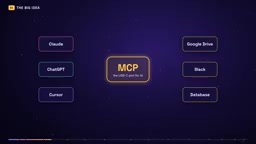
MCP 是什么?让 AI 接入所有工具的开放标准
MCP(Model Context Protocol)是让 AI 应用统一接入各类工具的开放标准。本文解析 MCP 的 Host、Server、Client 三角色,Tools、Resources、Prompts 三构建块,一次工具调用的完整链路,以及在 n8n 中的双向用法与安全风险。
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。