谷歌第四代旗舰Gemini 4 Argon发布:18项跑分拿下13项第一
谷歌发布第四代旗舰模型Argon,100万Token输出、18项基准13项第一,分阶段向用户开放。
谷歌在沉寂十个月后发布第四代首发模型Gemini 4 Argon,最大输出Token数从6.4万跃升至100万,超出前代15倍,主要用于支持大规模Agent推理任务。在Google自测的18项基准中,Argon拿下13项第一,知识工作与长文本推理领先明显,但编程与操作类任务落后于竞争对手。独立机构Artificial Analysis给出53分,与GPT-6 Astra、Cloud Fable 5.1并列前三。定价方面,输入2美元/百万Token,优惠期后翻倍,单任务成本低于Astra。模型采用"三层"分阶段开放策略,目前仅对内部团队及网络安全防御机构(Fairwind计划)开放,付费用户和普通用户的开放时间尚未确定。
周期表上第十八格的元素氩气(Argon),名字源自希腊语Argos,意为“懒惰”。它几乎不与任何东西发生反应,只有通上电才会亮起一道紫光。9月30号,Google把这个名字给了自己的第四代旗舰模型——距离上一代Gemini发布,已经过去整整十个月。
这十个月并不平静。原定发布的3.5 Pro没能如期出来,DeepMind也换了掌舵人。七个多月里,Google没再放出比Flash更高一档的模型。Gemini 4 Argon是第四代的首个成员,也是Corey接手之后交出的第一份答卷。
100万Token:留给思考的空间
Argon最硬的一个数字其实不在跑分表里。上一代Gemini一次最多输出64000个Token,而Argon把这个数字拉到了100万,涨幅超过15倍。
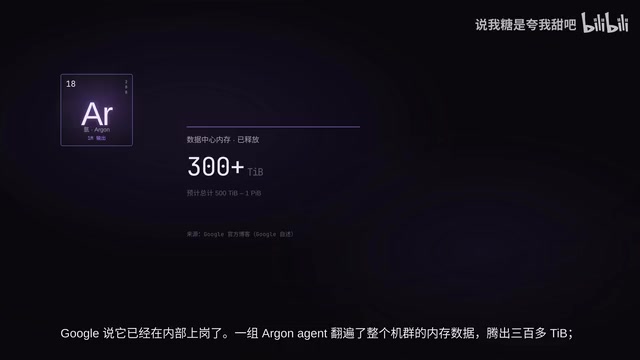
多出来的空间是留给“思考”的。在一次任务里,它能连着推理几十万个Token。Google表示该模型已经在内部上岗:一组Argon Agent翻遍了整个机群的内存数据,腾出300多TiB空间;它还把一个现成的Rust版视频解码器重写了一遍,速度是原来的2.7倍。
Google首席AI架构师Corey的说法是,Argon正在“从根本上改变Google工作和构建东西的方式”。价格也压得很低:每百万Token输入2美元、输出10美元,优惠期结束后翻倍。
Token是大语言模型处理文本的基本计量单位,粗略来说1000个Token约等于750个英文单词或500个中文汉字。输出Token上限决定了模型在单次对话中能"写出"多少内容,但对于具备推理能力的模型,更关键的是它能在"思维链"中消耗多少Token——每一步中间推理都占用输出配额。将上限从6.4万提升到100万,意味着模型可以在得出最终答案之前,进行远超以往规模的内部推演,这对需要多步骤规划的Agent任务(如遍历代码库、协调多工具调用)尤为关键。300 TiB约等于330TB,相当于数十万部高清电影的存储量,以Agent身份完成这类大规模内存整理任务,是当前业界鲜有公开案例的工程实践。
18项基准:13项第一,但软肋在编程
巧的是,Google这次摆上桌的基准正好18项,与氩原子的叙述呼应。同台竞技的是GPT-6 Astra、Cloud Fable 5.1和Opus 5.5。Argon拿下13项第一,其中一项是并列——并列的是CWE Bench,Grok 4.7、Argon和GPT-6 Astra三家都拿到了68%。
赢得最漂亮的是知识工作领域。在法律Agent测试Harvey中,Argon得了19.6分,三个对手都不到7分。在25万到100万Token的长文本推理里,它也领先十几分。
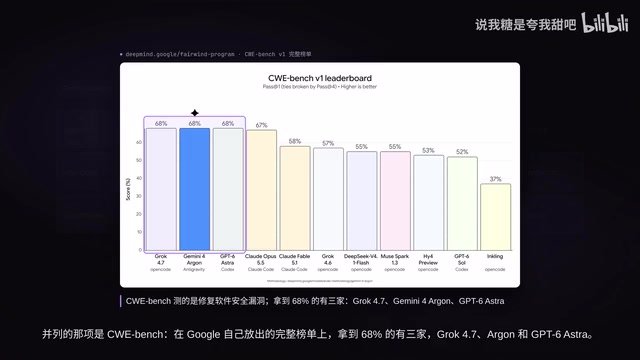
问题恰恰出在它最该证明自己的地方——写代码、做实验、操作电脑。Frontier SWE落后Astra 10.5分,Terminal Bench落后Opus 9分。更关键的是,这张表是Google自己出的,对手的分数大多也来自各家“自拍”。
换把外面的尺子:重回前三
独立评测机构Artificial Analysis给Argon打了53分,与GPT-6 Astra、Cloud Fable 5.1同分,比Opus 5.5低5分。他们的结论是:Google重新回到了前三。
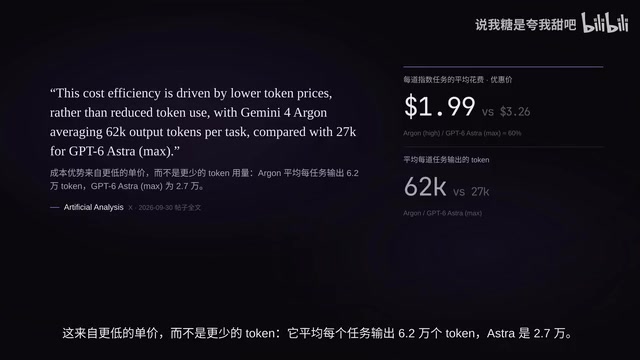
按每个测试任务算,Argon的成本是Astra的六成——这来自更低的单价,而不是更少的Token消耗。它平均每个任务输出6.2万个Token,Astra是2.7万。优惠期结束后,它的单任务成本约为Astra的1.2倍。
幻觉率方面,Argon为15%,在智能指数45分以上的模型里最低;但准确率只有50%,比Astra低13分。另一家评测方将它排在综合榜第一,这是Gemini头一回登顶——不过同一方自己跑Terminal Bench Science只得了44.3,Google表里写的是57.6,原因是Google自测时给了6倍的验证超时,两边条件并不一样。
同一天,彭博社还听到另一种声音:一些Google员工觉得它跑分好看,真干起活来却吃力。Google否认了这个说法。
幻觉率(Hallucination Rate)与准确率在此语境下衡量的是不同维度:幻觉率指模型给出看似合理但实际错误信息的比例,准确率则衡量最终答案与标准答案的吻合程度。两者可以同时偏低——即模型既少说"瞎话",又答对的题目也不多,这通常意味着它倾向于给出保守或模糊的回答以规避错误,而非大胆猜测。Argon 15%的幻觉率配合50%准确率,暗示它在不确定时更倾向于"少说"而非"乱说",这在法律、医疗等高风险场景中是有价值的取向,但在需要大量解题的编程基准上会拖累得分。
三层电子:分阶段点亮
截至北京时间10月1号早上,Gemini API的模型列表里还没有Argon。可以把它的开放计划想象成氩原子的三层电子结构。
最里面一圈已经亮起:Google自己的团队,加上Fairwind计划里的网络安全防御者。Fairwind计划面向全球650多家机构,优先给政府、医疗、电信、能源、金融这些关键设施,门槛很高——要过背景审查,只能给内部安全团队用,不许转卖。他们拿到的是不带网络安全护栏的Argon。Google的逻辑是让防守方先用,赶在攻击者之前把漏洞补上。同时,它还在走美国政府的发布前测试。
第二圈是付费API用户和AI Ultra订阅者。Google说要先收集反馈、调好护栏再尽快开放,价格已经定了,日期还没定。
最外一圈才是所有开发者、企业和普通用户。免费版能不能用上,Google没有承诺。用Corey的话说,这个级别的能力得分阶段放出来。
惰性气体并不是不会反应,只是需要条件。Argon已经被点亮,下一步就看这些条件什么时候满足。
Fairwind计划所涉及的"不带网络安全护栏"版本,指的是移除了模型默认的拒绝生成攻击性代码、漏洞利用脚本等安全过滤层。常规商业模型会拒绝详细描述如何入侵特定系统,而安全研究人员做渗透测试或漏洞复现时恰恰需要这类能力。Google的逻辑借鉴了网络安全领域"漏洞披露"的惯例:让防守方(蓝队)先于攻击者获得工具,才能在漏洞被恶意利用前完成修补。背景审查和禁止转卖的限制,则是为了防止这一"去护栏"版本流入灰色市场——这也是目前业界将高能力AI模型向安全社区开放时普遍面临的核心张力。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。