谷歌EmbeddingGemma 2:轻量开放的多模态嵌入模型

谷歌开源EmbeddingGemma 2,以7.4亿参数将文本、图像、视频、音频统一嵌入,专为端侧离线检索设计。
谷歌发布的EmbeddingGemma 2是一款多模态嵌入模型,能将文本、图像、视频和音频映射到同一高维嵌入空间,从根本上简化了跨模态检索的工程复杂度。模型最大参数量仅7.4亿,专为边缘硬件优化,默认输出768维向量,并借助Matryoshka表征学习支持截断至128维以节省资源,同时具备8000 token的上下文窗口。在实际应用层面,它可在手机本地完成照片自然语言搜索、视频精确片段定位,以及与轻量生成模型组合构建完全离线的RAG管线,全程数据不离设备。模型权重已在Hugging Face开放,并支持针对法律、医疗等垂直领域的微调。
谷歌最新发布的 EmbeddingGemma 2 把文本、图像、视频和音频映射进同一个嵌入空间,试图解决跨模态检索长期以来依赖多个独立模型的痛点。这款模型主打轻量与开放,最大参数量仅 7.4 亿,却在多个基准测试上超越了体量更大的竞品,专为端侧硬件设计。
一个模型统一多种模态
过去做跨模态检索,往往需要为文本、视觉、音频各自配备独立模型,流程繁琐且难以协同。EmbeddingGemma 2 的核心变化在于,它把文本、图像、视频、音频,或者它们的任意组合,都映射到一个统一的高维嵌入空间中。
用官方的比喻来说:一张猫的图片、"猫"这个词、以及猫的叫声,在这个共享的嵌入空间里会彼此靠近。这种统一表征让单一模型就能支撑搜索、检索、分类和聚类等多种任务,而不必在不同模态间来回切换模型。
为端侧而生的参数与维度设计
模型采用模块化设计,最大参数量控制在 7.4 亿,目标明确——在边缘硬件上高效运行。它默认输出 768 维向量,但借助 Matryoshka Representation Learning(套娃表征学习),开发者可以把输出维度截断到低至 128 维,以在精度和资源占用之间灵活权衡。
配合 8000 token 的上下文窗口,EmbeddingGemma 2 能够直接在设备端嵌入长文档、代码库乃至较长的语音录音,供后续搜索和检索使用。谷歌强调,这款模型为十亿参数以下的模型树立了新标准,在若干基准上的表现甚至优于规模更大的模型。
Matryoshka Representation Learning(MRL,套娃表征学习)是一种训练嵌入模型的技术,灵感来自俄罗斯套娃玩具。它在训练时同时对多个向量维度施加监督损失,使得较短的前缀向量(如前128维)本身就能成为有意义的嵌入表示,而非随机截断。这样一来,开发者无需重新训练模型,只需截取向量的前N维,就能在精度略微下降的前提下大幅减少存储占用和计算量。对于存储空间和内存带宽受限的端侧场景,MRL 提供了一种在检索质量与资源消耗之间动态权衡的实用手段,比如在索引数百万条媒体内容时,128维向量相比768维可将向量库体积缩小约6倍。
端侧应用:离线搜索与视频时刻定位
在谷歌 AI Edge Guide 的演示中,EmbeddingGemma 2 展现了两类实用能力。其一是即时媒体搜索,用户可以用自然语言查询直接检索照片和视觉素材;其二是视频时刻定位(Video Moment Finder),比如在一段生日视频里搜索"吹蜡烛",模型能立刻定位到那一精确片段。
关键在于,整个过程都在手机本地完成,不需要中间的语音转写步骤,也没有任何外部 API 调用。换句话说,搜索可以完全离线进行。
隐私优先的 RAG 与智能体工作流
当 EmbeddingGemma 2 与轻量的生成式模型(如 Gemma 系列)搭配时,可以构建 RAG 管线和智能体工作流,而敏感的用户数据始终留在硬件本地。
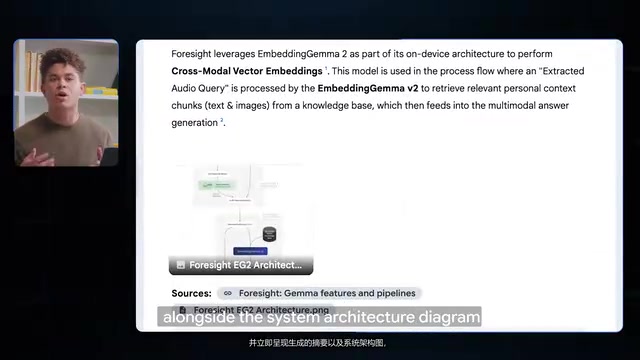
在 AI Edge Foresight 应用的示例中,这款应用会在后台持续监听,对音频流进行嵌入、检测问题,并即时给出生成式摘要,同时从本地存储中检索出相关的系统架构图。由于所有嵌入都在设备端完成,敏感信息严格保持私密。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与大语言模型生成能力结合的架构范式。其基本流程是:先将知识库内容编码为嵌入向量存入向量数据库,当用户提问时,将问题同样编码并检索出语义最相关的文档片段,再将这些片段作为上下文注入生成模型,从而让模型能够基于最新或私有知识作答,而不仅依赖训练时固化的参数知识。传统 RAG 管线通常依赖云端 API,数据必须离开设备。EmbeddingGemma 2 与轻量生成模型的本地组合,使得 RAG 管线首次可以完整运行于手机等边缘设备,用户的文档、通话录音等敏感数据无需上传,既保障隐私,又可在无网络环境下正常使用。
开箱即用之外的微调空间
除了出色的开箱即用质量,EmbeddingGemma 2 还支持针对特定领域词汇和专业素材进行微调——无论是索引复杂的法律合同、医学影像还是技术产品目录。微调能够在不增加模型体积的前提下提升检索精度,这对垂直行业落地尤为重要。
谷歌已在 Hugging Face 上开放模型权重下载,并在 Gemma cookbook 中提供了配套的 notebook 示例,方便开发者快速上手。
小结
EmbeddingGemma 2 的意义不只是又一个嵌入模型,而在于它把多模态统一表征、轻量端侧部署与隐私保护三者结合起来。对于希望在手机等边缘设备上构建离线搜索、检索增强生成应用的开发者而言,这是一个值得关注的开放选项。
相关推荐
Databricks上线Workday Data Connect联邦连接器:Unity Catalog打通HR数据
Databricks宣布Workday Data Connect联邦连接器在Unity Catalog进入公开Beta,支持通过查询联邦直接访问Workday的HR与财务数据,实现统一治理与跨域分析,降低ETL工程负担。
OpenAI DevDay 发布 Codex Cloud:AI 编程走出笔记本
OpenAI 在 DevDay 2026 推出 Codex Cloud、Space 和 dots,让 AI 编程 Agent 彻底摆脱本地笔记本。本文详解云端环境自动配置、私有资源访问、代码审查重构、Slack 协作与 CLI 改版等关键更新。
OpenAI DevDay 2026:ChatGPT Work如何重塑日常工作流
OpenAI DevDay 2026 演讲详解 ChatGPT Work、Space 与 Dots 三款产品,通过社交运营、竞争研究、人力资源三位内部高频用户的真实案例,展示 AI 智能代理如何接管日常工作、重塑知识工作者的协作方式。