Gemini 3.5 Live Translate:谷歌实时翻译模型深度解析

谷歌推出专为跨语言沟通打造的音频模型
谷歌近日正式发布了 Gemini 3.5 Live Translate,这是一款专为快速跨语言实时沟通而构建的最新音频模型。从官方的宣传语"Say hello, hola, 你好"可以看出,该模型至少覆盖了英语、西班牙语和中文等主要语种,目标是打破语言壁垒,实现无缝的多语言交流。
Gemini 3.5 Live Translate 的定位与意义
从文本翻译到实时语音翻译的跨越
传统的机器翻译主要聚焦于文本层面,而 Gemini 3.5 Live Translate 的核心突破在于实时音频翻译。用户可以在对话过程中即时获得跨语言的语音翻译,无需经历语音转文本、文本翻译、再合成语音的多步流程。这种端到端的音频模型架构,能够显著降低翻译延迟,让跨语言沟通更加自然流畅。
值得深入了解的是,传统语音翻译系统采用的是级联架构(Cascade Architecture),将任务分解为自动语音识别(ASR)、机器翻译(MT)和文本转语音(TTS)三个独立模块。这种流水线式的处理方式存在明显的误差累积问题——每个模块的错误都会传递到下一个环节,同时多步处理也带来了不可忽视的延迟。端到端(End-to-End)音频模型则用单一的神经网络直接完成从源语言语音到目标语言语音的映射,跳过中间的文本表示环节。这种架构不仅能减少延迟,还能更好地保留说话者的语调、情感和韵律等副语言信息(Paralinguistic Information),使翻译后的语音更加自然。
端到端音频翻译模型的一个重要优势在于对副语言信息的保留能力。副语言信息包括语调(intonation)、语速(speech rate)、音量变化、停顿模式以及情感色彩等。在传统级联系统中,当语音被转写为文本时,这些丰富的声学特征就已经丢失了。而端到端模型直接在声学特征空间中进行映射,理论上能够学习到源语言中的情感表达模式,并在目标语言的语音生成中加以还原。这对于商务谈判、医疗咨询等需要准确传达说话者情绪和态度的场景尤为重要。
从命名来看,"Live"强调了实时性,"Translate"则明确了其核心功能定位。相比 Gemini 系列此前在多模态理解和生成方面的通用能力,这次发布的模型更加垂直化,专注于解决跨语言实时沟通这一具体场景。
谷歌在AI翻译赛道的竞争格局
实时语音翻译一直是科技巨头竞相角逐的领域。Meta 此前推出了 SeamlessM4T 系列模型,OpenAI 的 GPT-4o 也展示了强大的多语言语音交互能力。谷歌此次以 Gemini 3.5 系列的名义推出专用翻译模型,显然是要在这一赛道上巩固自身的技术领先地位。
具体来看,Meta 在2023年发布的 SeamlessM4T(Massively Multilingual & Multimodal Machine Translation)支持近100种语言的多种翻译任务,且统一在单一模型架构中。随后 Meta 又推出了 SeamlessStreaming(支持流式翻译,进一步降低延迟)和 SeamlessExpressive(能保留说话者的情感表达和语音风格)等升级版本。OpenAI 的 GPT-4o 则从另一个角度切入,通过原生多模态能力直接处理音频输入和输出,展现了大语言模型在语音交互中的巨大潜力。这些技术路线的竞争正在加速实时语音翻译从实验室走向大规模商用。
有意思的是,谷歌在翻译领域有着深厚的积累——Google Translate 已经运营了近二十年,积累了海量的多语言平行语料。Google Translate 自2006年上线以来,经历了多次重大技术迭代:早期采用基于统计的机器翻译(SMT),2016年推出了采用序列到序列深度学习架构的 Google Neural Machine Translation(GNMT)系统,实现了翻译质量的质的飞跃。更具里程碑意义的是,2017年谷歌发表了《Attention Is All You Need》论文,提出了 Transformer 架构——这不仅彻底改变了机器翻译领域,更成为了后来所有大语言模型的基础架构。
Transformer架构的核心创新是自注意力机制(Self-Attention Mechanism),它允许模型在处理序列中的每个位置时,同时关注序列中所有其他位置的信息,从而捕捉长距离依赖关系。相比此前主流的循环神经网络(RNN)和长短期记忆网络(LSTM),Transformer不仅在翻译质量上大幅提升,更重要的是其高度并行化的计算特性使得训练效率成倍提高。这一架构后来催生了BERT、GPT系列、PaLM以及Gemini等一系列里程碑式的模型,可以说现代AI的爆发式发展在很大程度上源于这篇诞生于机器翻译领域的论文。
目前 Google Translate 支持超过130种语言,每天处理超过1000亿个单词的翻译请求,积累了规模庞大且质量极高的多语言平行语料库。将这些数据优势与 Gemini 系列的大模型能力相结合,有望在翻译质量和响应速度上实现新的突破。
Gemini 3.5 Live Translate 技术亮点
低延迟与跨语言双向翻译
从官方描述中的"fast, cross-language communication"可以提炼出两个关键技术指标:
- 速度(Fast):低延迟是实时翻译的生命线。在面对面交流或视频会议场景中,翻译延迟超过1-2秒就会严重影响对话体验。Gemini 3.5 Live Translate 显然在推理速度上做了重点优化。
- 跨语言(Cross-language):不仅仅是单向翻译,而是支持多语言之间的双向甚至多向实时转换,这对模型的语言理解和生成能力提出了更高要求。
在延迟优化方面,实时翻译面临着多重技术挑战。语言学研究表明,人类对话中自然的话轮转换间隔约为200毫秒,而超过2秒的沉默就会让对话参与者感到明显的不适。实时翻译系统的延迟来源包括音频采集和传输延迟、模型推理计算延迟,以及语言结构差异带来的等待延迟——例如德语中动词常出现在句末,翻译系统需要等待整句说完才能准确翻译。
流式翻译(Streaming Translation)面临的最大语言学挑战之一正是不同语言之间的语序差异。例如,英语是SVO(主语-动词-宾语)语序,而日语和韩语是SOV(主语-宾语-动词)语序,德语的从句中动词位于句末。这意味着翻译系统在处理某些语言对时,必须等待源语言说话者说出关键信息后才能开始生成目标语言的翻译。业界为此开发了多种策略,包括基于注意力机制的等待策略(Wait-k Policy,即模型在读取源语言k个词后开始输出翻译)、自适应分段策略(Adaptive Segmentation,根据语义完整性动态决定何时开始翻译),以及利用上下文预测尚未说出内容的预测性翻译(Anticipatory Translation)。这些策略需要在翻译质量和延迟之间找到最佳平衡点。
为应对这些挑战,业界采用了多种技术手段,包括流式处理(Streaming Processing,边听边翻而非等整句说完)、推测性解码(Speculative Decoding)、模型量化和蒸馏以减小模型体积加速推理,以及针对特定硬件(如谷歌自研的 TPU 芯片)的推理优化。
谷歌自研的张量处理单元(Tensor Processing Unit, TPU)是其AI基础设施的核心竞争力之一。TPU专为矩阵运算和深度学习推理而设计,相比通用GPU在特定AI工作负载上具有更高的能效比。目前谷歌已经迭代到第五代TPU(TPU v5p),其互联带宽和计算密度持续提升。对于实时翻译这类对延迟极度敏感的应用,TPU的低延迟推理能力至关重要。此外,谷歌还开发了专门的推理优化框架,包括模型并行化策略、动态批处理(Dynamic Batching)和自适应计算(Adaptive Computation)等技术,确保在大规模并发请求下仍能维持毫秒级的响应时间。
实时语音翻译的应用场景
这款模型的应用前景非常广阔:
- 国际商务会议:参会者使用各自母语发言,模型实时翻译为其他与会者的语言
- 旅行场景:游客与当地人的即时语音交流,告别手动输入翻译的繁琐
- 跨国客户服务:企业为全球客户提供母语级别的实时支持,提升服务体验
- 教育领域:跨语言的实时课堂互动,让优质教育资源突破语言限制
对AI翻译行业的深远影响
谷歌将翻译功能从通用大模型中独立出来,打造专用的 Live Translate 模型,反映了一个重要趋势:AI大模型正在从通用走向专用。在特定场景下,专门优化的垂直模型往往能提供更好的性能和用户体验。
这一趋势背后有着深刻的技术逻辑。AI大模型的发展正在经历从"大而全"到"专而精"的分化过程。早期的大模型竞赛主要比拼参数规模和通用基准测试成绩,但业界逐渐认识到,通用模型在特定任务上的表现往往不如经过专门优化的垂直模型。这催生了多种技术路线:一是在通用大模型基础上进行领域微调(Domain Fine-tuning),二是从架构层面针对特定任务重新设计模型结构,三是通过知识蒸馏(Knowledge Distillation)将大模型的能力压缩到更小、更高效的专用模型中。
知识蒸馏是一种模型压缩技术,其核心思想是让一个较小的"学生模型"学习较大"教师模型"的输出分布,而非仅仅学习训练数据的硬标签。在实时翻译场景中,教师模型可以是参数量巨大但翻译质量极高的离线模型,而学生模型则是体积更小、推理更快的在线模型。通过蒸馏,学生模型能够在保持接近教师模型翻译质量的同时,大幅降低计算资源需求和推理延迟。近年来,研究者还提出了多种改进的蒸馏方法,如序列级蒸馏(Sequence-Level Distillation)、注意力转移(Attention Transfer)和渐进式蒸馏(Progressive Distillation),使得蒸馏后的模型在特定任务上的性能损失越来越小。
谷歌将翻译功能独立为 Gemini 3.5 Live Translate,很可能结合了上述多种策略,在保留大模型强大语言理解能力的同时,针对实时翻译场景进行了深度的延迟优化、语种覆盖优化和语音质量优化。这种"大模型底座+垂直优化"的产品策略,正在成为AI应用落地的主流范式。
这也意味着,未来我们可能会看到更多基于大模型底座、针对特定任务深度优化的垂直产品。对于翻译行业而言,实时语音翻译技术的成熟将进一步降低跨语言沟通的门槛,推动全球化协作进入新阶段。
目前谷歌尚未公布 Gemini 3.5 Live Translate 的详细技术参数、支持语种完整列表以及具体的产品形态,但从 Gemini 3.5 的版本号来看,这应该是谷歌最新一代模型架构的产物,值得持续关注后续的技术细节披露和产品落地情况。
核心要点
- 产品定位:Gemini 3.5 Live Translate 是谷歌专为实时跨语言语音沟通打造的垂直化音频模型,标志着AI翻译从文本时代迈入实时语音时代
- 技术架构:采用端到端音频模型架构,跳过传统级联系统的文本中间表示,在降低延迟的同时保留副语言信息
- 竞争格局:与Meta SeamlessM4T系列和OpenAI GPT-4o形成三足鼎立之势,谷歌凭借近二十年的翻译数据积累和自研TPU硬件优势占据有利位置
- 行业趋势:反映了AI大模型从通用走向专用的分化趋势,"大模型底座+垂直优化"正在成为AI应用落地的主流范式
- 应用前景:覆盖国际商务、旅行、客户服务、教育等多元场景,有望大幅降低全球跨语言沟通的门槛
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
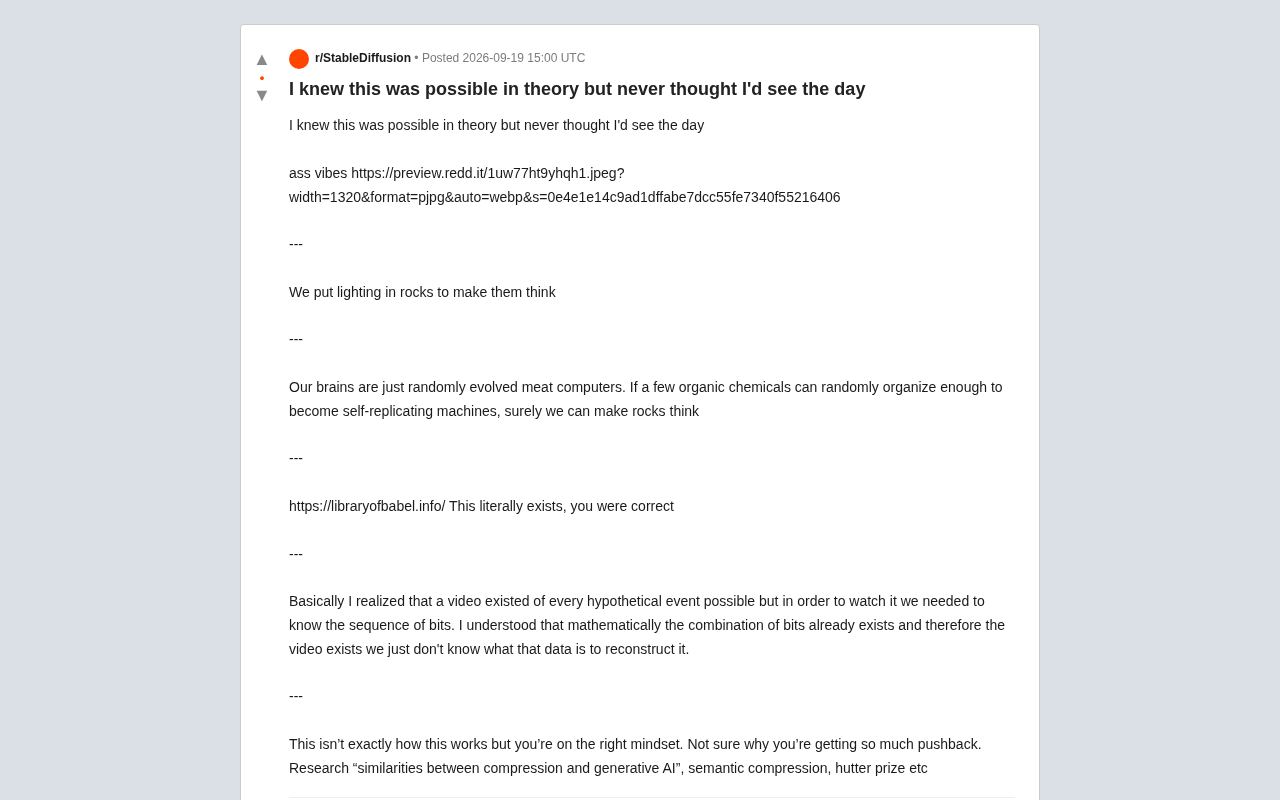
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
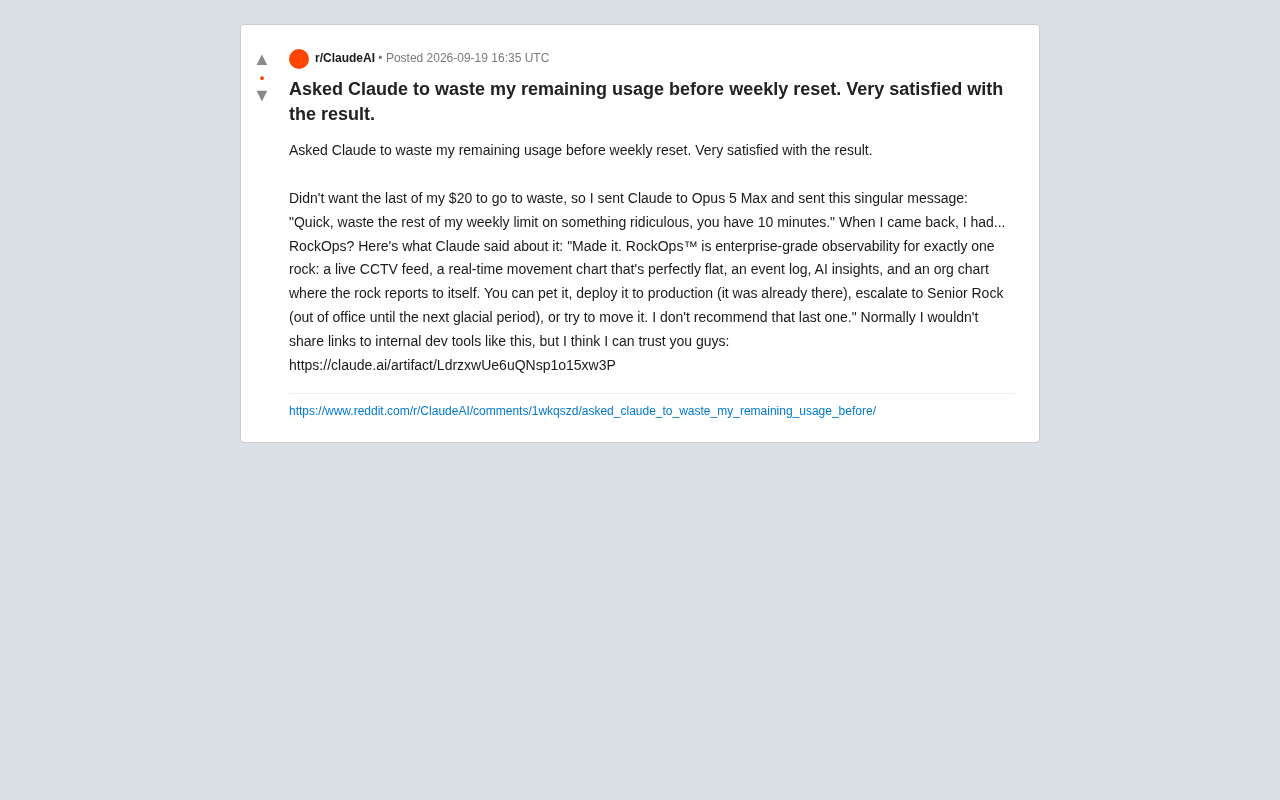
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。