谷歌Gemini 4 Argon发布实测:逻辑推理与编程能力有多强

谷歌Gemini 4 Argon以逻辑推理登顶、编程与工具调用能力升级,推动AI从「能说会写」走向「能想能做」。
谷歌发布旗舰模型 Gemini 4 Argon,定位不再是聊天,而是复杂推理、专业知识、编程与机器人控制。在 LeftBench 2.0 中综合得分 84.1 排名第五,但逻辑推理 95.1、数据分析 85.2 均列第一,Wealth Index 专业知识评测得分 68.9% 同样登顶。实测展示了 AI 教人形机器人投掷沙包、维护 Chromium 大型代码库,以及四张照片生成可交互 3D 摄影棚、一条提示词生成商业级租房买房模拟器。对比 Claude Opus 5.5,同等 3D 任务快 26 倍、成本降低近 7 倍。通过多智能体协作与视觉反馈循环,模型还能自动完成 Blender 复杂建模与 17.4 万面互动模型生成,被视为图像、视频与语言模型开始融为一体的信号。
谷歌新一代旗舰模型杀回来了
谷歌正式发布旗舰AI模型Gemini 4 Argon,这次不只是聊天模型的迭代,而是瞄准复杂推理、专业知识、编程开发乃至真实世界机器人控制的一次全面升级。据B站UP主零度解说的实测分析,这款模型在多个专业评测中展现出惊人的爆发力。
在最新的LeftBench 2.0榜单中,Gemini 4 Argon综合得分84.1,排名第五。综合排名虽未登顶,但两个维度的成绩格外抢眼:逻辑推理拿下95.1分,全场排名第一;数据分析得分85.2,同样位列第一。在金融、法律、税务等专业知识工作评测中,Wealth Index得分达到68.9%,也是榜单第一。
这组数据指向一个清晰的信号:Gemini 4 Argon的核心定位不是陪聊,而是处理需要严密逻辑、专业知识和长时间持续执行的复杂任务。
从机器人到大型代码库,Google展示了两个关键案例
谷歌在发布中演示了两个直观的应用场景,揭示AI能力边界的延伸方向。
AI教人形机器人玩沙包投掷游戏
这不是简单的画面识别与问答,而是视觉理解、动作规划和现实世界执行的结合。机器人需要理解游戏目标,根据实际情况完成投掷动作。这个案例展示了一个重要方向:未来的AI不仅要能思考、能写代码,还要能理解物理世界并帮机器人完成真实任务。
Gemini for Argon维护Chromium大型代码库
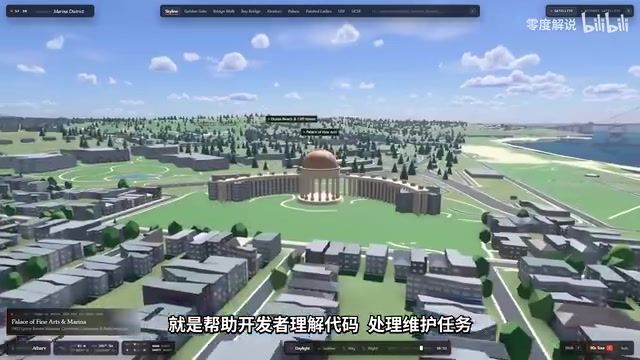
大型开源项目往往包含海量文件和复杂依赖关系,修改一个模块可能影响其他部分。Gemini for Argon的目标是帮助开发者理解代码、处理维护任务、提高开发流程效率。这标志着AI编程正从生成几段代码,走向理解大型项目、参与真实软件工程开发。
大型代码库维护与AI编程的演进
Chromium 是 Google 主导的开源浏览器内核项目(Chrome、Edge 等浏览器的底层引擎),代码量超过数千万行,涉及渲染、网络、安全、多进程架构等数百个模块,任何一个改动都可能引发跨模块的连锁反应。这类项目长期依赖资深工程师的经验和大量静态分析工具来降低风险。
让 AI 参与 Chromium 维护,本质上挑战的是「长上下文理解 + 跨文件依赖推理 + 工程规范遵循」三项能力。它要求模型不仅看懂单段代码,还要在庞大仓库中定位影响面、理解构建系统与测试流程,并生成符合项目风格的补丁。这与「生成一个函数」的难度不在同一量级。
因此,Gemini for Argon 若能在 Chromium 这类超大型项目中承担实际维护任务,意味着 AI 编程正从「代码补全工具」向「团队级工程协作者」演进。这也是当前各大模型厂商争夺的关键场景,因为一旦被工业级项目采纳,将直接改变软件开发的分工与人力结构。
编程实测:从照片到3D展厅,再到商业级金融模拟器
四张照片生成可交互3D摄影棚
上传四张不同角度的人物照片,Gemini for Argon直接构建出一个可运行的Web应用,包含落地窗、无缝影棚、青花屏风等场景元素,支持切换侧光、电影光、侧窗光、月夜蓝调等灯光模式,人物阴影随灯光实时变化。鼠标拖动可旋转视角,人物姿势可自由切换,平滑过渡效果接近电影海报质感。
据零度解说指出,初始尝试直接生成3D人物时效果并不理想,最终改用原图抠图放入3D场景后效果明显提升。如需真正的360度旋转3D人物,后续可尝试本地显卡方案。
从图像到3D:AI重建三维场景的技术背景
仅凭几张二维照片构建可交互的 3D 场景,背后涉及多项技术的协同。首先是图像理解与抠图,模型需要准确分离人物与背景;其次是相机姿态估计与多视角融合,判断照片间的空间关系;最后是场景合成,将抠出的人像放入虚拟光照环境中,并让阴影随光源实时变化。
业界类似能力通常由 NeRF、3D Gaussian Splatting 等专用技术实现,它们擅长从多视角重建真实物体,但难以「凭空生成可编辑的虚拟场景」。Gemini 4 Argon 的路径不同——它更像一个「用代码搭场景」的通用模型,先生成 Web 渲染代码,再在浏览器中实时呈现。这种方式灵活性更高,但在人物几何精度(如真正的 360 度旋转)上仍有限制,这也解释了原文提到「初始直接生成 3D 人物效果不理想」的现象。
一条提示词生成租房买房对比模拟器
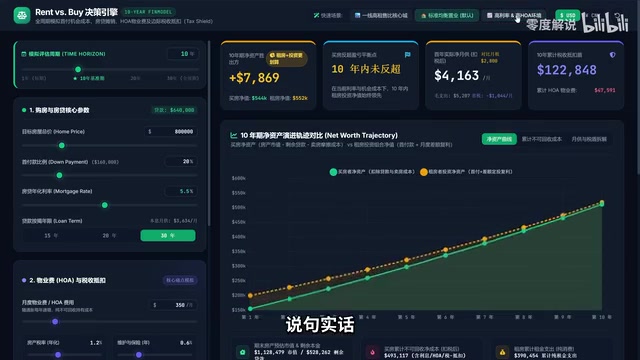
在10年时间跨度的租房与买房对比模拟中,Gemini 4 Argon生成了一个完整的财务分析工具。左侧参数栏包含首付款、房贷利率、物业费、税收抵扣等滑块和输入框,连边际税率抵扣段都做了动态处理。核心算法引入了首付资金的机会成本和复利计算,右侧不仅有月供成本解剖条,还配有三张可切换的动态图表,底部甚至带有一键导出CSV报表功能。
一行代码未改,直接生成的完成度令人惊艳。
性价比对决:速度与成本的双重优势
在太空列车矩阵测试中,面对同样的任务,Claude Opus 5.5花了1小时53分钟,成本23.46美元;Gemini 4 Argon仅用4分20秒,成本约3美元。速度快了26倍,成本降低近7倍。
零度解说也客观指出,Opus在体积云、机械细节和镜头表现上依然更胜一筹。但如果需求是更快生成高级3D场景,Gemini 4 Argon的性价比确实惊人。
工具调用与3D建模:AI自主完成复杂工程
Gemini 4 Argon通过反重力客户端,利用多智能体协作和视觉反馈循环,自动在Blender中打造了一座细节丰富的中式宝塔寺庙群,从多层建筑结构到周围植被光影,整个场景经过不断迭代优化,最终呈现接近照片级的真实感。
这已经不只是生成一张图片,而是AI自主调用工具完成复杂3D建模工作。
更有意思的是,上传一张哥特维多利亚风格马车图片,它从零开始通过代码生成一个拥有17.4万个面的互动式3D模型,车门可打开,车轮带物理效果,悬挂系统、闪烁灯笼和骷髅雕刻一应俱全,整个过程完全通过代码实现,未调用Blender。
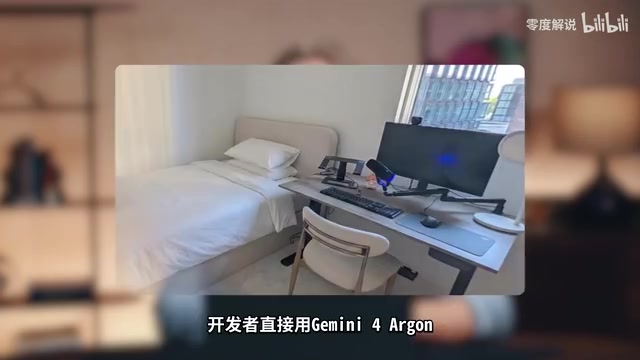
国外还有开发者用Gemini 4 Argon把一张家庭办公室桌面照片变成可实际游玩的赛车游戏,结合Blender MCP和SolidJS,还原桌面物品并转化为游戏场景中的障碍元素。原本普通的办公桌,变成了可驾驶赛车自由探索的3D游戏。
多智能体协作与视觉反馈循环
「多智能体协作」指的是让多个 AI 实例分工,分别扮演建模、材质、灯光、审校等角色,通过互相调用完成复杂任务。「视觉反馈循环」则指模型把当前 3D 场景渲染成图片后,自己观察效果,再决定下一步调整,如此反复迭代,接近人类画师「画→看→改」的工作方式。
Blender MCP 中的 MCP 指 Model Context Protocol,是一种让 AI 与外部软件(如 Blender、SolidJS 等)安全交互的开放协议,相当于给模型一套标准化的「工具接口」,使其能真正操作专业软件而非仅仅输出文本。
17.4万个面是 3D 建模中衡量模型精细度的常用指标,面数越多细节越丰富,但渲染与计算成本也越高。让 AI 从一张图直接产出高面数、可交互的模型,说明它已能较好地把视觉理解转化为可执行的几何与代码。
图片生成与使用方式
图片生成方面,零度解说提到需要打码处理,暗示内容限制较为宽松,已开通Ultra会员的用户使用反重力客户端效果会更好,尤其是工具调用和本地使用效率会大幅提升。
Gemini 4 Argon已上线谷歌反重力客户端,提供Windows、macOS和Linux版本下载,Pro会员也可直接在网页端使用。
总结:图像、视频与语言模型开始融为一体
零度解说在实测后评价:"Gemini 4 Argon是第一个让我感觉像是图像、视频和语言模型融为一体的AI大模型。虽然不是那么完美,但相比谷歌的上一代模型,进步确实挺大。"
从逻辑推理登顶,到编程能力覆盖大型项目维护,再到工具调用完成3D建模和真实世界机器人控制,Gemini 4 Argon展示的是一条AI从"能说会写"走向"能想能做"的路径。对于开发者、设计师和需要处理复杂专业任务的用户来说,这款模型的性价比和工程能力值得关注。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。