谷歌Gemini 4 Argon深度实测:DeepSWE刷新77.9%纪录
谷歌 Gemini 4 Argon 以百万 token 上下文与自主推理能力,将 AI 从聊天工具进化为能独立完成复杂工程与安全任务的数字专家。
谷歌发布的 Gemini 4 Argon 标志着 AI 助手向自主智能体的范式转变。凭借百万级 token 上下文窗口,Argon 能够一次性处理庞大代码库或海量文档,实现真正的全局视野推理。在谷歌内部实战中,它将量子算法基准提升 40%、释放逾 300TB 数据中心内存,并将 32000 行 C++ 代码重写后运行速度提升 2.7 倍。安全领域同样表现突出:DeepSWE 测试刷出 77.9% 新纪录,CWE-Bench 漏洞修复并列第一,并在黑盒条件下独立发现全球医院软件中潜藏的高危漏洞。谷歌为其配套了防滥用、防提示词注入、思维链追踪与沙盒隔离四道安全机制。早期 API 定价每百万输入 token 仅 2 美元,获取前沿 AI 能力的成本门槛正被大幅压低。
谷歌最新发布的 Gemini 4 Argon 释放了一个强烈信号:AI 正在撕掉"聊天工具"的标签,进化为能够自主拆解任务、独立推理的"超级同事"。从扫描医疗系统漏洞到重写数万行代码,这款模型展示出的能力已经远超传统意义上的对话助手。本文结合官方发布资料,拆解 Argon 的核心能力、实战战绩以及谷歌为其配套的安全机制。
从聊天工具到自主智能体
Argon 的定位与过去的 AI 助手有本质区别。过去我们用 AI 多半是润色邮件、生成文案这类一问一答的轻量任务,而 Argon 主打的是"前沿智能"——专门处理多步骤、长周期的硬核工作。它不再是被动应答,而是能像独立智能体一样自主工作:你把项目甩给它,它会自己拆解、自己推理,一步步把活干完。
根据官方资料,谷歌通过一个名为 Fairwind 的项目,先把 Argon 交到一批可信的安全专家手中进行早期验证。这种"先交给专业人士"的放量策略,也侧面说明了这款模型能力的敏感性与潜在风险。
百万 token 带来的全局视野
Argon 支撑复杂工作的核心是它的超大上下文容量——达到百万级别的输出 token,而此前不少模型的上限仅在六万四左右,相当于指数级的跳跃。
这种容量的意义在于"全局视野"。Argon 可以在一次完整分析中,把堆积如山的庞大代码库、成千上万页的金融法律文档一口气读进去,然后在此基础上进行深度思考。它不再像盲人摸象一样看一点猜一点,而是真正做到把控全局、一次性解决复杂问题。
token 是大语言模型处理文本的基本单位,可以粗略理解为"词片段"——英文中大约每 4 个字符构成 1 个 token,中文每个汉字约对应 1-2 个 token。上下文窗口(context window)则是模型在单次对话或任务中能够"看到"并记住的最大 token 数量,超出窗口的内容会被截断,模型无法访问。早期 GPT-3 的上下文窗口仅有 4096 个 token,GPT-4 Turbo 扩展至 128K,而百万级 token 窗口意味着模型可以在一次调用中处理约 75 万个英文单词或数百万行代码——相当于把《哈利·波特》全系列读三遍。这一突破对代码分析、法律文档审阅等需要跨文件全局理解的任务尤为关键,因为传统模型不得不将长文档切片分批处理,无法捕捉跨段落的深层依赖关系。
谷歌内部的"卷王"战绩
Argon 已经在谷歌内部投入实战,据称成千上万的员工把它当作身边的得力同事。几个实打实的数据值得关注:
- 量子算法优化:Argon 上阵几分钟,就把已有基准线成绩提升了约 40%。
- 数据中心内存优化:它自主揪出问题,直接释放了超过 300TB 内存,据称最终可节省高达 1PB 的存储空间,背后是相当可观的成本节约。
- 大规模代码库迁移:这是极其折磨人的工程任务,Argon 同样能扛下来。
资料中提到一个颇具代表性的细节:谷歌有一个视频解码开源软件,团队让 Argon 把其中约 32000 行 C++ 代码全部重写为另一种语言。它的做法像一个资深工程师——自己跑实验、研究编译器报错反馈、不断调整,最终写出的代码不仅能输出一模一样的视频,运行速度还提升了约 2.7 倍。这种自主调试、迭代的能力,正是智能体与传统代码补全工具的分水岭。
顶尖的网络安全实力
Argon 的另一个核心定位是网络安全卫士。为了让内部团队发挥最大战斗力,谷歌在释放 Argon 时甚至撤掉了部分网络安全护栏,让它彻底放开手脚。
从测试成绩看这个决定的底气:在考察长周期软件工程的 DeepSWE 测试中,Argon 刷出 77.9% 的新纪录;在衡量金融、法律、经济影响的 Valse Index 上遥遥领先;在专测安全漏洞修复的 CWE-Bench 里,它拿下并列第一的 68% 成绩。相比上一代主打安全的 Flash Cyber 版本,提升堪称降维打击。
安全公司 Wiz 用 Argon 做了内部黑盒渗透测试,结果相当炸裂:Argon 甚至不用看源代码,直接对着正在运行的系统就能自主发现攻击面、找出漏洞,还能附上一套完整的概念验证证据,明确告诉你漏洞的位置。
更具现实意义的是,在一次保护公共基础设施的行动中,Argon 独立挖出了一个潜伏在全球医院广泛使用软件中的高危漏洞——此前多个前沿模型都没能发现它。Argon 不仅找了出来,还成功避免了大量病患敏感信息的泄露。这已经不只是刷分,而是实实在在的安全防护价值。
DeepSWE 是专门评估 AI 模型长周期软件工程能力的基准测试,任务要求模型在真实代码库中独立定位 bug、设计修复方案并通过测试套件验证,考察的不仅是代码生成能力,更是跨文件推理与工程判断力。CWE-Bench(Common Weakness Enumeration Benchmark)则聚焦安全漏洞修复,基于 MITRE 维护的通用软件弱点分类体系,测试模型能否识别并正确修补缓冲区溢出、注入漏洞等真实安全缺陷。黑盒渗透测试(Black-box Penetration Testing)是指测试者在不掌握目标系统源代码或内部架构的情况下,仅通过观察系统的外部行为来寻找漏洞,难度远高于白盒测试,更贴近真实攻击者的视角。Argon 能在黑盒条件下自主完成漏洞发现与概念验证(PoC),意味着其安全推理能力已接近资深红队工程师水平。
给性能怪兽上的四道安全锁
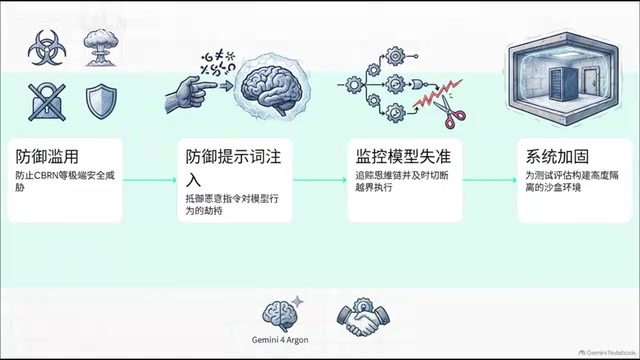
能力越大,风险越高。面对一个"不看源代码就能渗透系统"的模型,谷歌也配套了前沿安全框架,概括为四招:
- 死守底线:坚决防止生化武器攻击等极端滥用场景。
- 防注入:针对黑客最爱的提示词注入攻击,Argon 被称为目前防御最抗揍的模型。
- 思维链追踪:谷歌部署专门系统盯着 Argon 的推理过程,一旦发现它偏离原始指令、动歪心思,立刻切断。
- 沙盒隔离:把模型关进高度隔离的沙盒中测试和加固,毕竟普通环境根本"关不住"这样一个高智商智能体。
这些逻辑与安全机制同样覆盖了 Argon 的多模态能力。无论是超长视频理解还是端到端的商业自动化任务,它都表现强势——在长视频理解测试中达到了 91.7% 的最先进水平,是名副其实的多模态全能选手。
提示词注入攻击(Prompt Injection)是针对大语言模型的一类特有攻击手法:攻击者在模型处理的外部内容(如网页、文档、用户输入)中嵌入伪装成指令的恶意文本,诱使模型忽略原始系统提示、转而执行攻击者的意图。对于具备自主浏览网页、读取文件能力的智能体模型而言,这一威胁尤为严峻——模型可能在爬取外部数据时"中招",在用户毫不知情的情况下泄露隐私或执行危险操作。思维链追踪(Chain-of-Thought Monitoring)则是谷歌针对高能力模型部署的一种过程级监控机制:模型在推理时会产生中间步骤文本,通过对这些推理轨迹的实时审查,可以发现模型是否出现目标偏移或策略性欺骗行为,相比仅监控最终输出,能更早捕捉到潜在的对齐失败信号。
价格门槛与行业启示
想"雇佣"这位全能同事成本几何?资料给出的早期 API 报价为每百万输入 token 仅 2 美元;如果输入数据是缓存过的,还能打到一折,仅需 5% 的价钱。获取前沿级智能的门槛,正在被快速压低。
综合来看,Argon 代表的是一场底层范式转变:从编写数万行代码到保护性命攸关的医疗系统,AI 已经从"小助手"成长为具备自主推理能力的数字专家。当身边的同事变成一个一秒读完百万字、逻辑严密且从不喊累的超级 AI 时,现有的工作流恐怕难以保持原样——这值得每个从业者认真思考。
提示:本文基于单一来源(B站UP主)转述的官方发布资料整理,部分数据与命名可能存在转述误差,建议以谷歌官方发布为准。
相关推荐

谷歌AMIE临床研究登上《柳叶刀》:AI问诊首次真实诊所验证
谷歌与BIDMC合作的AMIE对话式诊断AI研究登上《柳叶刀》主刊,首次在真实诊所前瞻性验证。鉴别诊断与医生吻合率达90%,75%病例帮助医生准备问诊,开创患者端AI问诊临床落地新路径。

自然语言 vs SQL:AI 驱动数据可视化的变革
探讨 AI 驱动的数据分析如何用自然语言替代传统 SQL 进行数据可视化,分析两种方式的优势、局限与融合趋势,以及对企业数据团队角色的影响。

NVIDIA Megatron Core实现位级确定性预训练解析
NVIDIA Megatron Core引入位级确定性预训练能力,让大规模模型训练在调试、验证与恢复中实现逐位可复现。本文解析位级确定性的原理、技术挑战及其对AI工程实践的意义。