谷歌Gemini 4 Argon与量子突破领衔本周AI大事件

谷歌Gemini 4 Argon以百万token输出与量子纠错突破领衔,开源侧模型密集发布。
本周AI领域密集发布:谷歌推出Gemini 4 Argon旗舰模型,其最大差异点是单次可输出100万token,并在Vals Index知识工作榜居首且成本低一个数量级,但多项基准并未全面领先;谷歌同时在Willow上演示magic state cultivation,将量子态制备误差降低约40倍。Meta发布主打智能体的Muse Wonder与816B参数的Muse Spark Open,但后者使用门槛苛刻。开源侧MOSS Image以Apache 2.0许可和约5B参数成为实用文生图选择,Kling 4上线但未超越Seedance。此外Matrix Game 4.0实现单卡83 FPS实时游戏生成,Drama 3登顶开源TTS榜,RP1将人形机器人硬件设计全栈开源。
谷歌Gemini 4 Argon与量子突破领衔本周AI大事件
本周AI领域迎来密集发布:谷歌一次性抛出Gemini 4 Argon旗舰模型与量子计算二十年难题的突破性方案,Meta端出Muse Wonder与开源权重Muse Spark Open,Fish Audio的Drama 3登顶开源TTS榜单,MOSS Image以宽松许可加入开源图像生成竞赛,Kling 4正式上线。开源侧还有Matrix Game 4.0、UniForge 3D、Infinisplat V2等一批可本地运行的模型。
以下按话题拆解其中值得关注的部分。
谷歌的双线出击:Gemini 4 Argon与量子纠错
Gemini 4 Argon:输出1M token是真正的差异化
Gemini 4 Argon已面向Pro/Ultra及付费API用户开放。据发布页给出的数据,它在知识工作、智能体编程、科学与数学等维度超过GPT-6 Astra与Claude Opus 5,Vals Index知识工作榜排名第一,且成本显著低于第二、三名——该榜单横轴为对数刻度,意味着便宜接近一个数量级。医疗图像推理同样排在第一。
最值得单独拎出来说的是输出长度:单次响应可输出100万token。这不是上下文窗口,而是生成上限。此前前沿模型普遍停留在64K至128K输出,Argon直接把量级抬高了近十倍。对多文件代码库生成、长篇小说、完整报告这类任务,输出瓶颈的解除比几个百分点的跑分提升更实用。
它并非全面领先:MazeBench第二、VendingBench第三、KernelBench第三,BlueprintBench上几乎追平人类基线。另有一个值得注意的应用案例——谷歌称Argon参与设计了数种新酶,并已在真实实验室验证有效;还帮助优化了一个量子计算算法,把某项计算成本相对基线降低超过100倍。
输出上限与上下文窗口的区别
业界常把“上下文窗口”和“最大输出长度”混为一谈,但两者约束的是完全不同的能力。上下文窗口指模型在一次请求中能同时“看到”的输入加历史 token 总量,决定它能处理多长的文档、多少轮对话;最大输出长度则限制模型单次生成能写多长,直接决定它能否一口气产出完整的多文件代码库、长篇报告或整本小说。
此前多数前沿模型的输出上限停留在 64K 至 128K 量级,而输入窗口早已达到百万级——这意味着模型“读得下”却“写不完”,很多长任务必须分段多次调用,再由外部逻辑拼接,容易丢失全局一致性。把输出上限提高到 1M token 改变了这一工作流,使模型能在单一生成过程中保持对超长产物的整体规划,对智能体编程和长文档生成尤为关键。
量子计算:magic state cultivation把误差压了40倍
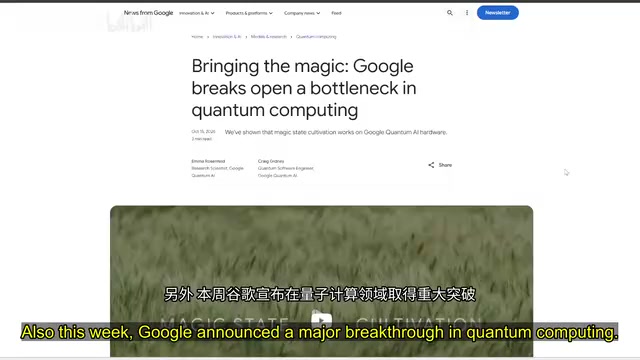
谷歌在Willow处理器上演示了被称为magic state cultivation的技术。背景是:量子计算机执行某些关键运算需要“魔法态”这种特殊量子资源,而制备它们的开销可能吃掉整机95%的算力,只剩5%留给真正的计算。
新方法的思路是从一个不完美的量子态出发,通过一系列测量逐步探测并剔除错误,最终得到干净得多的态。谷歌称误差降低约40倍,保真度达到99.99%。完整论文已发表在Science。需要冷静看待的是,这仍是单点演示,能否在更大规模上复现尚未验证;但若成立,它指向的是量子计算机硬件需求的大幅缩水。
魔法态(magic state)与容错量子计算
要理解这项突破的分量,需要先知道:量子计算机并非所有操作都同样“廉价”。在容错量子计算框架下,一类称为Clifford门的基本操作可以借助纠错码高效且稳定地实现,但它们本身不足以支撑通用量子计算——任何有实际价值的算法(如Shor因式分解、量子模拟)都必须依赖非Clifford门,而这类门在物理实现上极其昂贵。
“魔法态”正是实现非Clifford门的资源:通过离线制备一个特定量子态,再借助“魔法态注入”操作把它转化为所需的非Clifford门。问题在于,高保真度的魔法态难以直接制备,通常需要用大量低质量副本通过蒸馏(distillation)逐步提纯,开销随目标误差指数增长。谷歌此次的magic state cultivation绕开传统蒸馏路线,改用带反馈的测量序列直接“培养”出高保真态,若能规模化,将显著降低容错量子计算机的物理量子比特需求。
Meta的双模型策略:Muse Wonder与Muse Spark Open
Meta本周发布了两个模型,定位截然不同。
Muse Wonder主打智能体与专业工作,官方自报的基准里部分项目超过GPT与Claude的最强型号。速度是它的强项,明显快于Gemini 4与Opus 5.5;幻觉率测试中表现诚实——面对不知道的问题更倾向承认而非编造。但第三方榜单给出的画面不那么乐观:LiveBench未进前十,MazeBench仅1%,Vals Index上更强的Muse Wonder Full也只排第五。成本方面,Artificial Analysis估算每任务约4.50美元,贵于更聪明的GPT-6 Astra与Gemini 4。目前两个版本面向Muse Code订阅者开放,API仅提供较弱的那个。
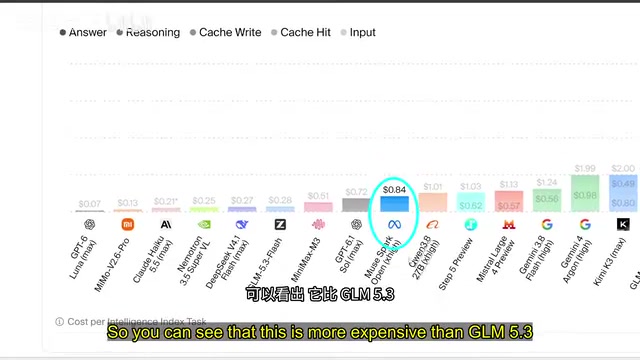
Muse Spark Open则是816B参数的MoE开源权重模型,激活参数42B,支持1M上下文。官方基准看起来不错,但Intelligence Index上它排在GLM 5.3、Step 5、Kimi K3、Mimo 2.6等开源模型之后。比性能更劝退的是使用门槛:需要提交法定姓名、出生日期、所属组织等信息,且要求在产品的用户界面显著展示“Built with Muse Spark Open”,年收入超过2000万美元需另申请商业许可。
开源图像与视频:MOSS Image、CREA 3与Kling 4
MOSS Image:Apache 2.0下的实用选择
MOSS Image约5B参数,Transformer部分仅约10GB,消费级显卡可以跑。它只做文生图,不支持自然语言编辑,但胜在出图质量和宽松许可:动漫、游戏场景、文字排版、漫画分镜、信息图表都表现良好,并支持用边界框控制构图。官方放出base与SFT两个版本,前者适合微调,后者出图质量更好。Apache 2.0意味着可商用。
作为对照,同期发布的FLUX.3 Image Klein虽然支持4K生成与编辑、边界框控制、仅5.6B参数,但实测人脸与人体结构崩坏严重,多指、肢体畸变频发;且采用FLUX社区许可,仅限非商用。CREA 3则在速度上做文章:2K分辨率生成或编辑不到8秒,远快于Nano Banana的30秒以上,能精确只改动指定元素而保留其余像素,支持最多6张参考图,目前仅在线付费使用。
MoE 架构中的总参数与激活参数
本周多款开源模型都标注了类似“600B 总参数、27B 激活”的双数字,这是混合专家(MoE)架构的典型特征。传统稠密模型每次前向计算都会用上全部参数,而 MoE 把前馈层拆成许多“专家”,由路由网络为每个 token 只挑选少数几个专家参与计算。因此总参数衡量模型的容量与显存占用,激活参数则决定单次推理的实际计算量,二者可以相差一个数量级。
这解释了一个常见困惑:为什么某些总参数高达数百 B 的模型仍能在消费级或多卡小规模硬件上运行,以及为什么参数量相近的模型推理成本可能天差地别。衡量推理开销时,激活参数比总参数更有参考价值,而总参数更多反映模型可容纳的知识上限。
Kling 4上线:进步明显但未登顶
Kling 4带来了更强的运动动态、高质量立体声、10bit HDR输出,支持最多15个参考素材与10个关键帧控制,4K分辨率在路上。初步测试的结论是:很接近,但仍不及Seedance,后者暂时还是AI视频的头名。
长视频一致性:Mosaic Chunk与Anytime Any Space
两个工作解决同一类痛点——视频模型会“忘记”暂时离开画面的物体。Mosaic Chunk引入选择性记忆机制,只保留早期帧中有用的信息并在需要时召回,实测物体被遮挡数秒后重新出现仍能保持外观一致;代码与模型已开源,文生视频版本基于MiniMax H3,图生视频版本基于Lingworld Infinity。Anytime Any Space则更进一步,直接重建场景的3D环境作为记忆,角色离开房间再回来时房间保持原样,且可与MiniMax H3、阿里Wan等不同视频模型搭配使用。
世界模型与3D:从可玩游戏到实时渲染
Matrix Game 4.0:83 FPS的单卡实时游戏生成
Skywork的Matrix Game 4.0采用混合路线:物理、运动与游戏规则交给游戏引擎,AI只负责把引擎输出的粗糙画面实时转化为精细视觉。这解决了前代AI游戏模型随时间漂移、形变的老问题——机制、场景、角色全程保持一致。它还带一个编码智能体,可以用自然语言描述新玩法并直接改游戏代码。最亮眼的数据是:单张消费级GPU上,480p分辨率下可达83帧每秒。代码与模型已放出。
世界模型与“逐帧生成”的漂移问题
文章里反复出现的“世界模型”指能够根据动作或历史观测预测未来画面的生成模型,是 AI 生成可交互环境的核心路线。纯端到端的做法是不借助任何外部结构、直接让视频模型逐帧预测下一帧,其根本缺陷在于误差累积:每一帧的微小偏差都会成为下一帧的输入,几十帧后场景几何、物体外观便逐渐漂移、形变,无法维持长时间一致性。
Matrix Game 4.0 与 NVIDIA Stream Render 的混合路线正是对这一缺陷的回应——把物理规则、空间结构等稳定信息交给传统游戏引擎维护,AI 只承担从引擎渲染的粗糙画面到照片级纹理的“风格化”转换。由于引擎提供了可信的几何与运动骨架,模型无需从零记忆场景,一致性因此得以保证,同时把生成负担降到可实时的水平。
渲染加速:NVIDIA Stream Render H3与Streaming Code World Model
两者思路相近,都是把游戏引擎的彩色编码图交给视频模型生成真实纹理与光照。NVIDIA的方案基于MiniMax H3,每段视频只需两步生成即可实时渲染——代价是演示用了8张GB200,全套模型超过200GB,单卡消费级硬件基本无缘。另一个Streaming Code World Model更省:逐段生成,每段参考前序片段与引擎最新输入,单张H200上每段耗时5.1秒,训练脚本也已开源。
3D方向还有几个开源项目:UniForge 3D从多角度照片补全完整模型,可见部分重建与缺失部分生成两个过程协同,细节保留优于对比方法;Gaussie Animate用“内骨骼+外表面”的双层表示解决衣服、毛发、软组织在传统骨骼动画下的僵硬问题;Infinisplat V2从多角度照片重建可自由浏览的3D场景,模型仅6.6GB,能处理上千帧的行车 footage。
语音、机器人与开源模型速览
Drama 3登顶开源TTS
Fish Audio的Drama 3在Artificial Analysis开源TTS榜排第一,已在Hugging Face放出。它的特色是可在转写文本中插入元标签,逐句指定语气与表达方式;35B总参数、激活仅3B,用户反馈实际运行门槛远低于参数规模暗示的水平。
全栈开源人形机器人RP1
RP1把硬件设计也一并开源:机械结构、电路图、电子部分、固件与装配文档全部公开,而不只是软件。整机支持24至42个自由度,实时控制系统跑在500Hz。配套软件支持动作模仿训练与不同AI控制策略的实验。
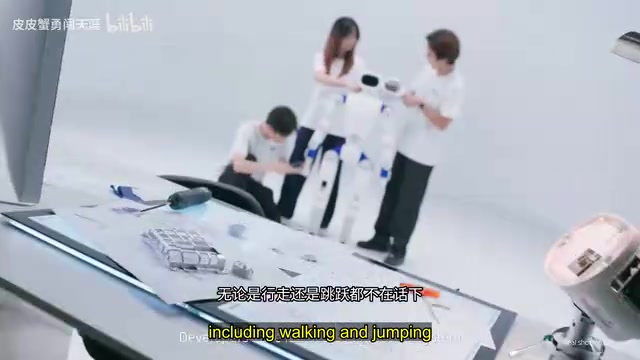
机器人演示方面,Ping Pong Duo让两台人形机器人打双打:需要预测球路、轮流击球、击球后让位再归位,靠一套协同控制系统完成,能维持相当长的回合。
开源模型密集发布
Step 5 Preview(StepFun)是600B总参数、27B激活的MoE旗舰,主攻自主编程与复杂推理,1M上下文,Hugging Face权重约650GB,Intelligence Index上略低于GLM 5.3与MIMO 2.6,API每任务约1美元,约为GLM 5.3的一半。NVIDIA Nemotron 3.5 Super VL是120B/12B激活的多模态模型,速度超过600 tokens每秒,智能水平不算顶尖但适合追求吞吐的任务,训练配方完全开源。Ling 3.1 Flash为560B/25B激活,性能接近GLM 5.3、Kimi K3与DeepSeek广告 4.1,在智能体编程与工具调用上强于同尺寸的Qwen 3.6与Gemma 4,48GB的体积和接近Apache 2.0的许可让它相对易用。
值得留意的两件事
OpenAI本周确认一名员工在会议室电视背后放置了约20美元的录音设备,设备用纸巾包裹后插入USB口,该员工已于10月9日被FBI逮捕。事件的粗糙程度(最显眼的位置、廉价的设备)让不少观察者觉得蹊跷。
学术侧,斯坦福的Next Concept Modeling提出从粗到细的生成范式:先确定整体思路与结构,再逐层填充细节,同一阶段内可并行生成多个token。在数独任务上表现突出,摘要任务上比同类扩散语言模型快最多31倍。这一思路与主流的逐token自回归形成有意思的对照。
常见问题
Gemini 4 Argon免费用户能用吗? 目前需要Pro/Ultra订阅或付费API,免费档不可用。
MOSS Image可以商用吗? 可以,采用Apache 2.0许可,base与SFT两个版本均可下载本地运行。
Kling 4比Seedance强吗? 初步测试认为接近但仍有差距,Seedance暂时保持领先。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。