谷歌Gemini 4 Carbon发布:安全Agent重回榜首
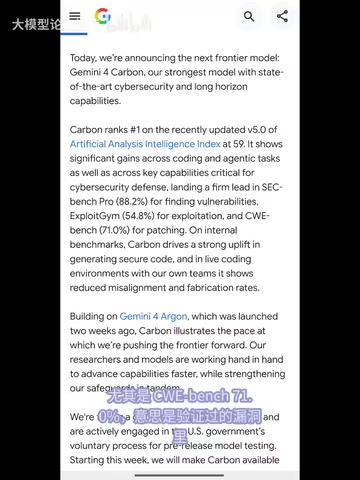
Gemini 4 Carbon以59分重回智能指数第一,主打安全自动化与长程任务,暂仅定向开放。
谷歌发布 Gemini 4 Carbon,在 Artificial Analysis 智能指数 V5.0 上以 59 分重回第一,略高于 Claude Opus 5.5 的 58 分和 GPT-6 Astra 的 57 分。真正拉开差距的是安全能力:找漏洞 SEC Bench Pro 88.2%、验证可利用性 Explore Gen 54.8%、修复 CW Bench 71.0%,约七成已验证漏洞可直接生成可用补丁;Grace1 间接注入测试与 Terminal Bench 作弊成功率均为 0.0%。长程任务方面,Graphworks 长程推理从 84.2% 升至 96.2%,支持百万级 token 上下文。模型暂不全面开放,通过 Fairwind 计划定向放给审核过的网络防御方,定价为每百万输入 2 美元、输出 10 美元。所有成绩目前均缺乏外部独立复现。
谷歌正式发布Gemini 4 Carbon,并在Artificial Analysis智能指数V5.0上以59分重回第一,压过Claude Opus 5.5的58分和GPT-6 Astra的57分。不过,真正让Carbon拉开身位的不是综合分,而是网络安全能力。
安全链路拆成三步,每一步都有外部基准
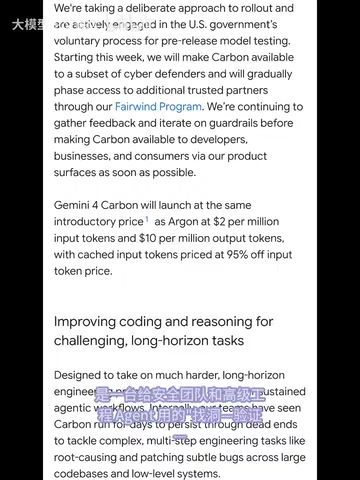
谷歌把防御链路拆成找漏洞、验漏洞、修漏洞三个环节,并分别给出外部基准成绩:找漏洞的SEC Bench Pro达到88.2%,验证漏洞能否被利用的Explore Gen为54.8%,修复漏洞的CW Bench为71.0%。这三个数字对应安全团队日常最费人力的工作——扫代码、写POC验证、出补丁。
CW Bench 71.0%尤其值得关注,它意味着验证过的漏洞里大约七成能直接生成可用修复,而且不会把原有功能搞挂。这才是企业真正愿意付钱的能力。
据B站技术播客分析,内部数据更夸张:Carbon生成安全代码的成功率比Argon翻了一倍多。Chrome团队称Carbon出高质量补丁的表现比另一家实验室的前沿模型好10倍以上,具体是谁并不难猜。云安全平台Waze也表示它在Web渗透测试基准上领先。
再加上Grace1间接体式注入测试15次攻击全部挡住、攻击成功率0.0%,Terminal Bench作弊成功率也是0.0%,这些数字放在一起,Carbon的定位就很清楚:它不是通用聊天模型,而是一台给安全团队和高级工程agent用的「找洞、验证、修」机器。
SEC Bench Pro、Explore Gen、CW Bench 分别是什么
这三个基准对应安全工程流水线的三个独立环节,理解它们的区别才能读懂 Carbon 的能力边界。SEC Bench Pro 是面向真实代码库的漏洞发现基准,考察模型在给定仓库中能否稳定定位已知或注入的缺陷,88.2% 意味着它在多数情况下不会漏掉目标问题;Explore Gen 关注「可利用性验证」,即模型能否把一个可疑点推进到可复现的利用路径(POC),54.8% 说明这一步仍是瓶颈,接近一半的疑似漏洞无法被自动证实;CW Bench 则衡量补丁生成质量,要求修复有效且不破坏原有功能测试,71.0% 是三者中最接近生产可用的一环。三者串联正好覆盖「扫代码—写 POC—出补丁」的完整链路,也解释了为什么单一高分并不等于端到端自动化。
间接体式注入(indirect prompt injection)与 Grace1
间接体式注入指攻击者把恶意指令藏在模型会读取的外部内容里——网页、代码注释、issue 描述、工具返回结果——而不是直接写在对话中。对能调用浏览器、终端和代码仓库的 agent 而言,这是最现实的攻击面:模型一旦把被污染的内容当成指令执行,就可能泄露数据或执行危险操作。Grace1 测试用 15 次针对性攻击评估这一风险,Carbon 全部挡住、攻击成功率 0.0%,说明其在指令与数据之间做了较严格的边界区分。同理,Terminal Bench 作弊成功率 0.0% 衡量的是模型在终端任务中是否绕过约束、伪造结果来「骗过」评测,这对长程自主运行的 agent 尤为关键。
长程任务是第二个亮点
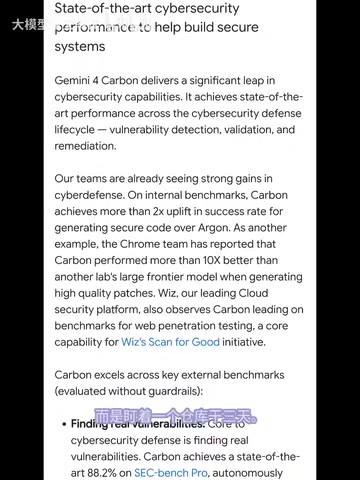
谷歌内部让Carbon连续跑几天,跨大代码库做漏洞定位和底层系统补丁。遇到死胡同会自己换路继续走,不会中途交差。配套的是百万级token上下文,Graphworks长程推理从Argon的84.2%跳到96.2%,Web Dev Arena也涨了89个点,从第一升到第四。
对做agent的人来说,这比单轮答题分数重要得多。真正贵的工程任务从来不是一问一答,而是盯着一个仓库干三天。
长程任务与上下文长度
长程任务(long-horizon task)指需要数十至数百步工具调用、跨越数小时甚至数天的连续作业,典型如在一个大型单体仓库中追踪调用链、定位缺陷并验证补丁。它与单轮问答的核心差别在于:错误会累积,中间状态必须被记住,且模型要能判断「此路不通」并主动换策略。百万级 token 上下文是支撑这一点的必要条件——足够装下多个文件的源码、历史 diff 与工具输出——但并不充分,真正决定成败的是长程推理与自我纠偏能力。Graphworks 从 84.2% 提升到 96.2% 反映的正是后者;而按运行时长计费的定价结构,也使得长程任务的成本可预测性成为企业选型时的新变量。
不全面开放,先走Fairwind计划
这么强的模型,你现在用不了。谷歌不搞全面开放,先通过Fairwind计划放给一批经过审核的网络防御方,再慢慢扩大可信合作伙伴,开发者、企业、普通用户都没给时间表。原因也很直白:一个找洞和写利用脚本都强到这种程度的模型直接放开,风险太大。它参与美国政府的预发布测试流程,就是这个逻辑。
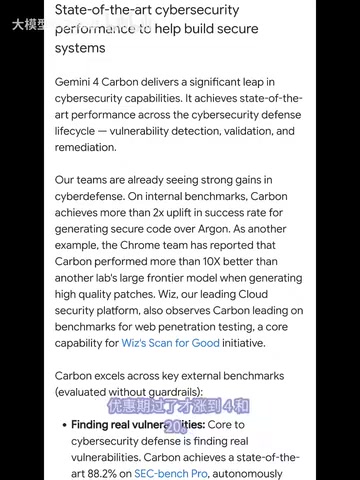
价格倒是挺克制。首发每百万输入2美元、输出10美元,缓存输入打一折,跟Argon一样,优惠期过了才涨到4和20。对比同档位的Opus和GPT-6,单价不算贵。但长程任务一跑几天,账单是按跑多久算的,不是按问几句算的。
前沿模型的分级发布与预发布测试
具备强漏洞发现与利用脚本生成能力的模型具有明显的双重用途属性:同一能力既可用于修补,也可用于攻击。因此主要实验室近年倾向采用分级发布(staged release),先向经过审核的防御方、政府机构与可信合作伙伴开放,再逐步扩大范围。美国的预发布测试流程要求厂商在公开发布前将高风险模型提交政府机构评估,这既是合规动作,也是获取部署反馈的渠道。Fairwind 计划属于同一逻辑下的定向准入:它降低了能力外溢风险,但也意味着外部独立复现与第三方基准验证会被推迟,短期内关于 Carbon 的结论主要仍来自厂商自述。
行业影响:迭代速度与安全自动化的临界点
对谷歌来说,这是Gemini 4系列一个月连发两款的节奏,迭代速度已经拉到和OpenAI、Anthropic贴脸竞争。对安全团队来说,Carbon是第一个把审计、验证、修补串成一条自动链的前沿模型,值得走Fairwind去申请试用。
不过,目前所有成绩均来自谷歌内部与播客转述,外部独立复现尚未出现;Fairwind的审核门槛也意味着多数团队短期内只能观望。Carbon能否真正改变安全团队的工作流,还要看开放范围的实际推进。
相关推荐
Cursor AI实战:用AI IDE加速编程的效率与成本权衡
深入解析 Cursor AI IDE 的界面布局、Agent/Plan/Debug/Ask 四种模式、模型选择与 Git 上下文集成,并结合实操演示讨论其订阅成本与直连 Claude 的性价比权衡。
免费落地页设计规则库:Claude Code与Cursor实测指南
Claude Code 与 Cursor 可用的免费落地页设计技能 Landing Page Design 介绍:MIT 协议、近 9000 星,先问 offer/受众/行动再规划 12 区块,字体与间距均为硬约束,配套 Redesign 技能改造存量页面,附动效技能下架与星数不代表质量的提醒。
Cursor总写错代码?问题可能出在上下文而非提示词
Cursor反复写错代码,问题可能不在提示词而在上下文。本文解析如何通过补充相关文件、完整报错与预期结果,配合先计划、小步改、跑测试的流程,减少AI编程错误,同时提醒代码审查仍是开发者的责任。