谷歌Gemini 4 Hydrogen发布:速度翻倍、成本大降,Flash路线成新王牌

谷歌发布Gemini 4 Hydrogen,速度翻倍、成本大降,战略重心转向Flash路线。
谷歌DeepMind于11月12日推出Gemini 4 Hydrogen,全面接替Gemini 3.8 Flash,同步登陆Gemini API、AI Studio、Vertex AI和Google搜索。官方数据显示,其默认High档完成任务速度是前代的2.5倍,Token消耗减少12%至23%,并新增X-High思考档位,上下文窗口维持100万Token。可靠性上编造事实减少5倍以上,Terminal Bench代码生成分数达前代3倍多,Artificial Analysis智能指数默认51分、X-High档54分,反超旗舰Gemini R-50。发布策略改为上线即全量开放,同时谷歌放弃3.5 Pro候选层,将资源集中到低成本、快迭代的Flash路线。
谷歌Gemini 4 Hydrogen发布:速度翻倍、成本大降,Flash路线成新王牌
谷歌DeepMind于11月12日正式推出Gemini 4 Hydrogen,全面接替此前的Gemini 3.8 Flash。这款模型已同步登陆Gemini API、AI Studio、Vertex AI以及Google搜索,意味着谷歌在轻量级、低成本模型赛道上迈出了关键一步。从发布策略到性能指标,Hydrogen传递出一个清晰信号:谷歌正把资源集中到"够快、够省、也够聪明"的Flash路线上。
性能跃升:速度与成本的双重突破
据谷歌官方数据,Hydrogen在默认的High思考档下完成任务的速度是3.8 Flash的2.5倍,合作方实测提速区间为2-2.8倍。更关键的是,Token消耗减少了12%到23%,这意味着在相同任务下,单位成本显著下降。
速度与成本的双重优化,直接决定了大规模调用场景的经济性。对于需要高频调用API的开发者而言,这种提升并非锦上添花,而是直接影响产品可行性的关键变量。
四档思考强度与百万级上下文
Hydrogen提供了Low、Medium、High和新增的X-High四档思考强度,让开发者可以根据任务复杂度灵活调节推理深度。上下文窗口维持在100万Token,延续了谷歌在长上下文处理上的优势。
这种设计思路体现了"按需分配算力"的理念:简单任务用低档位快速响应,复杂推理切换到X-High档位深挖。新增的X-High档位尤其值得关注,它为高难度任务提供了性能上限的扩展空间。
思考强度(Thinking Budget) 是指模型在生成最终回答前,允许进行内部推理的 token 预算上限。这一机制源自 OpenAI o1 系列引入的“推理时计算扩展”思路:模型可以花更多 token 做中间步骤的自我检查与探索,从而提升复杂任务的准确率,代价是延迟和成本上升。谷歌此前在 Gemini 2.5 系列中已将其产品化为可调参数,开发者可通过 API 指定预算档位。Hydrogen 的四档设计本质上是在延迟、成本与质量之间提供一个显式的权衡旋钮,而非让模型隐式决定。值得注意的是,低档位并不等于关闭推理,而是压缩推理链长度,因此简单任务的响应速度提升最为明显。
能力验证:编造减少、代码生成大幅提升
在可靠性方面,谷歌称Hydrogen编造事实的次数减少了5倍以上,这对企业级应用至关重要。代码生成能力上,Terminal Bench分数达到3.8 Flash的3倍多,显示出在开发者工具场景中的强劲竞争力。
在Artificial Analysis智能指数上,Hydrogen默认设置得分51,已超过谷歌旗舰模型Gemini R-50;开启X-High档后得分进一步升至54。
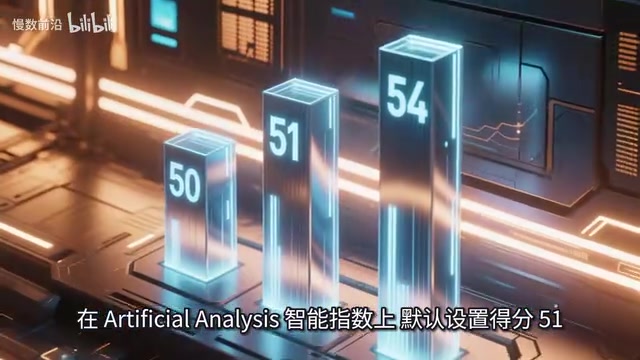
一个轻量级Flash模型在智能指数上反超旗舰,这件事本身就说明了模型架构与训练策略的进步幅度。
Terminal Bench 是一个面向命令行与终端操作场景的基准测试,评估模型在真实 shell 环境中完成多步骤任务的能力,例如文件操作、包管理、脚本调试与错误修复。它不同于偏向函数级补全的 HumanEval 或 SWE-bench,更强调模型对终端输出的解析、对环境状态的追踪以及多轮纠错能力,因此与 AI 编程助手、自动化运维代理等产品形态高度相关。在该基准上分数提升数倍,通常意味着模型在长链条工具调用中的稳定性显著改善,而不仅是单点代码生成质量的提升。
Artificial Analysis 智能指数 是由独立评测机构 Artificial Analysis 维护的综合模型能力评分,聚合了推理、知识、数学、编程等多类基准测试的结果,并归一化为单一分数以便横向比较。该指数的特点是不依赖厂商自报数据,而是自行运行标准化测试,因此在业内被广泛引用为模型能力的第三方参考。阅读此类分数时需要注意:单一聚合指数会掩盖模型在不同任务类型上的结构性差异,且评测集与训练数据可能存在重叠,因此分数更适合用于同代模型间的相对比较,而非绝对能力判断。
发布策略转向:上线即全量开放
Hydrogen打破了此前Argon、Carbon分阶段优先订阅用户的做法,上线即向所有人投放,限额也宽松得多。免费用户可直接在Gemini应用中使用,AI Pro和Ultra用户则优先在Google Sheets中体验,输出速度提升超过30%。
这种"发布即全量"的策略,反映出谷歌对Hydrogen稳定性和成本控制的信心,也说明其希望在开发者生态中快速建立使用惯性。
旗舰路线调整:资源向Flash倾斜
一个值得关注的背景是,谷歌在旗舰模型上的进展遭遇瓶颈——3.5 Pro候选层因提升不明显被放弃,资源正转向低成本、快迭代的Flash路线。这不是简单的产品线调整,而是战略重心的转移。
当旗舰模型的边际提升越来越难,而Flash路线能在速度、成本、智能三者之间找到平衡点时,把资源投向后者是理性选择。Hydrogen首次让"够快、够省、也够聪明"同时成立,这直接决定了大流量场景的单位成本结构。对于依赖AI能力构建产品的团队来说,这意味着此前因成本而搁置的高频调用方案,现在有了落地的可能。
谷歌的这一转向也给行业提了个醒:模型竞争的下半场,未必是参数规模的军备竞赛,而更可能是单位经济效率的较量。
相关推荐

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。

AI Agent编排框架实测评级:谁被高估,谁堪称传奇
一场直白的AI Agent编排框架分级评测:CrewAI与LangGraph为何被封为传奇,OpenAI Agents SDK与Agno为何只算良好,LlamaIndex、Cloudflare Agents为何被指高估,以及TypeScript开发者该选Mastra的理由。