谷歌Gemini 4 Hydrogen发布:提速2.5倍,轻量模型智能不缩水

谷歌发布轻量模型Gemini 4 Hydrogen,速度达3.8 Flash的2.5倍且智能反超旗舰。
谷歌正式发布Gemini 4 Hydrogen,补齐Gemini 4家族的最后一块拼图。这款轻量模型主打速度,任务完成速度达到3.8 Flash的2.5倍,在Agent Arena实测榜上以7.3秒拿下最快单步记录,比Claude Sonnet 5.5快2.7倍、比GPT 6.1 So快3.1倍,82%的任务可在10分钟内完成。更意外的是其智能表现:AA智能指数54分反超大哥R-的50分,打破轻量必然牺牲智能的认知。模型提供Low到High四档思考级别,按需为推理深度付费;定价为每百万Token输入1.50美元、输出7.50美元,全上下文统一价。基准上HLV Diamond达58.8%、Agents Last Exam达71.6%。AI Studio、Gemini API、Gemini App与谷歌搜索全面开放,免费用户Auto模式亦可使用。
谷歌正式发布Gemini 4 Hydrogen,补齐Gemini 4家族的最后一块拼图。这款定位轻量级的模型在速度上交出了亮眼成绩单——任务完成速度达到前代3.8 Flash的2.5倍,同时在智能测试中意外反超了自家大哥。
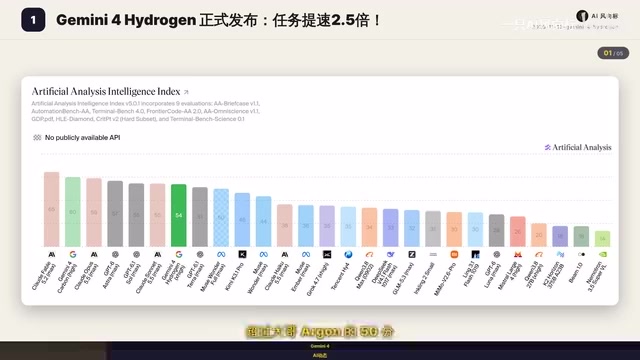
轻量不等于低智:AA智能指数反超大哥
Hydrogen最让人意外的地方在于,它走的是轻量路线,但智能水平并没有因此缩水。在AA智能指数上,Hydrogen拿到54分,超过了大哥R-的50分。这个结果打破了"轻量模型必然牺牲智能"的固有认知,也说明谷歌在模型压缩与效率优化上找到了新的平衡点。
CEO Sundar Pichai亲自官宣了这次发布,足见谷歌对Hydrogen的重视程度。Gemini 4家族三兄弟至此集齐,形成了从轻量到旗舰的完整矩阵。
AA智能指数:由独立评测机构Artificial Analysis维护的模型综合能力基准,覆盖知识问答、数学推理、代码生成、指令遵循等多类任务,最终折算为0-100的单一分数。它不依赖厂商自报数据,而是用统一题库和标准流程对所有模型做同条件测试,因此被广泛用作横向比较的参考。分数差距在数点以内通常被视为同一梯队,需要结合具体子项和误差范围解读;而轻量模型在总分上反超更大参数量的旗舰,往往意味着训练数据配比、蒸馏或推理效率上的改进,而非单纯的规模效应。
速度实测:Agent Arena榜单最快单步
速度是Hydrogen的主打卖点。对比3.8 Flash,任务完成速度快了2.5倍。第三方实测进一步佐证了这一点:在Agent Arena实测榜上,Hydrogen拿下最快单步记录,仅需7.3秒。
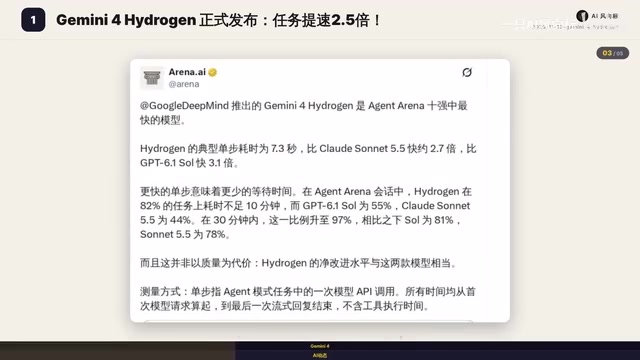
横向对比竞品,这个数字比Claude Sonnet 5.5快2.7倍,比GPT 6.1 So快3.1倍。更实用的一项数据是:82%的任务能在10分钟内完成。对于需要快速迭代的Agent场景,这个速度优势会直接转化为开发效率。
Agent Arena与“单步耗时”:Agent Arena是一个面向智能体任务的公开评测平台,让模型在真实工具调用、多轮规划和环境交互中完成任务,并记录每一步的延迟与成功率。“单步耗时”指智能体执行一次完整动作(一次推理加一次工具调用或环境操作)所需的平均时间,而非整个任务的总时长。它比总时长更能反映交互式场景的响应能力,因为智能体任务往往包含数十个步骤,单步延迟会被逐步放大。单看单步速度并不足以判断优劣,还需结合任务完成率与总轮数一起看。
四档思考级别:按需付费的推理深度
Hydrogen提供了4个思考级别,从Low到High按需选择。这个设计的逻辑很清晰——只为需要的推理深度付费。简单任务用低档位跑速度,复杂任务切高档位保质量,用户不必为用不上的推理能力买单。
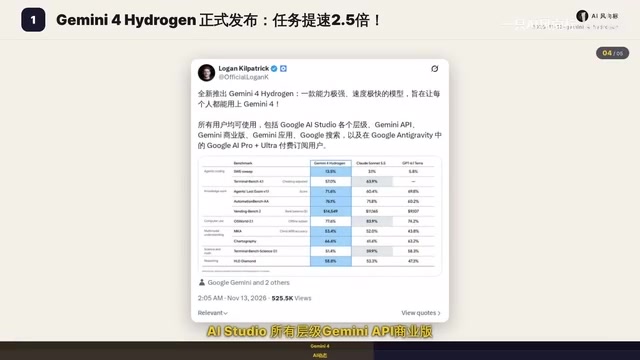
定价方面,每百万Token输入1.50美元,输出7.50美元,全上下文统一价。这个价格配合轻量模型的速度,在成本敏感型场景里具备不错的竞争力。
基准成绩与开放渠道
基准测试上,Hydrogen同样能打:HLV Diamond拿到58.8%,Agents Last Exam拿到71.6%,多项对比Claude和GPT 6.1保持领先。
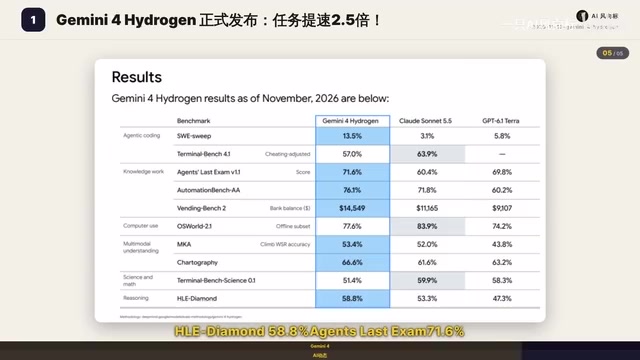
渠道方面全面开放:AI Studio所有层级、Gemini API商业版、Gemini App和谷歌搜索都能用,免费用户在Auto模式下也有份。想实测轻量模型的速度与价格账,直接打开AI Studio选Gemini 4 Hydrogen即可。
HLV Diamond与Agents Last Exam:前者是面向高难度多学科知识与推理的测试集,题目经过筛选以降低记忆型题目的比例,58.8%的得分属于中上水平;后者则聚焦智能体在长链路、工具使用和开放性问题上的一次性通过能力,71.6%意味着模型在多数复杂任务中能独立走完全程而无需人工纠偏。这类基准的共同特点是强调“一次做对”而非多次尝试,因此更能反映模型在真实生产环境中的可用性,但样本量相对有限,单项成绩的波动区间也较大。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。