谷歌Gemini 4 Neon发布:更快更省,实测对比Claude与GPT
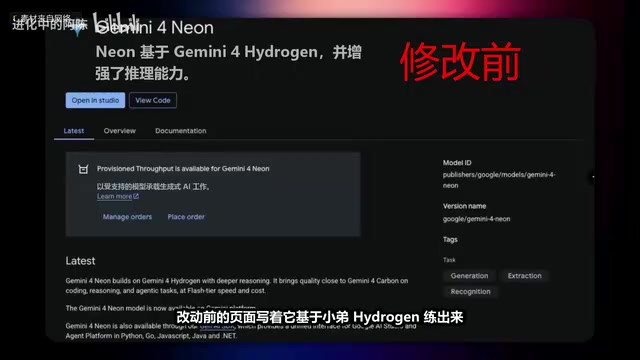
Gemini 4 Neon以中间定位和低价策略,靠工具链与思考深度调节打出性价比。
谷歌在49天内连发4款Gemini 4模型,Neon定位介于旗舰Carbon与轻量Hydrogen之间,支持四档思考深度和1048576 Token上下文,标牌单价低于Claude Opus 5.5。综合智能榜排第三,但在编程代理、长上下文和办公自动化测试中表现突出。实测显示,实际成本高度依赖输出用量与思考深度:调低一档可省超四成费用。搭配Anti-Gravity工具时,Neon通过并行子代理快速生成完整应用骨架,成本约为顶级旗舰一半;脱离工具链在网页聊天框中单打独斗则稳定性下降,需预留自我纠错余地。总体而言,它适合低成本快速成型,而非追求一次直出的极致画质。
谷歌在11月18日发布了Gemini 4系列的新成员Gemini 4 Neon。距离上一款轻量模型Hydrogen仅隔6天,算上9月30日的Argon和10月28日的Carbon,谷歌在49天内连出4款Gemini 4,后三周更是连宣3款。这种发行密度在AI模型史上相当罕见,几乎像是在照着元素周期表挨个点名。
产品定位:卡在旗舰与轻量之间的中间派
根据DeepMind模型卡,Neon是在大哥Carbon的基础上适配出来的。最重最长的硬骨头交给Gemini 4 Carbon,日常图块交给轻量级的Hydrogen,Neon专门卡在正中间。它支持低、中、高、极高四档思考深度,通过接口能同时读进文字、图片、视频、音频和PDF,输出纯文本。输入和输出共用同一块总上下文容量,为1048576个Token,相当于整套大型代码库或几百页文件一次丢给它。默认同步模式单次最多输出65536个Token,打开长输出功能还能扩到跟总容量一样大。
开放范围上,谷歌AI的Pro和Ultra付费会员先拿到推送,在Gemini网页、手机应用和开发工具Anti-Gravity里就能用上。开发者可以进AI Studio用付费接口调用,企业用户也能在Gemini for Business通过接口或模型菜单选到它。
上下文窗口与KV缓存:文中提到的"输入输出共用同一块总上下文容量",指的是Transformer类模型在推理时对上下文长度设有统一上限。模型处理每个Token时需与之前所有Token做注意力计算,计算量随上下文长度呈平方级增长。为控制成本,厂商通常将输入与输出共享同一Token额度池。缓存输入(如文中定价中的0.15美元/百万Token)依赖KV Cache机制:将已处理过的提示词对应的键值对缓存下来,后续请求复用,避免重复计算,因此价格远低于标准输入。长上下文场景(如整库代码分析)下,KV Cache可显著降低延迟与费用。
思考深度(Reasoning Effort):Neon支持四档思考深度,对应模型在生成最终答案前允许消耗的"内部推理Token"上限。提高档位会让模型花更多Token做链式思考、自我验证与工具规划,通常提升复杂任务得分,但输出Token数直接推高账单。文中实测从极高降到偏高仅损失1分,却省下36.6%输出Token,说明多数任务存在明显的"推理边际收益递减"拐点。
定价策略:标牌单价便宜,但实际花费看用量
按标准接口定价,每百万输入3美元,缓存输入0.15美元,输出15美元,不设免费接口档。单看每百万Token的标牌单价,它比Claude Opus 5.5的4美元和20美元刚好便宜四分之一。在OpenAI那边,它刚好卡在GPT 6.2 Sol的2美元和10美元与更高阶的GPT 6.2 Astra的8美元和40美元这两个价位中间。自家大哥Carbon到11月30号前还在搞2美元和10美元的限时优惠,12月1号起就会恢复成4美元和20美元的标准价。
不过,比的只是标牌单价,实测跑任务到底花多少钱还得看每次吐出多少用量。按第三方机构实测,Neon评测耗时比Carbon少了大约4成,同类任务耗时从36分钟压到21分钟——并不光靠单价吃饭。
性能实测:综合第三,但场景差异明显
综合智能榜与编程代理
在第三方机构的综合智能榜上,开启最高思考深度时,Gemini 4 Neon跑出61分排在第三,排在它前面的只剩62分的GPT 6.2 Astra和65分投名的Claude Fable 5.2。往后看,59分的Claude Opus 5.5排在它后面,57分的GPT 6.2 Sol也被它压在身下。在同一个第三方机构的编程代理指数榜上,谷歌公告写道Neon拿了58.6分,发布时排在第一。
另一组专测实际工作能力的Valse指数2.2版,Neon拿了70.9%排在第二,同一张官方表里Claude Opus 5.5拿了70.1%,GPT 6.2 Sol则是66.1%。在Valse的独立评测页面上,Neon在法律研究和税务代理这两项都排到第一。
代码单项强弱分明
细拆官方表里的代码单项,强弱就很清楚。编辑器辅助编程测试Cursor Bench 4.1里,Neon跑出65.4%,明显高过Opus 5.5的58.1%。到了终端命令行编程测试4.1,Neon拿了65.2%,跟Opus 5.5的65.8%几乎咬死,同一项里GPT 6.2 Sol只考到61.5%。换到更硬核的仓库代码测试Frontier Code 2.0,Neon得分是46.2%,略微落后于Opus 5.5的47.3%,但还压着43.8%的GPT 6.2 Sol。
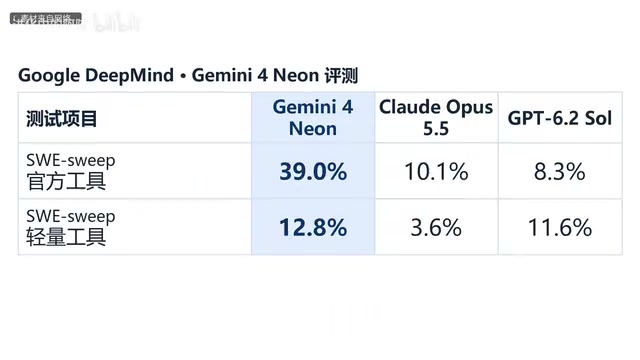
代码修复测试SWE Sweep更能说明工具环境的影响:同一个Neon只挂轻量工具得分只有12.8%,一换进谷歌自家的Anti-Gravity环境里跑,成绩直接拉到39.0%——模型本身是一回事,配的干活工具能不能跟上,分数能差出三倍多。
办公自动化与长程任务优势明显
转到办公自动化和长程任务,优势就明显些。自动化流程测试Automation Bench上,Neon跑到56.3%,比42.5%的Opus 5.5高出一大截,GPT 6.2 Sol也只有41.3%。代理综合大考1.1版里,Neon拿了75.8%,同样得分压过Opus 5.5的71.6%以及73.0%的GPT 6.2 Sol。
多模态与长上下文反差强烈
视频理解测试LV Bench上,Neon拿到89.0%,高过Opus 5.5的83.7%,也压过87.6%的GPT 6.2 Sol。拉到长上下文测试GraphWalks,Neon直接拿到95.2%,甩开66.8%的Opus 5.5,GPT 6.2 Sol这项则是80.1%。当然,这几组百分比各自测的是不同任务,得一项一项分开看。
编程代理指数与Valse指数:编程代理指数(Agentic Coding Index)衡量模型在真实开发环境中自主完成多步任务的能力,包括读取仓库、定位bug、修改代码、运行测试并迭代。与单轮代码补全不同,它强调工具调用与长程规划,因此同一模型在不同工具环境(如普通沙箱 vs Anti-Gravity)中得分可能相差数倍。Valse指数2.2版则聚焦"实际工作能力",覆盖法律研究、税务代理等知识密集型流程,评估模型在专业工作流中的任务完成率与准确性。两者均属第三方综合评测,但侧重点不同:前者看代码落地,后者看业务流程。文中Neon在编程代理指数拿58.6分排第一,而在综合智能榜仅排第三,正说明不同评测维度下模型排名会显著分化。
成本真相:思考深度决定账单
最实用的一组对比跟思考深度有关。有实测把Neon的思考深度往下调一格,从极高降到偏高那一档,综合分只从61掉到60,几乎没差,可输出Token数一下子少了36.6%,每个综合评测任务的平均花费也从6.44美元降到3.74美元,省了超过四成。前面提到积木动画反倒花得多,若输出一膨胀,账单照样往上跳。
输出Token与推理Token的计费关系:大模型API按输入Token和输出Token分别计价,输出单价通常是输入的数倍(文中Neon为3美元 vs 15美元,5倍)。关键在于,模型内部推理消耗的Token同样计入输出账单——即使这些Token不直接呈现给用户。因此,当模型把大量输出用于"自言自语"式推理而非产出可用代码或文本时,实际成本会远超按标牌单价估算。文中中世纪战场一例,Fable 5.2有42.7%输出耗在推理上,最终仅落地1034行代码,而Neon仅16.3%用于内部推理,落地5138行,这解释了为何单价更低的模型在单任务上反而可能更贵。选型时应关注"有效输出比"而非仅看每百万Token标价。
Anti-Gravity加持:并行子代理与快速成型
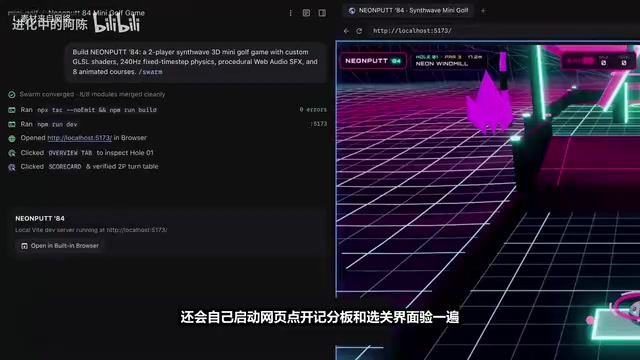
既然单拼蛮力容易费钱,谷歌这回真正拿来替Neon提效的是自家开发工具Anti-Gravity。在这个工具里打开并行派活功能,接到一个带240Hz物理碰撞音效和8个动画关卡的三维迷你高尔夫需求,Neon没自己从头写到尾,它分出8条并行分支(行话叫子代理)同时开工——写物理规则的、做光影渲染的、拼关卡和按钮界面的各管一摊,5分钟零报错合并,还会自己启动网页点开计分板和选关界面验一遍。
同一套路子挂进三维建模软件Blender,谷歌还放了几段拿来证明能力的样例:Neon顺着自家家族的名字在里面建了一整张化学元素实验台,接上高压变压器点亮代表自己的奶器玻璃管;又抓取1936年剑桥国王学院的老照片做参考,把计算机先驱艾伦·图灵当年的书房和那台图灵机建了出来;还用阿尔卑斯山博朗峰和侠木尼的真实地形数据做了一个不用装客户端、浏览器里就能玩的第一人称三维滑雪模拟,滑下雪坡时雪板、雪崖和地面的光影实时跟着走。
子代理(Sub-agent)并行架构:Anti-Gravity中的"并行派活"是一种多代理编排模式:主代理将复杂需求拆分为若干独立子任务,分发给多个子代理同时执行,最后汇总合并。每个子代理拥有独立上下文与工具权限,可并行写物理规则、渲染、UI等模块,从而压缩 wall-clock 时间。该模式对模型的要求不仅是单次生成质量,更包括任务分解合理性、接口约定遵守与合并冲突处理能力。文中Neon分出8条并行分支、5分钟零报错合并,体现的是模型在结构化协作中的规划能力,而非单纯代码生成速度。这也解释了为何同一模型在挂载工具后得分远高于裸跑——工具链实质扩展了模型的"手"和"工作记忆"。
真实擂台:与Claude Fable 5.2的硬碰硬
三维积木动画:单价便宜却多花了钱
第一场对照拉上眼下评分最高的Claude Fable 5.2,同题做一段三维积木忍者动画,火系、电系、冰系和暗影特效角色轮番上阵,最后六名忍者合体摆造型。动作和光影两边看着都不差,可结账数字反倒让人意外:跑完这一整套,Neon累计花了12.93美元,对面的Fable 5.2却只用了11.19美元。明明单价便宜一截,怎么第一场同台反而多花了一块七毛多?
中世纪战场:半小时限时对拼
这一次还是找上Claude Fable 5.2,但立一条公平规矩:两边都在最高思考深度下单独硬干,用网页三维工具3JS搭同一个中世纪战场,各限时30分钟。画面放一块比,这一局试拍给出的画质评价更偏向Fable 5.2那边的弓兵劣阵、火光和远处城堡轮廓确实更细;Neon这边红衣兵阵拉弓放箭、漫天火箭尾击和举盾反击全做了出来,但拉近看材质质感还是稍微糙一点。
可只要翻开后台运行账本,局势就彻底反过来了。30分钟一到,Neon写出了5138行代码,体积181.3KB,它的总输出里只有16.3%用在内部推理上,绝大部分力气都在往外写可用代码;对面的Fable 5.2却有42.7%的输出量耗在了漫长推理上,等于快一半输出量都在推理上,最后只落地了1034行、78.8KB。结账这步反差更明显:Fable 5.2的工具末尾10报花掉10.35美元,Neon这边工具不自动算总额,对照用量按官方单价估下来大约只要5.07美元,几乎省了一半。
这种先猛铺代码、靠高输出快速成型的路子,落到做网页和交互游戏上特别管用。连着生成7套不同风格的网页——从随滚动卡点的机械钟表风网页、能切比例的几何彩图工具、黑底极简系统页、浅色电商产品卡片,到撞色动态网格排版、支持360度拖拽看热点的黑底耳机详情页,再到带滚动数字卡的数据叙事页面——排布和交互都能稳稳咬合上,不再像半成品那样虎头蛇尾。
搬进Anti-Gravity里,它甚至一气做出了个使命召唤风格的三维射击游戏,沙漠小镇里左上角带方位的小地图、击杀播报、滑铲下蹲、切主副枪、连开红点镜、换弹提示加上重弹掉血全做齐了,只是细看墙面贴图还是偏素。按测评方的经验判断,想要一上手就精致到顶,可能还是更贵的Opus这类模型更稳,但用Neon低成本先搭出能跑能玩的完整骨架再拿去精修,已经是相当实用的做法。
矢量绘图与三维场景
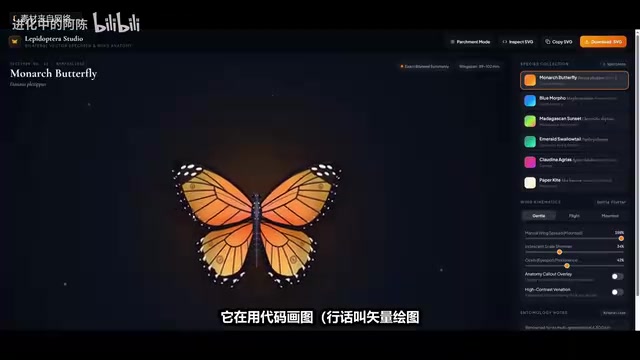
不光写应用和游戏,它再用代码画图——行画叫矢量绘图,怎么放大都不糊——这块功底也很稳。从能切品种扇翅膀的粉紫蝴蝶标本、带昼夜时间轴的纽约港湾天际线,到装在画框里的灯笼湾夜景,线条和光影层次都做得很细。
同题画一个黑色游戏手柄,先拿去跟GPT-6.2 SOAR摆在一块,再把自家的Hydrogen放底下做参照,实测评价最认可Neon的立体造型和按键渐变光影。紧接着和Opus 5.5同题拼一张双层生态水城,水面倒影、转动风车到飞艇船只细节铺得更满,测评方同样认为这一版胜过Opus 5.5。就连AI圈公认专考图形结构理解的“提湖骑自行车”名题,不少模型连静态简笔画都长画歪,Neon却交出了一整段卡着节奏、一群角色排成纵队往外冲的动效短片。
这股画面掌控力延伸到大型三维场景里就更看得出功夫。在Anti-Gravity里把思考深度拉到最高,一条指令不加追问跑了39分钟,Neon交出了一段东京雨夜——第一人称走在霓虹闪烁的雨巷里,路面水蛙能清楚映出两边日文灯牌的彩色倒影,街边还有发光自动售货机和撑红伞的路人。紧接着这部至秋送动画短片更是让实测作者直呼惊艳:他拿英国诗人1819年的同名长诗做灵感,全靠最基础的原生网页脚本代码,没借任何现成三维工具库,从麦田野花铺开的土路开场,穿过挂满苹果和葡萄藤的果园农舍,走进古仓再顺着收割了一半的麦田小路向前,趟过小溪,在粉紫晚霞和满天飞燕里收尾,连风声虫鸣和全程英文朗诵都一并配齐。
单打独斗:离开工具还剩几成功力?
不过这些大场面大都离不开Anti-Gravity这套开发工具撑腰。要是退回普通人平时用得最多的Gemini网页聊天框里,不挂工具单打独斗,它还剩几成功力?拿《我的世界》那种经典的带光影方块沙盒题目上聊天窗直视,结果就很真实:没能一把成,第一次生成的代码首尾多带了两段多余的格式符号,网页一跑就语法报错,得让它自己改过一遍才顺畅打开。好在改通之后,进到世界里白天黑夜的光影切换、敲方块搭建筑,甚至潜进水底看波纹透光全做出来了,只是菜单里翻来覆去死活没找见能打怪求生的生存模式。
该不该把它当主力?
把这些实测摆在一块看,Gemini 4 Neon的真实斤两其实很清楚:单论一次直出的极致画质和细节打磨,它还没全面压过Claude Fable 5.2和Opus 5.5,做三维积木动画甚至可能花得比对手更多;退回普通网页聊天框跑大项目,也还是得留出一次让它自己改错的余地。可只要给它配好开发工具,或者把思考深度调到偏高那一档去干重活,在这场现实战场里,它用将近一半的成本先把可跑的完整骨架甚至大场面搭出来,性价比确实摆在那里。
如果平时让你挑一个主力助手帮着写小工具、搭网页原型,你会图它更快更省,拿这个中间派当常用主力?还是宁愿多等一会儿,继续死磕最贵的顶配旗舰?
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。