谷歌Gemini 4 Neon发布,腾讯混元Hy4 Flash开源|AI日报

谷歌Gemini 4 Neon主打复杂工程计算,DeepSeek、腾讯、蚂蚁与OpenAI各有动作,厂商路线分化清晰。
文章汇总了近期AI领域的四项进展:谷歌发布Gemini 4 Neon,定位复杂工程与科学计算,Values指数70.9%排第二、Automation Bench 56.3%第一,定价输入3美元、输出15美元每百万Token,上下文100万;DeepSeek自11月18日中午起将模型自调用的联网搜索与网页抓取改为免费,仅按Token计费,独立接口仍为5元每1000次;腾讯开源Hy4 Flash(约220B总参数、激活约11.3%、100万上下文),蚂蚁开源Ming 3.0 Audio Flash(126B总参数、激活6.5B、语音推理榜99.8%第一、MIT协议);OpenAI让模型改写AMD旗舰芯片RTL代码,最高带来14% PPA提升,约一年工作量不到5个月完成,部分已送流片。作者据此指出厂商路线分化:谷歌抬升高价值任务定价,国内厂商压成本扩上下文,OpenAI深入芯片设计等专家级环节。
谷歌发布Gemini 4 Neon:补上复杂工程与科学计算的拼图
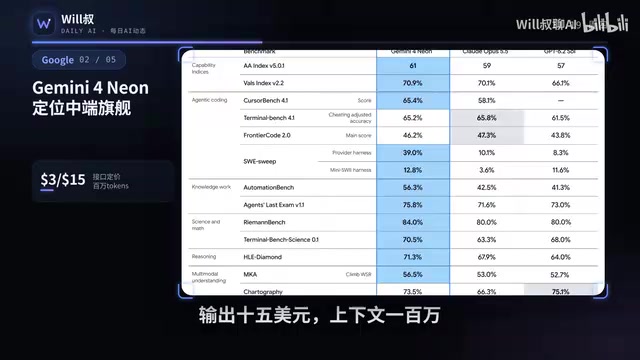
谷歌正式推出Gemini 4 Neon,定位介于Hydrogen与Carbon之间,专攻复杂工程、知识工作与科学计算场景。定价为每百万Token输入3美元、输出15美元,上下文窗口达到100万Token。
从基准表现看,Neon在Values指数上拿到70.9%位列第二,Automation Bench以56.3%排名第一,长上下文测试Graphworks则达到95.2%。这组数据的含义值得拆开看:Values与Automation两项分别对应价值判断与自动化任务执行,说明Neon不只是「更聪明的聊天模型」,而是朝可托付的工程助手方向走。目前AI Studio、Anti-Gravity以及Gemini应用的Pro、Ultra用户已可直接使用。
上下文窗口与Token计费
上下文窗口指模型单次调用能够处理的输入加输出Token总量上限,100万Token大致相当于数十万汉字或数百页技术文档。对工程与科学计算场景而言,长上下文的价值在于可以把整套代码库、设计文档、实验数据一次性放入提示,避免反复切片与信息丢失。
Token是模型处理文本的基本计量单位,计费按输入与输出分别定价是当前主流做法,输出通常更贵,因为解码阶段逐Token生成的计算开销更高。文中「输入3美元、输出15美元」的价差体现了这一规律,也意味着长文档分析类任务(输入多、输出少)的实际成本会明显低于长篇生成类任务。
DeepSeek把联网搜索与网页抓取改为免费
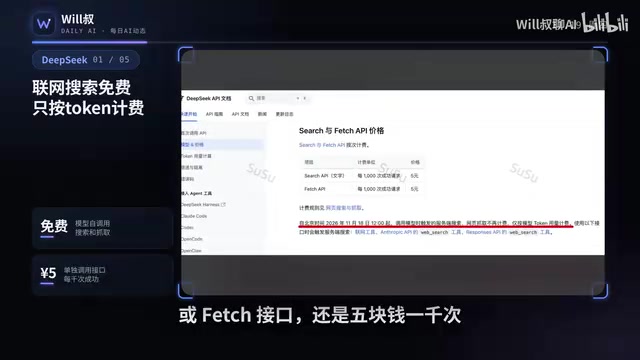
开源侧的第一个动作来自DeepSeek广告。从北京时间11月18日中午起,模型自己调用的联网搜索和网页抓取全部免费,只按Token计费;如果开发者单独调用官方Search或Fetch接口,仍按5块钱1000次计费。需要注意的是,抓回来的网页内容依旧会计入Token消耗。
这一调整的实际影响在于成本结构:过去「搜索+抓取」是独立账单,现在被并入Token体系,对高频调用联网能力的Agent类应用来说,账单可预测性明显提升。
腾讯混元Hy4 Flash开源,蚂蚁Ming 3.0 Audio Flash同期跟进
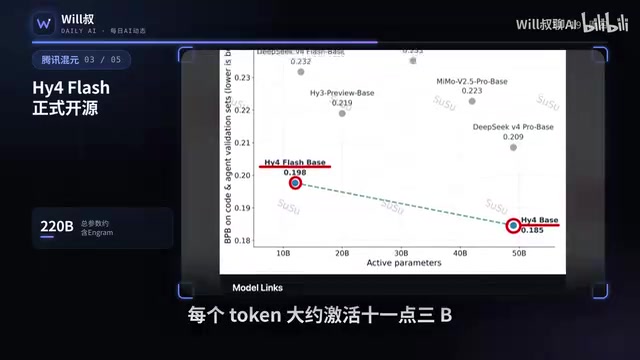
腾讯混元正式开源Hy4 Flash,指令版、FP8版本和基座一起放出,总参数约220B,每个Token大约激活11.3%,支持图文输入与100万上下文。稀疏激活的设计意味着推理成本与总参数规模解耦,长上下文场景下的性价比是它的主要卖点。
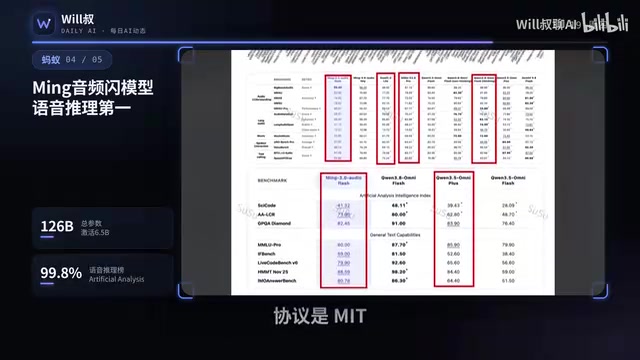
蚂蚁同期开源了Ming 3.0 Audio Flash,总参数126B、激活6.5B,在Artificial Analysis的语音推理榜上以99.8%排名第一,协议为MIT。MIT协议对商用友好,这类音频模型的开源对整个语音交互生态是实质利好。
稀疏激活与MoE
文中「总参数约220B,每个Token大约激活11.3%」描述的是混合专家(MoE,Mixture of Experts)架构的典型特征:模型包含大量专家子网络,但每次前向计算只路由到其中少数几个,因此实际参与运算的参数远小于总参数。这种稀疏激活使得推理成本主要由激活参数量决定,而非总参数量,从而在保持大容量知识存储的同时控制单次推理开销。
对长上下文场景而言,稀疏激活的意义尤为明显:上下文越长,注意力计算与缓存压力越大,若每次推理都要调动全部参数,成本将迅速攀升。稀疏激活让模型能够以较低的单Token成本处理100万级上下文,这也是Hy4 Flash把「长上下文性价比」作为主要卖点的技术基础。
OpenAI让模型改写AMD旗舰芯片RTL代码
OpenAI公布了一项硬件侧的结果:模型直接改写AMD旗舰芯片的RTL代码,最高带来14%的PPA(功耗、性能、面积)提升,原本约一年的优化工作不到5个月完成,其中一部分已经送去流片。同样的方法也在自研的 Payne 芯片上完成了硅片验证。
这条消息的分量不在「AI写代码」,而在闭环——从代码生成到流片验证走通了,说明模型在寄存器传输级这种强约束、强验证的工程环节具备可用性。对芯片设计行业来说,PPA是硬指标,14%的提升不是修辞。
RTL与PPA的背景
RTL(Register Transfer Level,寄存器传输级)是芯片设计中的关键抽象层,用硬件描述语言(如Verilog、SystemVerilog)描述寄存器之间的数据传输与逻辑运算,是连接架构设计与物理实现(综合、布局布线)的中间环节。RTL代码的质量直接决定后续流片成败,且改动必须经过严格的功能验证与时序验证,因此传统上由资深工程师人工优化,迭代周期长、门槛高。
PPA(Power, Performance, Area,功耗、性能、面积)是衡量芯片设计优劣的核心指标体系:功耗决定散热与能效,性能决定工作频率与吞吐,面积决定制造成本。三者往往相互制约,优化本质是多目标权衡。业界通常以PPA改善幅度作为硬性验收标准,因此文中14%的提升需要放在该语境下理解——它不是语言层面的修辞,而是可量化的工程指标。
几点观察
把这几条放在一起看,路线分化相当清晰。谷歌在往「高价值复杂任务」上抬价,每百万Token输出15美元的定价对应的是工程与科学场景的付费意愿;DeepSeek和腾讯混元在压成本、扩上下文,争的是开发者调用量;OpenAI则把模型推进到芯片设计这种传统上由专家把关的深水区。
对开发者而言,当下的选择比半年前更实际:需要长上下文与图文混合输入,Hy4 Flash是开源可选项;需要联网检索类Agent,DeepSeek的计费方式更友好;需要处理复杂工程推理,Neon的基准数据提供了参考坐标。
相关推荐

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。

15年经验程序员失业两年:AI时代的技术人困境
一位15年经验的美国高级软件工程师失业两年,积蓄耗尽,求助Hacker News。本文分析技术人长期失业的结构性原因、简历空窗期的应对策略,以及AI时代经验价值的重新定义。

Anthropic上市后,安全优先还能走多远?
The Verge 播客讨论 Anthropic 上市后的核心矛盾:作为上市公司,Anthropic 是否还能坚持安全优先?本文分析公开市场压力如何重塑 AI 实验室的安全决策,以及值得关注的治理信号。