谷歌Gemini Omni 1.2 Flash视频模型发布:价格降37%

谷歌、OpenAI、Mistral与英伟达密集发布更新,企业AI竞争转向工作流效率与单位成本。
文章汇总了11月5日至6日多家AI厂商的集中发布:谷歌推出Gemini Omni 1.2 Flash视频生成模型,支持最长15秒、按秒设置时长,20P视频每秒0.07美元,降价37%;OpenAI发布网络安全模型GPT-6Cyber,远程漏洞利用基准得分48.5%,并发现81个高危漏洞;Mistral更新企业平台并推出Large 4(LeTron),新增托管智能体、可视化编排与可观测性;英伟达开源4个约160亿参数的Cosmos世界模型,并公布VIR处理器在智能体负载下的能效优势。文章认为,竞争焦点正从单一模型能力转向工作流效率、单位成本与混合部署能力。
谷歌在11月6日凌晨发布视频生成模型Gemini Omni 1.2 Flash,面向开发者API、谷歌云端和企业服务全面开放。官方称新版本原生支持最长15秒视频生成,比上一版多出5秒,并允许按秒设置3到15秒之间的时长。价格方面,20P视频每秒0.07美元,较上一版下调37%。
视频生成能力升级与定价策略
新模型的工作流设计强调迭代效率:先用较低分辨率快速出草稿,再通过多轮对话修改细节,最后升到1080P甚至4K。官方表示角色、商品和品牌风格在镜头切换之间的一致性更强,适合虚拟试穿、商品展示和品牌广告等场景。这一定价与能力组合,明显在向高频商用场景靠拢。
网络安全模型GPT-6Cyber亮相
OpenAI在11月5日下午发布专门的网络安全模型GPT-6Cyber,用于发现并验证可被利用的漏洞,且限定在研究人员设定的范围内工作。按照OpenAI安全框架,该模型的网络安全能力被评为“零届级”,上一代为“高级”。官方测试显示,它在远程漏洞利用基准上得分48.5%,比上一代高出约16个百分点;在开源软件上找到81个被火狐浏览器开发商评为高危的全新漏洞,并给出可复现的测试和补丁建议;还针对948个内核漏洞生成了可用的利用样本。
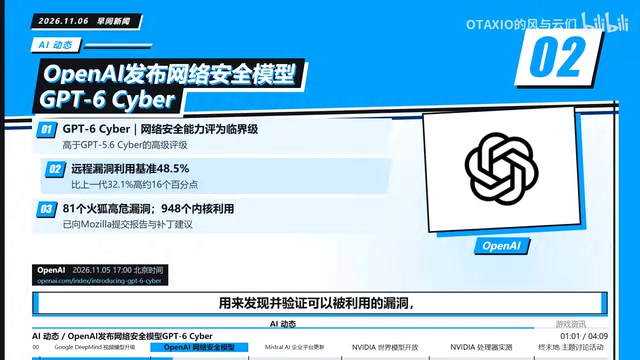
远程漏洞利用基准(remote exploitation benchmark)是评估AI模型网络安全能力的一类标准化测试集,通常包含若干已知漏洞的目标程序或环境,要求模型自主完成从漏洞识别到构造有效利用载荷的完整链路。得分率反映模型在无人工干预下成功利用漏洞的比例,因而被用作衡量模型“攻击性能力”的量化指标。正因为此类能力可能被滥用,OpenAI将其纳入分级安全框架,并按能力等级决定发布策略与访问限制。
Mistral企业平台更新与LeTron模型
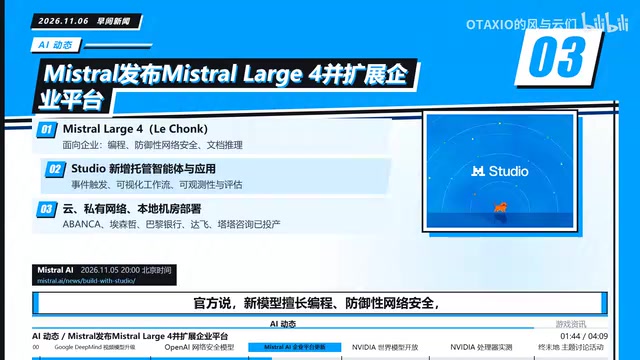
法国AI公司Mistral在11月5日晚发布企业平台更新,同时推出新模型Mistral Large 4(代号LeTron)。官方称新模型擅长编程、防御性网络安全以及复杂文档和业务任务的推理。企业平台新增托管智能体和应用工作流,支持由企业系统事件触发、可视化编排,被中断的运行可以接着继续,还加入了企业智能体可观测性和评估能力。平台可部署在云端、企业自由网络、本地机房或混合环境。
英伟达开源Cosmos世界模型与VIR处理器实测
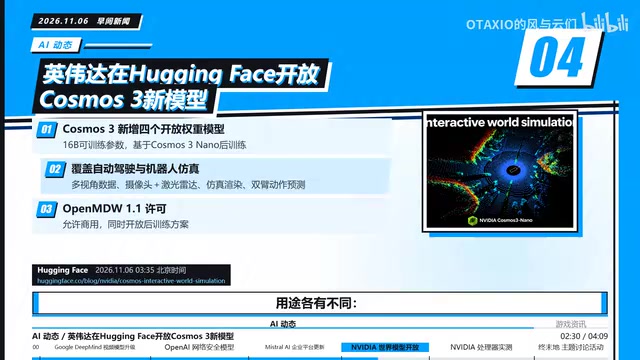
英伟达在Hugging Face发布博客,为Cosmos 3世界模型家族新增4个开放权重模型,每个模型约160亿可训练参数,均基于Cosmos 3 Nano做后训练得到。用途各有不同:有的能生成不同天气、光照和时段的多视角自动驾驶数据;有的能同时输出摄像头画面和激光雷达观测;有的把仿真器里的控制信号渲染成接近真实的视频;还有的根据双臂机器人的动作预测接下来的画面。官方采用允许商用的开放许可,公开权重的同时也放出了后训练方案。
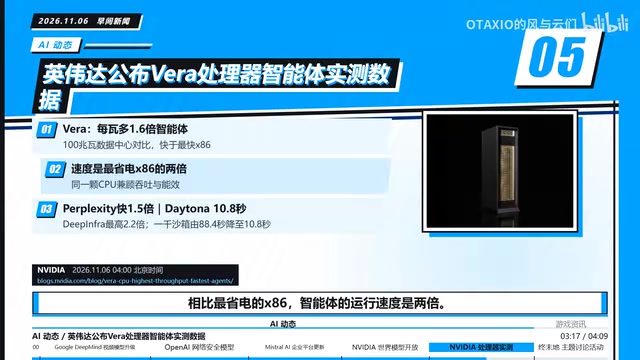
英伟达另一篇博客介绍VIR处理器在智能体工作负载下的实测表现。官方称在一座100兆瓦数据中心的对比中,单颗VIR同时优于最快的x86处理器和最省电的x86处理器:相比最快的x86,每瓦能支持的智能体数量多60%;相比最省电的x86,智能体运行速度是两倍。合作方测试里,搜索公司Perplexity的智能体编程任务快了50%,并计划在后续生产系统部署;云服务商DeepInfer的智能体编排最高快2.2倍,也计划在后续生产系统部署;数据平台Datana把1000个智能体沙箱上线的时间从88.4秒缩短到10.8秒。
世界模型(world model)指能够学习并预测环境状态如何随动作演化的生成式模型,它与普通视频生成模型的区别在于强调对物理动态、视角变化和动作后果的建模。在自动驾驶场景中,世界模型可依据控制信号合成多视角、多传感器数据,用于扩充训练集和闭环仿真;在机器人场景中,它可根据关节动作预测下一帧画面,从而支持规划与策略学习。开放权重则意味着研究者可自行部署、微调和评估,降低了对闭源API的依赖。
每瓦智能体数量与智能体运行速度是衡量智能体负载能效的两个互补指标:前者反映在给定功耗预算下可并行承载的智能体实例规模,后者反映单个任务的完成时延。相比传统以吞吐或浮点算力为主的评测,这类指标更贴近智能体工作负载中大量短时、高并发、依赖工具调用的特征。数据中心的兆瓦级对比则将芯片级能效换算为整机架乃至整园区的部署容量,便于企业评估总拥有成本。
游戏社区活动同步开启
周末地英文官方在11月5日晚发布话题讨论活动,围绕干员名颌和汤汤各设一个主题。玩家选择其中一个主题分享想法即可参与,活动结束后从成功参与的管理员里随机抽50人,每人送出500枚游戏内货币。活动从北京时间11月5日晚开始,到11月20日晚上11点59分结束,具体参与方式和规则需到官方Discord服务器查看。
行业观察
从这批更新看,AI基础设施的竞争正从单一模型能力转向工作流效率与单位成本。谷歌用降价和更长视频时长争夺商用视频生成市场,OpenAI把安全模型的能力边界框定在受控研究环境,Mistral则把智能体编排和企业部署灵活性作为卖点。英伟达同时押注开放世界模型和专用处理器,试图在智能体负载上建立能效优势。多源信息交叉显示,企业级AI的落地重点正在向可观测性、可中断续跑和混合部署迁移。
可观测性(observability)在企业智能体语境下,指对智能体运行轨迹、工具调用、决策链路与资源消耗进行记录、追踪和评估的能力,类似传统软件中的日志、指标与链路追踪。可中断续跑则要求智能体执行长时间任务时保存中间状态,在异常或人工干预后从断点恢复,而非从头重跑。混合部署指同一平台可运行在公有云、企业私有网络、本地机房等不同环境,以满足数据合规与延迟要求。这些能力共同构成企业级智能体从演示走向生产的关键门槛。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。