谷歌TabFM:表格数据的"GPT-3时刻"来了

谷歌TabFM让表格数据无需训练直接预测,LLM智能体弥补其语义盲点,共同构成新一代表格AI架构。
谷歌研究院发布的TabFM是专为表格数据设计的基础模型,其核心突破是将用户数据集本身作为"提示词",通过单次推理完成预测,彻底绕开了传统机器学习"每个问题训练一个模型"的繁琐流程。TabFM完全基于合成因果图训练,学到的是跨数据集泛化的元算法,代价是无法理解列名的语义含义。为此,TabFM Auto架构引入LLM智能体负责语义解析与特征转换,两者协同在Tab Arena基准上达到顶级水平。生产级落地还需要三个关键支撑:将数据字典存为列注释实现语义接地、用可秒级创建的数据库隔离分支保护生产数据、以及通过时间戳回溯防止数据泄漏——这套组合共同预示着表格数据处理方式的根本性转变。
当所有人都在追逐LLM,表格数据被忽视了
当下的AI热潮几乎全部围绕编程智能体和聊天机器人展开,大语言模型(LLM)确实在处理文本上表现惊艳。但如果审视真实的商业世界,你会发现驱动企业运转的核心并非文本,而是传统的表格数据——交易记录、客户流失、传感器日志、欺诈索赔、库存信息等等。
问题在于,当你需要从一张表里预测某个结果时,LLM并不适用。至今大多数团队仍然依赖经典机器学习方法,尤其是梯度提升树(Gradient Boosted Trees)。而这种工作流的致命缺陷是:每遇到一个新问题,就得从零训练一个全新模型。清洗数据、手工做特征工程、训练模型、调超参数,然后换个数据集再把这套苦力活重复一遍。
文本领域曾经也是这样——情感分析一个模型、垃圾邮件分类一个模型、翻译又一个模型。直到GPT-3出现,一切都变了:你不再训练独立模型,只需在提示词里给基础模型几个示例,它就能神奇地搞定一切。而表格数据一直缺少这个"GPT-3时刻",直到现在。
TabFM:把数据集本身变成提示词
谷歌研究院近期发布了TabFM,一个专为表格数据打造的基础模型。它最颠覆之处在于:你根本不需要用自己的数据集去训练它。
做法极其简洁——把你已经知道标签的行传进去,再附上你想预测的无标签行,模型会利用已标注数据,在**单次推理(single pass)**中直接推断出答案。换句话说,你的数据集本身就成了提示词。这本质上让TabFM成为了表格领域的通用基础模型。
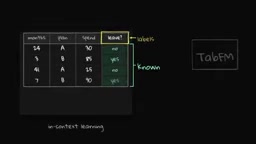
谷歌是怎么做到的?研究团队完全使用无穷无尽的合成数据(本质是合成表格)来训练模型。对每一张表,他们采样一个随机因果图(causal graph),据此生成行数据,并强制模型预测被遮盖的单元格。这样做的妙处在于:模型无法记住任何特定数据集,它学到的是"如何从表格中学习"这一元算法(meta-algorithm)。
需要提醒的是,目前TabFM的权重仅限非商业研究用途。因此更应把它视为一张架构蓝图,而非可直接投产的代码。
TabFM所采用的推理范式在机器学习领域被称为上下文学习(In-Context Learning,ICL),这一概念最早在GPT-3中被系统性展示。其核心思想是:模型在推理阶段通过输入中提供的"示例-答案"对来推断新样本的输出,而无需更新任何模型参数。对于表格数据而言,这意味着将已知标签的行作为"示例"拼接在待预测行之前,模型通过注意力机制在这些行之间捕捉统计规律,完成预测。合成因果图的训练方式迫使模型学习的不是特定数据集的分布,而是"给定若干样本,如何归纳变量间因果依赖关系"这一更普适的能力——这正是其能在从未见过的真实数据集上泛化的根本原因。
实战:零特征工程预测客户流失
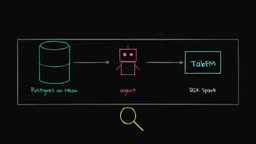
基础模型只是故事的一半,另一半在于你的实时数据存在哪里,以及如何给智能体一个可操作的运行环境。在本次演示中,数据存放在基于Neon的Serverless Postgres里,TabFM在本地的DGX Spark上运行,智能体直接对数据库引擎执行操作。
演示用的是一份合成的SaaS公司数据,包含客户画像、产品使用、发票和工单,目标是预测哪些客户会流失。流程是:从Neon拉取原始客户表,把标签历史喂给TabFM,让它为剩余用户打分——全程没有任何训练环节。
结果颇具说服力:在单张表、零特征工程的条件下,TabFM的表现已经超过了作者此前精心调优的树模型。不过0.60的分数本身并不算高,这恰恰暴露了TabFM的一大局限。
TabFM的软肋:它看不懂列的语义
由于TabFM完全在合成的因果图上训练,它在训练过程中从未见过任何列名或标签。这意味着它不知道各列之间的区别——一列可能代表月度消费,另一列可能是温度,但在模型眼里全都只是数字。
可现实中的表格充满语义含义:某列用1、2、3代表不同事件类型,0可能表示"未测量",缺失值可能用特殊标记表示。TabFM无法理解这些语义缺口。而理解语义上下文正是大语言模型最擅长的事。
于是研究者提出了名为TabFM Auto的新架构:保持TabFM冻结作为推理引擎,让一个由LLM驱动的智能体接管整条流水线。智能体负责检查列名、编写数据转换逻辑、选择上下文行、校准预测结果。研究显示,这套组合能在Tab Arena基准测试中拿到顶级排名。
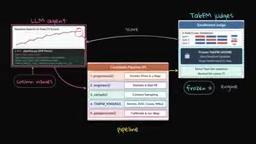
由于TabFM Auto的代码尚未公开,作者用Opus 5.5自行实现了一套以Gemini作为编排器的方案。
这里提到的语义缺口(semantic gap)是表格基础模型领域的核心挑战之一。现实表格中,相同的数值可能承载完全不同的含义:整数3在"产品等级"列是类别标签,在"购买次数"列是计数,在"NPS评分"列又是李克特量表的一格。传统机器学习从业者通过特征工程手动将这些语义编码进模型,例如对类别列进行独热编码(One-Hot Encoding)、对偏态分布列做对数变换。TabFM跳过了这一步骤,其代价便是放弃了对列语义的感知。Tab Arena是目前评估表格模型跨数据集泛化能力的主流公开基准,覆盖分类与回归任务,涵盖医疗、金融、工业等多个领域,TabFM Auto在其上的顶级排名意味着LLM负责的语义解析层有效弥补了这一缺口。
让智能体做数据科学,必须有一个坚实的后端
要支撑TabFM Auto这类系统,一个健壮的数据库架构至关重要。作者总结了三个关键点:
语义接地(Semantic Grounding)
在Postgres中,你可以把数据字典直接存成列注释(column comments)。智能体结合表结构加内联注释,就能判断该写什么样的转换代码。
沙箱隔离
绝不能让一个自主运行的LLM去改动生产数据。因此每做一次实验,智能体就在Neon上开一个隔离分支——一分钟内即可完成的完整写时复制数据库克隆。它在分支里创建特征表、测试连接、删列、保存运行结果。一旦失败,直接删掉分支,生产库毫发无损。
防数据泄漏(Data Leakage)
这是最关键的一环。作者的数据集里有一个"retention"列,它只有在客户发起取消后才会被填充。对于只看当前快照的智能体来说,这看起来像一颗"银弹特征",但它其实反映的是未来的结果,不该被使用。实测中有一半的运行里,智能体注意到了这个相关性,却忽略了时间维度的风险,直接把它塞进了流水线。
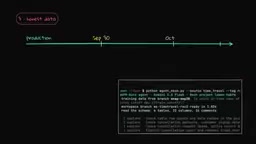
解决办法是:让智能体在一个恢复到预测窗口之前精确时间戳的隔离分支上进行训练。测试时用客户下个月的真实行为验证,结果那个"看起来完美"的模型反而是最差的(因为用了泄漏列),而没用泄漏列的模型表现优异。
Neon是一个基于存储计算分离架构的Serverless PostgreSQL服务,其"分支(Branch)"功能借鉴了Git的写时复制(Copy-on-Write)概念:每个分支并不物理复制整份数据,而是共享同一份底层存储页面,仅在写入时才生成差异页。这使得创建一个包含完整数据集的隔离环境耗时极短(通常在数秒内),且存储开销与实际修改量成正比,而非与数据集总量成正比。对于需要频繁实验的AI智能体工作流,这一特性至关重要——它在不牺牲数据安全的前提下,将"每次实验独立环境"的成本降至可忽略的水平。
从一次性预测到可调度的生产流水线
真实业务中,流失预测不是一次性的。作者把智能体生成的流水线存进数据库,由Neon函数定时调度运行:每晚从Postgres构建特征、排入任务队列,DGX机器取走任务、为每位客户打分并写回数据库,高风险名单落在旁边的对象存储中。
实验里作者把时钟向前拨了一个月,加载真实发生的情况生成名单,结果排在最前面的客户确实大多取消了订阅——这直观展示了TabFM嵌入智能体循环后的威力。
三个值得记住的结论
第一,表格预测不再需要先训练模型。 你的数据可以直接当作提示词使用。
第二,LLM在这里依然不可或缺,但角色变了。 它不再充当预测器,而是负责读懂列名、注入领域知识的那一环。
第三,要让智能体做数据科学,就得给它一个真正可操作的后端。 为每次实验提供独立分支,把每列的含义放在数据旁边,并让智能体看到"在做预测的那个时刻"数据真实的样子。
TabFM的权重虽然仅限研究用途,但它所代表的架构模式,很可能预示着表格数据处理方式的根本性转变。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。