谷歌新AI编程击败Claude,成本仅三分之一
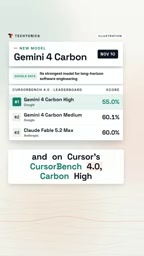
Gemini 4 Carbon在Cursor基准上微弱领先Claude,成本仅为其三分之一,价格成关键变量。
据Cursor公布的CursorBench 4.0数据,谷歌Gemini 4 Carbon高配版以60.4%微幅领先Claude Fable 5.2 Max的60%,差距仅0.4个百分点,Cursor官方提示该差异可能不具统计显著性。真正的分野在成本:carbon high单任务花费9.22美元,Fable Max为32.79美元,前者约为后者三分之一。谷歌同时预览Slash Swarm与Anti-Gravity,支持一次提示词拉起并行规划、构建、检查的编程智能体团队,指向从单模型补全向多智能体流水线的演进。文章强调数据仅来自Cursor单一口径、截至11月11日,未经跨平台验证,反映AI编程竞争重心正从能力转向性价比。
谷歌在AI编程赛道投下了一枚重磅炸弹。据Cursor公布的基准测试数据,其最新模型Gemini 4 Carbon在CursorBench 4.0上以微弱优势超越Claude,而单任务成本仅为后者的三分之一。这场较量背后,价格正在成为比分数更关键的变量。
性能反超:0.4个百分点的微妙胜利
根据Cursor发布的CursorBench 4.0榜单,Gemini 4 Carbon的高配版本「carbon high」以60.4%的成绩位列第一。紧随其后的是Claude Fable 5.2 Max,得分为60%。两者差距仅有0.4个百分点。
Cursor官方对此给出了审慎的注解:如此小的分数差距可能并不具备统计意义上的显著性。换言之,单纯从能力维度看,这两款模型在编程任务上的表现几乎处于同一水平线。真正的分水岭不在榜单名次,而在账单数字。
基准测试中的「统计显著性」指的是分数差异是否超出随机波动范围。通常需要多次运行取均值并计算置信区间,若两个模型的置信区间大幅重叠,则不能断言一方真正优于另一方。在编程基准上,温度采样、提示词微小差异、任务子集选择都会带来几个百分点的波动,因此0.4个百分点的领先很可能落入噪声区间。这也是为什么榜单排名需要结合方差信息阅读——单次静态得分不足以支撑「超越」的强结论。
成本对决:9.22美元 vs 32.79美元
Cursor列出的单任务成本数据揭示了更关键的差异:carbon high每项任务花费9.22美元,而Fable Max为32.79美元。前者约为后者的三分之一。
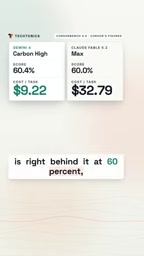
对于高频使用AI编程助手的团队而言,这一差距在规模化后会形成可观的成本分化。当两个模型的能力差距落在误差范围内时,价格优势就从一个次要因素上升为核心决策依据。Cursor的表述也印证了这一点:小分差可能没有意义,真正的故事是成本。
单任务成本通常由输入与输出token数量乘以各自单价累加得出,并可能包含推理时的多次采样、工具调用与重试开销。AI编程任务往往需要读取大段代码上下文,输入token量远超普通问答,因此每百万token的价格差异会被显著放大。此外,高价模型若需要更多轮次才能完成任务,实际成本差距还会进一步拉大。评估时更合理的指标是「完成一个任务的总花费」而非单纯单价,这也正是Cursor采用单任务口径的原因。
不止于单模型:Slash Swarm与Anti-Gravity
谷歌此次还预览了两项面向多智能体协作的功能。据展示,Slash Swarm与Anti-Gravity允许用户通过一次提示词拉起一支编程智能体团队,这些智能体并行完成规划、构建与检查工作。
这一方向意味着AI编程正从「单模型补全」向「多智能体流水线」演进。并行化的智能体编排若能落地,将改变开发者与AI协作的粒度——从逐行交互转向任务级委托。不过目前这两项功能仍处于预览阶段,实际可用性与稳定性有待观察。
多智能体编排(multi-agent orchestration)指由一个调度层把任务拆解,分配给多个具备不同角色或工具权限的模型实例并行执行,再汇总结果。常见角色包括规划者、编码者与审查者,类似软件团队的分工。其价值在于把长链路任务并行化、把上下文拆分到更小的窗口,从而降低单次推理的复杂度;代价则是协调开销、结果冲突合并以及错误在智能体间传播的风险。这类系统能否稳定落地,取决于调度策略与验证机制是否成熟。
数据边界:来自Cursor的单一口径
需要明确的是,上述所有数字均来自Cursor官方发布,截至11月11日。这意味着它们反映的是单一平台在特定基准上的测量结果,而非跨平台的独立验证。
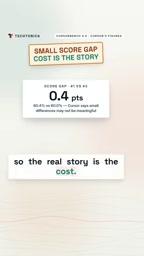
Cursor自身也承认小分差可能不具意义,这为「谷歌击败Claude」的叙事提供了一个必要的限定条件。更准确的解读是:在Cursor的评测体系下,两款模型编程能力接近,而谷歌在成本上取得了明显优势。对于考虑迁移的团队而言,价格是可见的吸引力,但迁移成本、生态适配与长期稳定性同样需要纳入考量。
第三方基准的独立性是评估模型能力的重要前提。由平台自身发布的榜单,其任务集、评分脚本与成本计算方式都由平台定义,可能无意中偏向与其产品形态契合的模型。跨平台验证通常需要多个互不相关的评测集(如公开的代码修复、竞赛题、真实仓库任务)相互印证,并公开运行细节以便复现。在缺少这类交叉验证时,单一来源的数字应视为方向性参考,而非定论。
价格战的新阶段
这次对比折射出AI编程工具竞争重心的转移。当头部模型的能力差距收窄到小数点后一位,厂商的差异化空间正从「谁更聪明」转向「谁更划算」。对开发者来说,这未必是坏事——更低的单任务成本意味着更高的尝试频率与更宽的实验空间。至于是否值得为此切换工具,答案取决于团队对成本敏感度与生态依赖度的权衡。
相关推荐
实测Shopify AI Toolkit:给AI生成的Shopify代码加上官方校验
实测Shopify官方AI Toolkit:将Shopify文档、API schema和代码校验接入Claude Code等编程助手,拦截AI捏造字段的错误。了解安装步骤、离线校验能力与遥测默认开启的注意事项。
Claude调度AI编程团队:Agent Orchestrator实战解析
Agent Orchestrator开源项目让Claude Code调度Codex、Gemini、Cursor等多个AI并行编程,通过Git Worktree隔离、CI自动纠错和移动端通知实现AI团队协作。本文解析其核心机制、成本结构与适用场景。
GitHub热门:AI创业7步Agent技能包
GitHub趋势项目ai-startup-skills为一人AI创业公司提供7个Python Agent Skill,用router串联从验证到注册的流程。20天获900星,本文解析其设计思路与实用边界。