谷歌新视频模型升级:15秒片段与更自然对话

谷歌视频生成模型升级:时长增至15秒,改善对话同步、角色一致性与提示词编辑。
谷歌DeepMind发布新一代视频生成模型,将单次生成时长从10秒延长至15秒,并改善对话与口型同步的自然度、跨镜头角色一致性,以及支持用新提示词编辑同一片段。文章认为,这些改进标志着视频生成竞争焦点从画面质量转向叙事连贯性与可控性。15秒时长拓展了单次生成的叙事空间,减少拼接工作;口型同步和角色一致性提升使生成内容更接近可用制作素材;提示词编辑则降低迭代成本。不过,信息来自官方社交媒体披露,缺乏技术细节和第三方评测,实际效果仍待验证。
谷歌视频模型迎来关键升级
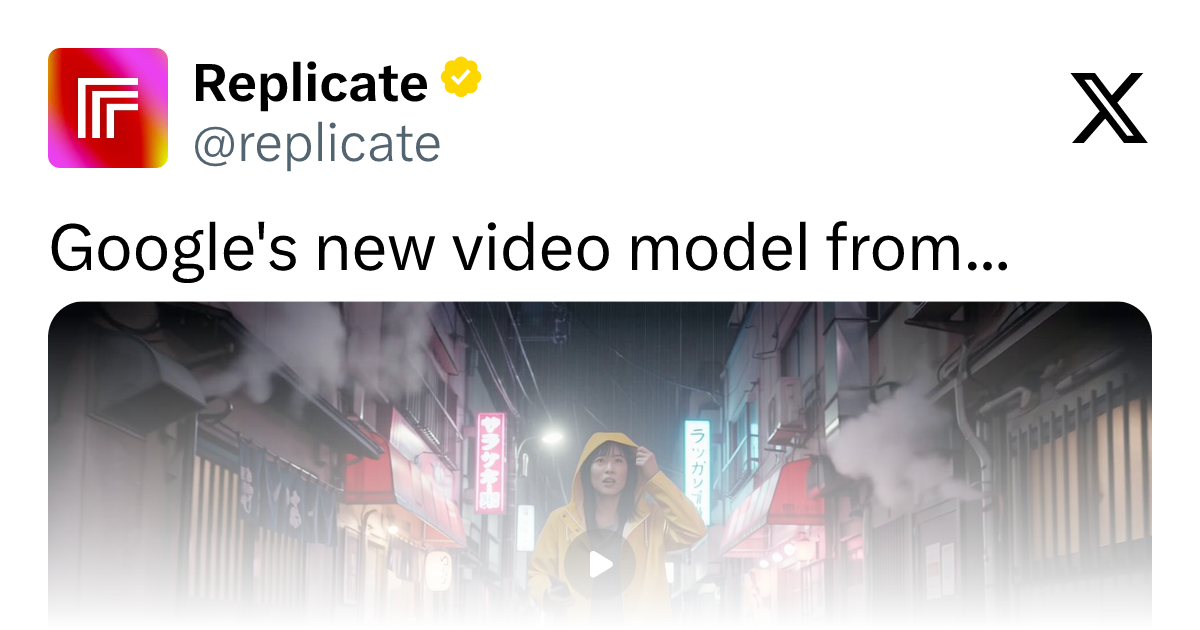
谷歌DeepMind近日发布了新一代视频生成模型,在多个维度上实现了显著提升。根据官方在社交平台上的简短披露,新模型将单次生成的视频片段时长从10秒延长至15秒,同时改善了对话自然度和角色一致性,并支持通过新提示词对同一片段进行编辑。
这一更新虽然看似是参数层面的渐进式改进,但背后反映的是视频生成领域竞争焦点的转移——从单纯追求画面质量,转向对叙事连贯性和可控性的追求。
时长增加带来的叙事空间
15秒与10秒的差异,表面上是几秒钟的延长,实际上改变了视频生成的使用场景。10秒片段往往只能承载一个动作或一个场景的展示,而15秒足以容纳简单的对话场景或情节转折。
对于内容创作者而言,这意味着更少的拼接工作。此前制作一段完整叙事视频需要多次生成并剪辑拼接,而更长的单次生成片段降低了后期处理的复杂度。当然,15秒仍远未达到长视频生成的门槛,但在当前技术条件下,这一提升方向具有实用价值。
对话与口型同步的自然度改进
官方特别强调了“更自然的对话和口型同步”。这是视频生成中公认的难点之一。人物说话时的口型与音频对齐,涉及视觉与听觉的跨模态协调,此前生成的视频中常出现口型与语音脱节、表情僵硬等问题。
新模型在这方面的改进,意味着生成视频中的人物对话场景将更具可信度。这一能力对于营销视频、教育内容和虚拟角色应用尤为关键。不过,官方并未披露具体的技术细节或评估数据,实际效果仍需等待更多测试验证。
口型同步(Lip Sync)在技术实现上通常依赖音频驱动的面部动画生成:系统先从语音中提取音素(phoneme)序列及其时间边界,再将这些音素映射到对应的视素(viseme,即发音时的口型形态),最后驱动生成模型在每一帧中渲染匹配的嘴部动作。难点在于音素与视素并非一一对应,同一音素在不同语境下的口型会有差异,且生成模型还需同时保持面部其他区域(眼神、表情、头部姿态)的自然协调。评估口型同步质量常用的指标包括LSE(Lip Sync Error)和基于 SyncNet 的置信度分数,但这类指标与人类主观感受之间存在差距,因此官方未披露评估数据时,实际效果难以判断。
角色一致性:跨镜头连贯的关键
“角色在不同镜头间保持一致”是本次更新的另一重点。在多镜头视频中,同一角色在外观、服装、面部特征上的稳定性直接影响观看体验。此前视频生成模型在不同镜头间容易产生角色“变脸”现象,限制了其在系列内容和品牌视频中的应用。
角色一致性的提升,使得生成内容更接近可用的制作素材,而非单纯的演示片段。这也是视频生成从技术展示走向实际生产工具的必要条件。
跨镜头角色一致性通常有两种技术路径:一是以参考图像或角色 ID 作为条件输入,通过身份保持模块(如人脸嵌入、IP-Adapter 类机制)约束每个镜头的生成结果;二是在扩散模型的注意力层中注入跨帧、跨镜头的特征共享,使同一角色在不同时间点的外观表征保持稳定。挑战在于,视频扩散模型在生成过程中会逐步累积误差,镜头切换或视角大幅变化时,角色的服装纹理、发型细节和面部特征容易发生漂移。角色一致性因此常被视作视频生成从“单镜头演示”迈向“多镜头叙事”的关键门槛,也是广告、短剧等商业内容生产对模型提出的刚性要求。
提示词编辑:可控性的进一步提升
新模型支持“用新提示词编辑同一片段”,这一功能指向了视频生成的可控性需求。创作者可以在保留原始片段基础结构的前提下,通过修改提示词调整内容,而不必从头重新生成。
这种编辑方式类似于图像生成中的局部重绘思路,应用到视频领域后,能够显著降低迭代成本。对于需要反复调整创意的商业场景,这一能力具有实际意义。
视频生成中的提示词编辑与图像领域的局部重绘(inpainting)有相似之处,但复杂度更高。图像局部重绘只需在空间维度上指定编辑区域并保持其余像素不变;视频编辑则还需维持时间维度上的连贯性,即修改后的内容要在前后帧之间平滑过渡,不能出现闪烁或跳变。常见实现思路包括:在扩散采样过程中对未编辑区域施加时空约束,或利用原始视频的隐变量作为结构先验,仅对与编辑提示相关的部分重新去噪。这类方法能显著降低“重新生成整段视频”带来的随机性和成本,但编辑幅度较大时,原始结构的保持能力仍受模型能力限制。
竞争格局与展望
视频生成赛道的竞争持续升温,各主要厂商都在时长、一致性和可控性上发力。谷歌此次更新虽然没有公布详细的技术报告或基准测试结果,但从功能列表来看,其改进方向紧扣实际应用中的痛点。
说一下,当前信息主要来自官方社交媒体的简短发布,缺乏第三方评测和独立验证。15秒片段的实际画质、对话同步的准确率以及编辑功能的效果,都有待更多实测数据支撑。视频生成模型能否从“惊艳的演示”进化为“可靠的生产工具”,仍需观察其在实际工作流中的表现。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。