归一化流映射与奖励混合:生成模型如何兼顾采样速度与精确似然

NFM 以可逆映射恢复精确似然,Martini 用代理奖励组合逼近昂贵预言奖励。
文章围绕生成模型的两个核心问题展开。第一部分介绍归一化流映射(NFM),它把归一化流的可逆性从端点推广到任意中间时刻之间,从而在保持少步采样能力的同时恢复精确似然,避免了自回归流必须注入噪声才能训练的困境。NFM 支持粒子级与分布级两种训练视角,并在 CIFAR、64×64 图像、玻尔兹曼生成器及基于似然的 RLHF 后训练中取得优于基线的方法效果。第二部分介绍 Martini,针对预言奖励查询成本过高的问题,学习多个廉价代理奖励的非线性组合函数来逼近目标倾斜分布,避免单一代理的奖励黑客问题,在语言、图像与蛋白质-配体共折叠任务上均验证有效,并指出代理覆盖不足导致的信息地板是不可突破的能力上限。
生成模型的核心任务可以拆成两个问题:如何把噪声变成数据(生成映射),以及用什么奖励引导采样走向下游应用真正想要的结果。微软研究院的这场讲座围绕两篇近期论文展开,分别对应这两个问题——Normalizing Flow Maps(归一化流映射)和 Martini(代理奖励混合)。
第一部分:归一化流映射(NFM)
现有生成模型家族的取舍困境
讲座首先给出了一张清晰的对比图景。扩散模型与流匹配模型样本质量高,但仿真成本昂贵,且难以获得似然;流映射(flow maps)支持少步采样,样本质量接近扩散模型,但同样缺乏廉价似然;归一化流(normalizing flow)天然是一步映射,技术上具备似然,但若直接在干净数据上训练,样本质量并不理想。
讲者特别提到了一个常被忽略的细节:自回归流(TAR flow)的训练“几乎必须”在训练分布中加入少量高斯噪声,再用Tweedie恒等式去噪。在CIFAR-10上,不加噪声训练得到的FID为40.83,加入极少量噪声后降至6.55左右。代价是:一旦经过Tweedie去噪,端点处形成多对一映射,干净数据分布上的精确似然就丢失了。这正是这类模型难以用于科学采样等需要似然的应用的原因。
Tweedie 恒等式是统计估计理论中的一个经典结果,在扩散模型语境下通常指:对于加噪数据 x_t = α_t x_0 + σ_t ε,干净数据的最优去噪器(即后验均值 E[x_0|x_t])与得分函数 ∇log p_t(x_t) 之间存在解析关系。具体地,得分函数可以由去噪器乘以一个与噪声水平相关的系数得到。这一等式让“训练一个去噪网络”与“学习数据分布的得分”等价起来,是扩散模型与流匹配训练目标的数学基础。文中提到的“用 Tweedie 恒等式去噪”即指在采样或似然计算时,把网络输出的去噪估计代回该恒等式以恢复得分。需要注意的是,去噪操作本身是收缩的:当噪声趋近于零时,大量噪声样本会映射到同一个干净样本附近,形成多对一映射,从而破坏映射的可逆性,精确似然也随之失效。
NFM 的核心构造
NFM 的定义很直接:从噪声到数据的传输路径上,任意两个时间点 s 和 t 之间的映射都严格可逆。由此带来的关键变化是,变元替换(change of variables)不再只发生在端点 0 和 1 之间,而是可以发生在任意两个中间时刻之间。若令 s=1、t=0,就退化回普通归一化流,因此 NFM 可以视作对归一化流的推广,同时把少步算子的能力与精确似然结合起来。
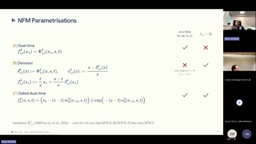
参数化方面,讲者给出三种方案:
- 双时间参数化:直接用可逆网络建模 s→t 的映射,但无法自然保持恒等性(s=s 时映射应不动),需要额外惩罚项约束。
- 去噪器参数化:可逆部分由双时间 delta 映射刻画,可恢复平均速度,从而得到从任意中间点到端点的可逆映射;代价是任意 s→t 的映射不一定可逆,但换来了更丰富的架构选择空间。
- 门控双时间参数化:在自回归流的每个缩放与平移变换上加入 s−t 门控,既保持恒等性,又对任意 s、t 可逆。
**变元替换公式(change of variables)**是归一化流乃至所有基于可逆映射的生成模型的似然计算基石。若 z = f(x) 是严格可逆且可微的映射,则两个分布之间的密度满足 p_X(x) = p_Z(f(x)) · |det ∂f/∂x|。在高维场景下直接计算雅可比行列式代价极高,因此实际模型通常采用自回归结构或耦合层设计,使雅可比矩阵为三角阵,行列式退化为对角元乘积,从而把 O(d³) 的计算降到 O(d)。文中 NFM 的关键创新在于把这一公式从“端点之间”推广到“任意中间时刻 s 与 t 之间”:由于时间 1 处是已知的高斯分布,只要 s→t 的映射可逆,就能写出任意时刻边缘分布的精确密度。这正是 NFM 能够同时获得少步采样与精确似然的数学原因。
粒子级与分布级两种训练视角
NFM 可以在两个层面训练,且最优时两者一致。粒子级视角下,它就是普通流映射,可以直接套用 mean flow 或 improved mean flow 的回归目标,区别仅在于 v_st 由 NFM 参数化。分布级视角(即分布匹配)则利用这样的事实:时间 1 处是高斯分布,因此任意时刻 t 的边缘分布可以通过高斯密度加对数行列式项精确写出,这类似最大似然训练,但沿整条插值路径进行,且不需要向数据注入噪声。
进一步的 few-step NFMD 采用学生-教师结构:冻结教师从 p1 走到 ps,学生从 s 跳到 t 再拉回 s,通过自一致性目标让少步采样能力沿路径保持。
实验结果:从图像生成到玻尔兹曼生成器
在 CIFAR 上,点级匹配的 NFM-R 取得最佳 FID,但讲者坦承一个现实问题:理论上严格可逆的映射在实践中可能因训练目标而数值上不可逆,需要噪声退火到零等技巧辅助。在 64×64 图像上,参数匹配的可逆模型中 NFM 样本质量最强,新提出的 FLD 指标也显示生成多样性保持良好。
更具说服力的应用是分子领域的玻尔兹曼生成器。以 10 个氨基酸的 chignolin 肽为例,NFM-D 在重新加权后能几乎精确匹配目标能量分布,优于此前基于归一化流的方法和更新的自回归模型。在零样本迁移到四氨基酸与八氨基酸体系时,NFM-D 在六个指标中的五个上表现最佳。讲者展示的 TICA 热图显示,NFM-D 不仅覆盖了真实分子动力学轨迹的所有模式,还没有像自回归流那样幻觉出虚假模式。
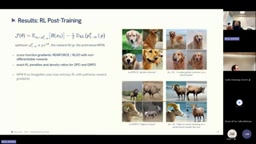
另一个讲者本人最看重的结果是:有了可用的似然,就能像语言模型那样对连续图像模型做 RLHF。团队直接套用 GRPO、DPO 或最大熵 RL,用大规模 VLM 作为奖励,把“金毛犬”引导成“沙滩上奔跑的金毛犬”,把“大角羊”引导成“海边的大角羊”,分布偏移明显但过程自然。奖励随训练更新的曲线也优于 SMC 或 best-of-n 采样等基线。
第二部分:用代理奖励混合逼近昂贵预言奖励
问题设定:预言奖励太贵,只能用便宜代理
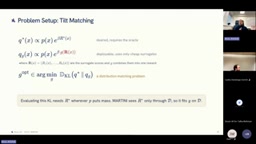
前文提到的后训练需要大量查询预言奖励 r*,例如图像场景下约需千倍量级的查询与 256 个样本,成本极高。Martini 要回答的是:如果只能通过一个小的反馈集 D 有限地访问 r*,能否借助多个廉价代理奖励的组合函数 G 来逼近 r* 的倾斜分布 q*?
反馈集有两种形式:独立的标量值反馈,或排序偏好反馈(对应 Plackett-Luce 模型,二元情形即 RLHF 中常用的 Bradley-Terry 模型)。
为什么不能只用最好的单一代理
讲者用语言模型困惑度的例子说明:若只用最好的单一代理并不断加大引导强度,会出现奖励黑客(reward hacking),性能反而下降。而同时使用多个代理,由于无法同时欺骗所有奖励,天然形成防护。这也是需要学习组合函数而非简单挑选的原因。
一个直观的反例说明这不是帕累托最优问题:当两个奖励都含有对称的平方项时,帕累托最优集永远无法到达位于内部的真正最优点。理论上,在小倾斜极限下,最小化 G∘R 与 r* 的均方条件误差(MSC)等价于最小化到 q* 的 KL 散度(至三阶项),但始终存在一个由方差定义的“信息地板” V̄,这是代理覆盖不到的空间带来的不可恢复损失。
**奖励黑客(reward hacking)**指优化器在最大化一个代理目标时,找到了该目标的高分区域,却偏离了真正想要的行为。在 RLHF 中,奖励模型只是人类偏好的近似,强化学习会系统性地利用其误差:生成在奖励模型看来得分极高、但人类评价很差的文本。文中语言模型困惑度的例子正是这一现象的定量版本——单一代理的引导强度越大,越容易进入代理的“盲区”,真实性能先升后降。多代理组合的防护机制在于:不同代理的误差方向通常不完全相关,同时欺骗所有代理比欺骗一个要困难得多,因此组合函数相当于对代理误差做了一种隐式正则。这也解释了为何 Martini 要学习非线性组合函数,而非简单地挑选或线性加权表现最好的那个代理。
验证:语言、图像与蛋白质对接
语言建模实验中,以 Qwen 2.5 1.5B 的生成困惑度作为预言奖励,用 BERT、蒸馏 BERT、token 熵等作为代理,反馈集仅 256 个值或排序。Martini 学到的 q_G 与 q* 的 KL 显著低于均匀权重或帕累托类方法,且引导强度增大时困惑度持续下降。
图像任务上仅用 32 个提示,在 Wasserstein、KDE 等嵌入空间分布指标上就取得明显改善,值反馈与排序反馈两种设定均有效。
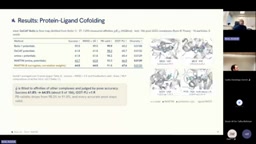
最贴近实际应用的实验是蛋白质-配体共折叠:以结合亲和力为预言奖励,在实验 PKD 数据上离线拟合 G,再用于结构预测。使用 Boltz 流映射版本,成功判据(RMSD 小于 2 埃且 PB valid 高于阈值)从 61.8% 提升到 64.5%。这意味着外部亲和力数据可以在不重新查询奖励的情况下改善生成位姿的物理合理性。
Plackett-Luce 模型是排序数据的经典概率模型,用于刻画“从一组候选中选出第一名”的过程。若每个候选 i 有一个隐式效用值 s_i,则选中 i 的概率为 exp(s_i) / Σ_j exp(s_j)。当只有两个候选时,该模型退化为 Bradley-Terry 模型,即 P(i 胜 j) = σ(s_i − s_j),这正是 RLHF 中训练偏好奖励模型的标准形式。文中把排序偏好反馈对应到 Plackett-Luce 模型,意味着反馈集 D 提供的不是奖励的绝对数值,而是若干候选的相对次序;Martini 需要在这种只含序信息的数据上拟合组合函数 G。相比标量值反馈,排序反馈的信息量更少但采集成本更低,也更贴近人类标注的实际形态,因此这一设定对方法的实用性至关重要。
开放问题与边界
问答环节讨论了几个关键限制。代理之间的互补性是核心假设:若多个代理提供相同信息,可通过反馈集上的相关性识别并剔除;但即便互补,若代理整体覆盖不到任务空间的某些区域,V̄ 这一信息地板就无法突破——讲者明确表示这“肯定无法克服”。关于 NFM 的采样步数,实践表明超过四步后提升不再线性,few-step NFMD 在二到四步时优于单步版本。至于如何用组合函数对精确似然模型做后训练,讲者将其留作开放问题。
相关推荐

Dropbox 3.5亿美元收购Tigris Data,加码AI基础设施
Dropbox 以 3.5 亿美元收购 Tigris Data,推动 DBX Agent Cloud 存储平台落地,瞄准 AI 模型与智能体开发者,存储层正成为 AI 基础设施竞争的新焦点。

Zipline估值215亿美元:沃尔玛加码无人机配送
Zipline 完成 15 亿美元融资,估值达 215 亿美元,并扩大与沃尔玛的无人机配送合作。本文分析资本加注背后的逻辑、沃尔玛加码的战略意图,以及无人机配送规模化落地面临的竞争与挑战。

TikTok悄然上线独立TikTok Shop应用
TikTok悄然推出独立TikTok Shop应用,提供个性化推荐、直播与短视频购物、应用专属优惠、应用内结算及订单跟踪等功能。本文分析其拆分电商入口的原因、低调上线的信号以及对卖家和创作者的影响。