过参数化加权MMD优化景观首获有限粒子保证

一维高斯核下加权MMD优化:粒子足够多时坏局部极小值消失,坏驻点不稳定
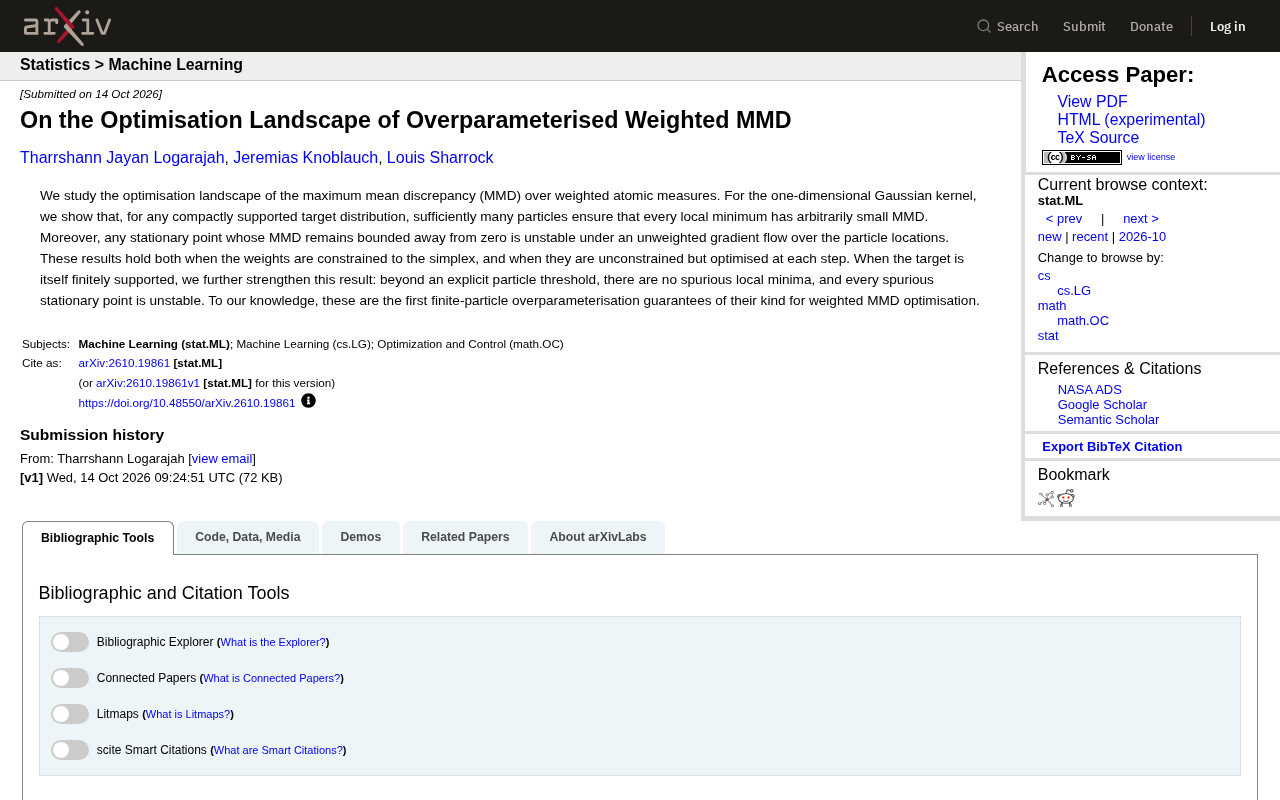
本文介绍了一项关于加权最大均值差异(MMD)优化景观的研究,给出该领域首个有限粒子过参数化保证。作者针对一维高斯核与紧支撑目标分布证明:只要粒子数足够多,每个局部极小值处的MMD可任意小,即非凸景观中的劣质盆地被压平;同时任何MMD值远离零的驻点在无权重梯度流下都是不稳定的,梯度流不会停留在坏驻点。结论同时覆盖权重约束在单纯形与无约束逐步优化两种参数化。当目标分布为有限支撑时,结论更强:存在显式粒子数阈值,超过后无虚假局部极小值,所有虚假驻点均不稳定。这对实践中粒子数选择提供了理论依据,目前限制在一维高斯核场景。
从核方法到粒子优化:MMD的优化困境
最大均值差异(Maximum Mean Discrepancy, MMD)是机器学习中衡量两个分布差异的经典度量,广泛用于生成模型、域适应和核两样本检验。实际计算时,MMD通常通过一组加权粒子(weighted atomic measures)来近似目标分布,而这组粒子的位置和权重往往用梯度下降来联合优化。
问题在于:这个优化问题是非凸的。粒子数不够时,梯度流容易陷入“虚假”的局部极小值——损失降不下去,生成的分布与目标分布相差甚远。长期以来,理论上人们对“多少粒子才够”“非凸景观中是否还有坏驻点”缺乏有限粒子层面的定量保证。
最大均值差异(MMD):给定再生核希尔伯特空间(RKHS)$\mathcal{H}$ 及其核函数 $k$,对两个分布 $P$ 与 $Q$,MMD 定义为
$$\mathrm{MMD}^2(P,Q)=\big|\mathbb{E}{X\sim P}[k(X,\cdot)]-\mathbb{E}{Y\sim Q}[k(Y,\cdot)]\big|_{\mathcal{H}}^2.$$
直观上,它度量了两个分布经核映射后的均值嵌入之间的距离,因此当且仅当核是特征核(characteristic kernel)(如高斯核)时,$\mathrm{MMD}(P,Q)=0 \iff P=Q$。实际中常用一组加权粒子(原子测度)$\sum_i w_i \delta_{x_i}$ 去近似目标分布 $Q$,通过最小化 $\mathrm{MMD}^2$ 来联合优化粒子位置 ${x_i}$ 与权重 ${w_i}$。高斯核的指数形式使得该目标关于位置高度非凸,理解其优化景观(驻点结构、局部极小值数量)正是本文的核心问题。
核心结论:粒子足够多,坏局部极小值消失
这项研究针对一维高斯核的加权MMD优化,给出了目前已知的首个有限粒子过参数化保证。具体来说,对任意紧支撑的目标分布,只要粒子数足够多,每一个局部极小值处的MMD都可以任意小——换句话说,非凸景观中的“劣质盆地”被压平了。
更关键的是稳定性层面的结论:任何MMD值远离零的驻点,在粒子位置上的无权重梯度流下都是不稳定的。这意味着梯度流不会稳定停留在这些坏驻点上,而是会继续下降。该结论同时覆盖两种常见参数化方式:权重被约束在单纯形上(simplex-constrained),以及权重无约束但在每步都被优化到最优。
过参数化(overparameterisation)与良性景观(benign landscape):在深度学习中,当模型参数量超过训练样本数时,尽管损失函数仍是非凸的,却常观察到优化变得更容易。理论研究的核心问题是:是否存在某个人数/参数阈值,超过它之后损失函数的每个局部极小值都达到接近全局的最小值(即无虚假局部极小值),并且所有鞍点都是严格鞍点(不稳定)。这类结论通常称为“过参数化保证”。本文的贡献正是把这一范式从神经网络推广到加权 MMD 优化:粒子数相当于可调参数,结论中的“阈值”即过参数化所需的最小粒子数。
无权重梯度流(weightless gradient flow):由于每个粒子都有位置与权重两组变量,若直接对二者做梯度下降,权重维度的梯度会与位置梯度耦合,使稳定性分析复杂化。论文采用“无权重梯度流”——即固定当前最优权重,仅对粒子位置做连续时间梯度流——来刻画驻点稳定性。这一简化抓住了位置参数的动力学本质:若某个驻点在位置方向上 Hessian 存在负特征值,则哪怕权重最优,该驻点也无法稳定,梯度流会沿负曲率方向逃逸。该分析手段在连续时间极限下等价于无穷小步长的梯度下降。
有限支撑目标:显式粒子阈值与无虚假极小值
当目标分布本身是有限支撑时,结论更强。论文给出了一个显式的粒子数阈值,超过该阈值后:
- 不存在虚假局部极小值(no spurious local minima);
- 每一个虚假驻点都是不稳定的。
“显式阈值”意味着这个粒子数不是抽象的极限陈述,而是可以具体计算的下界,对实践中的粒子数选择有直接指导意义。
据作者表述,这是加权MMD优化领域首次给出此类有限粒子过参数化保证。此前关于过参数化“良性景观”的结果多集中在神经网络或特定非凸问题上,MMD粒子优化的对应理论一直是空白。
为什么这个结果重要
过参数化在深度学习中被广泛观察到能改善优化景观,但理论解释长期滞后。这项工作的价值在于,它把“粒子越多、优化越容易”这一经验直觉,在MMD这一具体而重要的目标上转化为了严格的数学命题。
对实践者的启示直接而明确:
- 粒子数选择有了理论依据。一维高斯核场景下,可以依据目标分布的紧支撑范围估算所需粒子数,而非纯靠调参。
- 坏驻点不可怕。即使存在MMD较大的驻点,梯度流也会自发逃离,这解释了为何实践中增大粒子数往往能稳定改善结果。
- 权重约束方式不改变结论。单纯形约束与无约束逐步优化两种方案在景观性质上一致,给实现层面留出了灵活空间。
当然,结论目前限定在一维高斯核与紧支撑目标。高维核、其他核函数下的有限粒子保证,仍是开放问题。
边界与展望
一维假设是该结果的核心限制。高维空间中,粒子位置的梯度流动力学更复杂,紧支撑条件也更难满足,阈值能否推广尚不明确。此外,论文讨论的是连续时间梯度流的稳定性,离散梯度下降的步长影响并未纳入分析。
尽管如此,作为该方向的首个有限粒子保证,它为后续研究提供了清晰的起点:从一维到高维、从高斯核到一般核、从梯度流到实际优化算法,每一步推广都有明确的技术路线可循。
连续时间梯度流 vs 离散梯度下降:本文的稳定性结论建立在连续时间梯度流 $\dot{x}(t) = -\nabla L(x(t))$ 上。现实中用的是离散梯度下降 $x_{t+1}=x_t-\eta\nabla L(x_t)$,两者只在步长 $\eta\to0$ 且迭代数趋于无穷时等价。对于有限步长,即使驻点在连续流下不稳定,若步长过大可能跳过逃逸方向导致数值发散,若步长过小则逃逸时间可能指数级增长而看似停滞。因此从梯度流到实际算法的推广需要额外的步长与复杂度分析,是后续工作的重要方向。
相关推荐

不写代码,用AI规划生产级应用系统架构
不写一行代码,如何用 AI 规划生产级应用系统架构?本文拆解 AI 私人教练应用的数据库建模、Agent 端点设计、聊天记录存储与分层记忆架构,讲清何时该用 AI、何时该提前生成,帮你从 vibe coding 迈向可维护的生产级开发。

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。