国产开源Agent CyberCode接入JEF:编码+浏览器自动化提速实测
CyberCode 1.1.24 接入 JEF 快速判断器,用轻量模型接管编码裁剪与浏览器操作的判断决策,减少主模型往返延迟。
CyberCode 1.1.24 引入 JEF 快速判断器,针对 AI 编程助手的两类典型延迟下手:编码场景中重复处理旧上下文的开销,以及浏览器自动化中每步都要回主模型的往返成本。JEF 的分工是接管轻量判断决策,主模型保留规划、写代码和核验等复杂推理。编码侧的收益来自上下文智能裁剪,减少输入 token;浏览器侧的收益来自连续执行确定性操作,按算力假设估算可接近两倍提速。文章明确区分了 Browser Use 公布的参考数据与作者自行构造的算力估算,坦承 CyberCode 目前尚无真实端到端测速数据,态度克制。配置流程简单,但使用云端 JEF 会上传上下文,对隐私敏感的用户可切换本地 Reflex 4B 模型,需另行部署。
国产开源智能体 CyberCode 在 1.1.24 版本接入了 JEF 快速判断器,试图解决 AI 编程助手常见的两大延迟痛点:反复读取旧日志、每次网页操作都要等待大模型重新思考。这篇文章讲清楚新功能的原理、配置方法,以及它到底能快多少。
JEF 的定位:快速判断,主模型负责推理
JEF 在 CyberCode 里扮演的是「快速判断器」的角色,负责快速判断,而主模型继续承担规划、写代码和最终核验这些重活。理解这个分工是理解整套加速逻辑的关键——JEF 并不替代主模型思考,而是把一部分「判断类」的轻量决策从主模型手中接管,从而减少昂贵的大模型往返和重复处理。
这套设计的核心思路,是把延迟拆成两块:一块是编码场景下重复处理旧上下文的开销,另一块是浏览器操作场景下每一步都要回主模型的往返开销。JEF 分别针对这两块下手。
JEF(Judge-Evaluate-Filter)这类「快速判断器」的设计思路,来源于 LLM 推理加速领域的「推测解码」(Speculative Decoding)和「模型级联」(Model Cascading)概念:用一个小模型先行处理低难度决策,只有当小模型不确定时,才把任务升级给大模型。这样可以在不牺牲质量上限的前提下,大幅降低平均延迟和 token 消耗。JEF 在 CyberCode 中的具体实现是 TypeSafe 公司提供的云端 API 服务,并非通用开源组件,因此其模型架构和训练细节并未完全公开。理解这一背景有助于正确预期它的适用边界——它擅长的是有限动作空间内的确定性判断,而非开放式推理。
编码提速:上下文的智能裁剪
当前接入的重点是上下文里的智能裁剪。在原有裁剪流程完成之后,JEF 会批量判断较早的只读工具结果,哪些值得保留、哪些可以缩短。近期内容、错误信息和原始对话历史都会受到保护,不会被误删。
需要强调的是,它并不直接让主模型写代码更快。真正能省下的,是重复处理旧内容的时间和输入 token 开销。因此在短对话、或者缓存命中率很高的场景下,收益可能非常有限。
用一个算力假设来说明收益条件:假设一轮原本耗时 20 秒,其中 8 秒花在输入处理上。若裁剪让这部分减少 40%,而 JEF 本身多用 0.3 秒,总耗时就变成约 17.1 秒,也就是少等约 14.5%。这个数字只是解释收益成立的条件,并非实测成绩。
「上下文裁剪」(Context Pruning)是 AI 编程助手降低延迟和成本的常见手段。大语言模型的推理时间和费用与输入 token 数量近似线性相关,而长对话中早期的工具调用结果(如文件读取、命令输出)往往对当前任务已不再有价值,却仍然占据大量上下文窗口。传统裁剪策略多依赖规则(如按时间滚动丢弃)或由主模型自身判断,前者容易误删有用信息,后者本身就需要消耗主模型资源。JEF 的介入点正是在主模型做裁剪决策之前,用轻量模型批量预判哪些旧内容可以压缩,从而同时降低主模型的输入长度和裁剪决策本身的开销。这也解释了为何文章特别提到「近期内容、错误信息和原始对话历史受到保护」——这些是裁剪误判代价最高的类别。
浏览器自动化:减少大模型往返
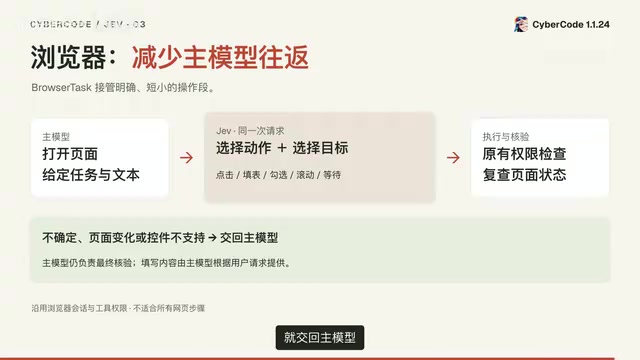
浏览器场景的逻辑是:主模型先打开页面,再把一个明确的小任务交给 Browser Task。页面状态进入 JEF 后,一次请求同时选择动作和目标,点击、填表、勾选、滚动这些操作就不必每一步都回主模型。
需要注意几个边界:输入文字仍然由主模型根据用户要求提供;全局检查和执行前的页面复查仍然保留;一旦判断不确定、动作空间不支持、或者页面发生变化,控制权就交回主模型。这保证了自动化不会在复杂场景下失控。
同样用算力假设估算:8 个步骤,每步大模型 3 秒、页面操作 1 秒,原本总计 32 秒。若改为每步 JEF 判断 0.3 秒、页面操作 1 秒、复查 0.2 秒,再加 4 秒主模型开销,总计约 16 秒,接近两倍速度。但如果网页加载很慢、或频繁回退,这个收益就不一定成立。
「Browser Task」是 CyberCode 中将浏览器操作封装为可调用子任务的模块,类似于 OpenAI 的 Computer Use 或 Anthropic Claude 的 Tool Use 中的浏览器工具。其核心挑战在于:每一步页面操作(点击、填表、滚动)之后,页面 DOM 结构都会发生变化,传统做法需要将新页面状态重新发送给主模型判断下一步,造成逐步累积的往返延迟。JEF 在此场景下充当「局部策略执行器」:在主模型明确了目标之后,JEF 可以在短时间内连续完成多个确定性操作,只在遇到歧义或页面异常时才回调主模型。这种「宏操作」(Macro-action)模式在机器人控制和游戏 AI 领域早有先例,应用到网页自动化是近两年的新趋势。
关于「能快多少」:参考值与估算要分清
这里必须区分「参考」和「估算」。Browser Use 曾公布过一个航班搜索案例,同样使用 JEF 的两个实验线,中位耗时从 9.45 秒降到约 7.09 秒。但这是他们的单任务结果,不能直接当成 CyberCode 的成绩。
作者也坦承:CyberCode 目前还没有真实 JEF 接入的端到端测速数据。文中出现的两个数字都只是解释收益条件的算力假设,演示画面也只说明操作入口,不代表真实测速。这种把参考数据、算力估算与实测严格区分的态度,在同类教程里并不多见,值得肯定。
配置步骤:从 Token 优化到快速判断
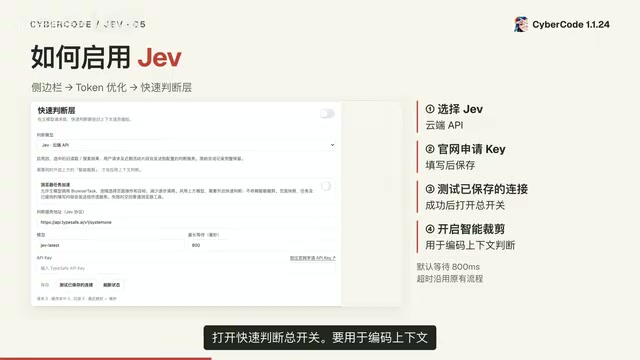
配置流程并不复杂:
- 打开侧边栏的 Token 优化,找到「快速判断器」
- 把判断模型切换为 JEF 云端 API
- 点击 API Key 旁的官网链接,登录 TypeSafe 控制台申请密钥
- 回到 CyberCode 填好并保存,再点击「测试已保存的链接」
- 测试成功后,打开「快速判断」总开关
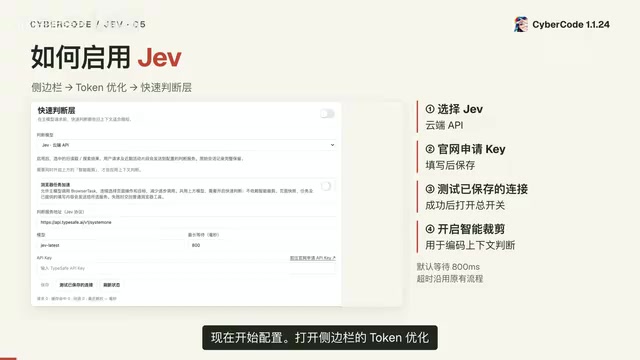
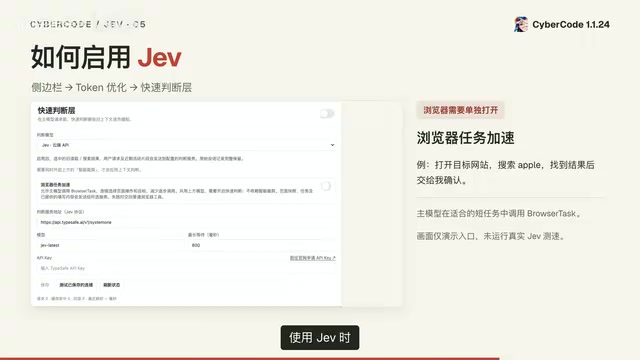
要用于编码上下文,还需要开启上方的智能裁剪。默认等待预算是 800 毫秒,超时就沿用原有流程。要加速网页操作,则额外打开对应开关,然后像平时一样下任务——例如「打开目标网站,搜索 Apple,找到结果后交给我确认」,主模型会在合适的短任务里自动调用 Browser Task。
隐私与本地部署选项
使用 JEF 时,候选上下文或页面内容会发送到云端,这是使用者需要知情的一点。对隐私敏感的场景,可以切换本地 Reflex 4B 模型,但需要另行部署服务,且默认关闭、不会自动下载模型。
Reflex 4B 是 TypeSafe 为本地部署场景提供的轻量判断模型,参数规模约 40 亿,可在消费级 GPU 或高性能 CPU 上运行推理。与云端 JEF 相比,本地模型的优势是数据不离开本机,适合处理含有敏感代码、内部文档或个人信息的任务;代价是需要用户自行搭建推理服务(通常基于 llama.cpp 或 Ollama 等本地推理框架),且在低端硬件上判断延迟可能高于云端,反而抵消部分加速收益。默认不自动下载模型的设计,既避免了用户在不知情的情况下占用大量存储,也符合「最小权限」的软件分发原则。
总结:三点要记住
最后有三件事值得记住:JEF 负责快速判断,主模型保留复杂推理;编码收益来自减少重复上下文;浏览器收益来自减少大模型往返。至于具体能快多少,要在你自己的任务和网络环境下对照测试。
CyberCode 的 Mac、Windows 和 Linux 三个安装包已发布。配置好之后,建议先从一个短任务开始试,再逐步验证在自己工作流里的实际收益。
相关推荐
Agent如何记住三年前的对话?拆解长期记忆架构五大核心
大模型本身没有长期记忆,Agent 如何记住用户三年前的对话?本文拆解 Agent 长期记忆架构,涵盖记忆分类、存储策略、检索逻辑、上下文压缩与遗忘机制五大核心,剖析工程落地难点与冲突检测方案。
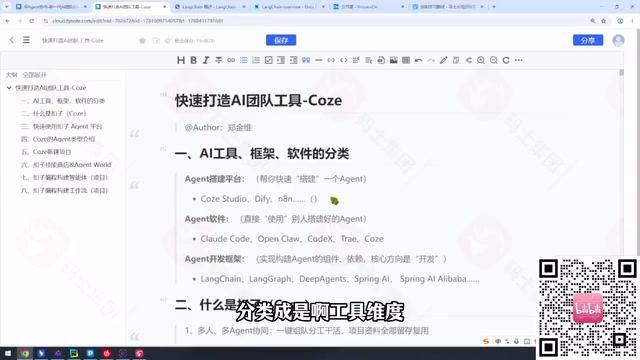
Coze扣子入门:AI Agent工具、软件与框架三大分类全解析
以Coze扣子为切入点,系统解析AI Agent生态的三大分类:搭建工具(Coze、Dify、n8n)、Agent软件(Claude Code、Cursor、Codex)与开发框架(LangChain、LangGraph)。附带编程人员的学习优先级建议。
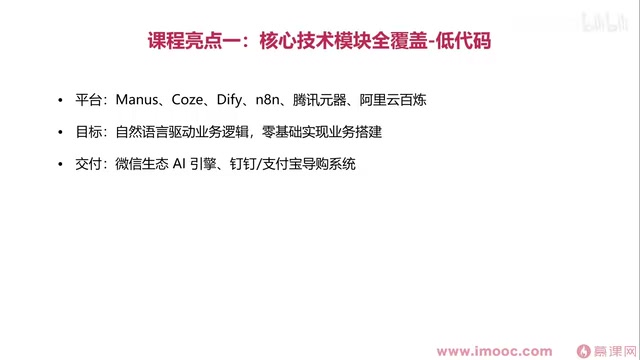
AI Agent实战全攻略:从低代码到硬核框架的企业落地路径
B站AI Agent零基础全套教程深度解析:覆盖LangChain、Coze、Manus、Dify、n8n与MCP协议,采用低代码与代码框架双线并行,扎根九大企业岗位,配四大实战项目,助你从AI使用者进阶为Agent开发者。