Nex N2 Pro深度实测:国产开源Agent模型真实表现如何?

Nex N2:一个专为Agent任务设计的国产开源模型家族
当所有人的目光还聚焦在各大厂商的闭源模型竞赛时,一个名为Nex AGI的中国团队悄然发布了一个极具野心的开源Agent模型家族——Nex N2。这不仅仅是一个"会思考"的模型,它的核心定位是"会行动"。
Nex N2专为编程、搜索、工具调用、深度研究和长程Agent工作流而构建。在AI领域,Agent(智能体)指的是能够自主感知环境、制定计划、执行行动并根据反馈调整策略的AI系统。与传统的单轮问答不同,Agent工作流强调多步骤、多工具的协同执行——模型需要像人类工程师一样,先理解任务目标,再分解为子任务,调用搜索引擎、代码执行器、API等外部工具,处理中间结果的错误和异常,最终交付完整输出。这种能力被认为是通向通用人工智能(AGI)的关键路径之一。
Nex N2与其他模型不同的是,它将所有这些能力统一到一个一致的推理循环中——分解目标、追踪当前状态、调整策略、验证结果并持续迭代。这对真实的Agent任务至关重要,因为最难的工作流从来不是单纯的"写代码"或"搜索网页",而是搜索上下文、编写代码、调用工具、调试错误、修改计划、最终验证输出的混合流程。
Nex N2模型架构与参数规格
Nex N2家族包含两个模型:
- Nex N2 Mini:350亿参数的MoE模型,约30亿活跃参数
- Nex N2 Pro:3970亿参数的MoE旗舰模型,170亿活跃参数
这里的MoE(Mixture of Experts,混合专家)是一种高效的模型架构设计,其核心思想是将模型参数分成多个"专家"子网络,在推理时只激活其中一部分。例如Nex N2 Mini拥有350亿总参数但仅30亿活跃参数,意味着每次推理只调用约8.6%的参数。这种设计使模型在保持大模型知识容量的同时,大幅降低了推理所需的计算资源。DeepSeek广告 V2、Mixtral等知名模型也采用了类似架构,MoE已成为当前大模型在性能与效率之间取得平衡的主流技术路线。
Pro模型基于QWen 3.5架构构建,支持文本和图像输入,具备推理、函数调用和结构化输出能力。上下文窗口为262K tokens。上下文窗口(Context Window)指模型单次推理能处理的最大token数量,262K tokens大约相当于一本中等篇幅的书籍。更大的上下文窗口意味着模型能在单次对话中处理更多信息——对于代码库分析、长文档理解和复杂Agent任务尤为重要。目前,Google Gemini已支持100万甚至1000万token的上下文窗口,Claude支持200K,GPT-4o支持128K。Nex N2的262K在绝对数值上不算落后,但在长上下文能力日益成为竞争焦点的当下,仍有提升空间。
最令人惊喜的是,Nex AGI团队宣布Nex N2 Pro在两周内完全免费使用,提供无限用量,这对开发者来说无疑是一个极具吸引力的尝鲜机会。
Nex N2 Pro官方基准测试数据
Nex AGI团队公布的基准测试数据相当亮眼:
- Browser Comp:超越Opus 4.7
- Terminal Bench:75.3分
- SWE Bench Pro:58.8分
- DeepSway:超越Kimi K2.6
- GDP EVOL:接近1600分
从官方数据来看,这是一个开源模型在与闭源巨头正面竞争的案例,同时也超越了DeepSeek V4 Pro和GLM 5.1等国产模型。
实际测试:编码能力与生成质量详细评估
前端代码生成能力实测
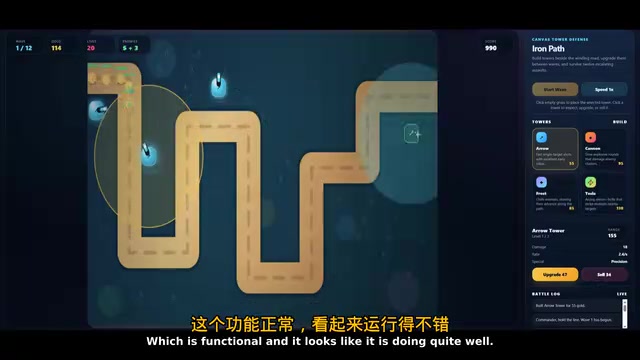
在实际测试中,Nex N2 Pro展现了不俗的前端代码生成能力。测试者要求它创建macOS克隆界面、Windows 95风格桌面、塔防游戏等复杂项目,模型都能给出功能性较强的输出。

你可能没注意到,当给予更详细的描述性需求时,模型能够很好地遵循所有要求——包括滚动触发效果、排版设计、动态运动效果等。Windows风格的桌面生成中,它甚至能编写出开始菜单、画图应用、计算器、MS-DOS提示符等多个功能组件。
输出风格分析:GPT蒸馏痕迹明显
一个明显的特征是,Nex N2的输出风格与GPT模型高度相似。从前端生成的UI元素、色调、文字字体到面板布局,都能看出明显的GPT风格痕迹。这强烈暗示该模型在后训练阶段对GPT风格输出进行了蒸馏。
知识蒸馏(Knowledge Distillation)是一种广泛使用的模型训练技术,通过让小模型(学生模型)学习大模型(教师模型)的输出分布来转移知识。当我们说"GPT蒸馏痕迹"时,指的是Nex N2可能在后训练阶段使用了GPT系列模型的输出作为训练数据或对齐目标,导致其生成风格、UI设计偏好甚至措辞习惯与GPT高度相似。这种做法在开源社区中并不罕见,许多开源模型都或多或少地借鉴了闭源模型的输出来提升自身质量,但这也引发了关于模型独立性和知识产权的持续讨论。
这并不一定是坏事——对用户而言,这意味着能免费获得接近GPT水平的输出质量。但这也解释了为什么它在某些演示中表现惊艳,却在更广泛的评估中表现不一致。
生成速度:自适应思考的代价
由于采用自适应思考模式,Nex N2在生成输出时可能极其缓慢。自适应思考(Adaptive Thinking)是一种动态推理策略,模型会根据问题的复杂度自动调整思考深度和推理步骤数量。简单问题快速作答,复杂问题则进行多轮内部推理、自我验证和策略调整。这与OpenAI的o1系列模型引入的"思维链"(Chain-of-Thought)推理理念一脉相承,但更进一步地将推理深度变为动态可调。
它会规划、推理、自检并迭代,这对Agent工作流是优秀的设计,但当你需要快速输出时,等待时间可能令人痛苦。其代价是生成延迟不可预测——用户可能在简单任务上也需要等待较长时间。
独立评测与官方基准的差距有多大?
这里需要特别指出的是,独立测试结果与官方宣称存在显著差距。在World of AI Benchmark独立评测中,Nex N2 Pro排名第12位,而官方声称它能与前五名前沿模型并驾齐驱。

测试者认为Nex N2存在一定程度的"Benchmark Maxing"(基准测试过度优化)现象。这是AI行业中一个日益严重的问题:模型开发者可能通过针对特定基准测试的数据分布进行过度训练、调整超参数甚至在训练数据中混入测试集相关内容来人为提升分数。这导致模型在基准测试中表现优异,但在真实世界任务中表现平庸。学术界将这种现象称为"teaching to the test"(应试教育),它使得基准分数的可信度大打折扣,也是为什么独立第三方评测变得越来越重要的原因。
在真实世界测试中,Nex N2 Pro的表现更加不一致,与官方数据所描绘的图景存在明显落差。
Nex N2 Pro综合评价与使用建议
核心优势
- 开源免费,两周无限使用
- 编码输出质量扎实
- 前端生成能力不俗
- Agent工作流设计理念先进
- 自适应思考模式适合复杂任务
现存不足
- 官方基准与实际表现有差距
- 生成速度较慢
- 输出一致性有待提高
- 明显的GPT蒸馏痕迹
- 262K上下文窗口相对有限
如何使用Nex N2 Pro
- 通过OpenRouter API访问
- 下载开源权重本地部署(Mini模型可量化至8-bit在消费级硬件运行)
- 通过World of AI Benchmark免费在线测试
总结:值得尝试但需保持理性
Nex N2 Pro是一个令人印象深刻、被低估且确实有用的模型,但不应盲目信任其官方基准数据。它在特定场景下(尤其是编程和前端生成)能提供接近前沿模型的体验,而且完全免费。对于开发者而言,趁着两周免费期深度体验一下,用自己的实际任务来检验它的能力,是最务实的做法。
国产开源模型的进步速度确实令人振奋,但保持理性评估、等待更多独立基准验证,仍然是面对任何新模型时应有的态度。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。