过程挖掘+联邦学习:工业IoT异常检测新突破
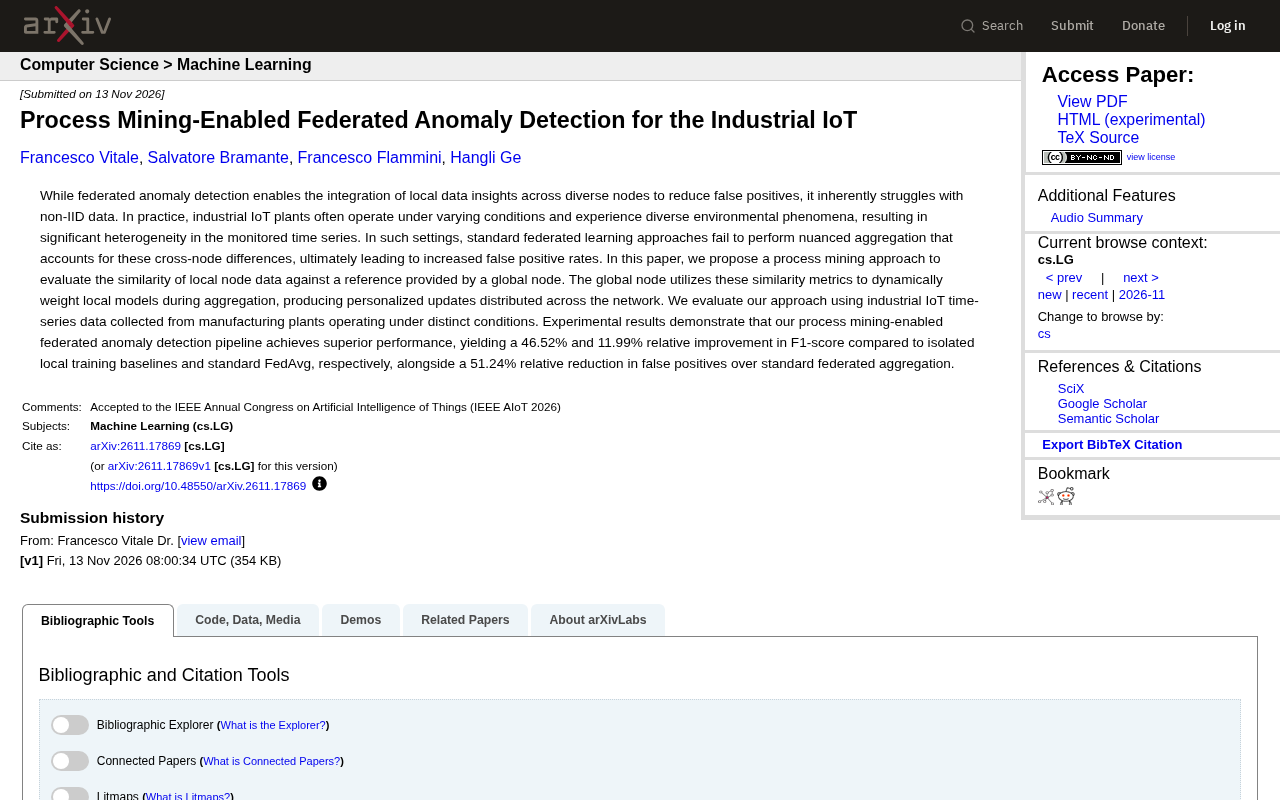
用过程挖掘量化节点相似度并动态加权聚合,缓解工业IoT联邦异常检测的non-IID误报问题。
文章介绍了一项面向工业物联网的联邦异常检测研究。工业设备时序数据因运行条件和环境差异呈现高度non-IID特性,标准FedAvg的均匀聚合无法捕捉节点间分布差异,反而推高误报率。该论文引入过程挖掘,从本地节点的事件序列中提取行为模式,计算其与全局参考基准的相似度,并据此对本地模型动态加权聚合,相似度高者权重更大,差异大者获得个性化更新。在来自不同工况制造工厂的真实工业时序数据上,该方法相较孤立本地训练F1相对提升46.52%,相较标准FedAvg提升11.99%,误报率相对降低51.24%,且全程不共享原始数据,符合工业隐私要求。文章也指出其对可靠全局参考的依赖及规模化计算开销尚待验证。
工业物联网(IIoT)设备产生的时序数据往往因运行条件和环境差异而呈现高度非独立同分布(non-IID)特性,这导致标准联邦学习在聚合本地模型时难以兼顾节点间的异质性,进而推高误报率。一篇最新论文提出用过程挖掘(Process Mining)来量化本地节点数据与全局参考的相似度,并据此动态加权聚合,在真实工业时序数据上取得了显著提升。
联邦异常检测的non-IID困境
联邦学习允许多个节点在不共享原始数据的前提下协同训练模型,理论上能整合分散的洞察以降低误报。但论文指出,工业场景中不同工厂的运行条件、环境干扰和工况模式差异巨大,导致监控时序数据的分布显著不同。标准FedAvg(联邦平均)采用均匀或简单加权的方式聚合本地模型,无法捕捉这种跨节点差异,聚合后的全局模型反而可能放大误报。
这一问题在异常检测任务中尤为突出:异常本身稀少且形态多样,模型需要精细区分正常波动与真实故障。当节点数据分布偏移时,粗暴的聚合会模糊局部特征,使误报率上升。
FedAvg(联邦平均) 是联邦学习中最基础的模型聚合算法,由McMahan等人于2016年提出。其流程为:中心服务器将当前全局模型下发给选中的客户端,各客户端在本地数据上用随机梯度下降训练若干轮后上传模型参数,服务器按各客户端样本量占比对参数做加权平均,得到新一轮全局模型。FedAvg的核心假设是各节点数据近似独立同分布,因此简单平均即可逼近集中式训练的效果。但在non-IID场景下,各节点本地最优参数方向差异较大,直接平均会使全局模型偏向样本量大的节点、模糊小节点的局部特征,甚至出现“客户端漂移”导致收敛缓慢或震荡。这正是本文引入过程挖掘做动态加权所要解决的核心问题。
过程挖掘如何量化节点相似性
论文的核心思路是引入过程挖掘来评估本地节点数据与全局节点提供的参考之间的相似度。全局节点维护一个参考基准,各本地节点定期将自身数据特征与之比对,过程挖掘算法从事件序列中提取行为模式,计算相似性指标。
这些相似性度量随后被用于动态加权:与全局参考更相似的本地模型在聚合时获得更高权重,差异较大的节点则获得个性化更新。这样,聚合过程不再是“一刀切”,而是根据节点实际数据特性进行 nuanced 调整。最终,全局节点将个性化更新分发回网络,兼顾全局共识与本地适应性。
过程挖掘(Process Mining) 是一类从信息系统记录的事件日志中提取、分析和改进实际业务流程的技术,代表性方法包括过程发现(用Petri网、BPMN等模型还原流程)、一致性检查(比对日志与参考模型)和过程增强。其输入通常是包含案例ID、活动名称、时间戳的事件序列。在工业场景中,设备传感器与MES/SCADA系统会留下大量带时间戳的操作与状态事件,天然构成事件日志。本文正是利用这一特性,将节点的时序数据转化为事件序列,再通过过程挖掘提取其行为模式(如活动顺序、分支频率、循环结构),并以行为轮廓、对齐度等指标度量本地与全局参考的相似程度,从而把“数据分布是否接近”转化为可计算的流程相似度。
实验效果:F1提升与误报下降
研究团队使用来自不同运行条件下制造工厂的工业IoT时序数据进行评估。结果显示,与孤立本地训练基线相比,该过程挖掘驱动的联邦异常检测流程在F1分数上实现了46.52%的相对提升;与标准FedAvg相比,F1相对提升11.99%。同时,相较于标准联邦聚合,误报率相对降低51.24%。
这些数据表明,过程挖掘提供的相似性度量能够有效指导聚合权重分配,缓解non-IID带来的性能退化。你可能没注意到,该方法不依赖共享原始数据,符合工业场景对数据隐私的严格要求。
F1分数 是异常检测中常用的综合评价指标,为精确率(Precision)与召回率(Recall)的调和平均数,取值范围0到1,越接近1越好。精确率指被模型判为异常的样本中真正异常的比例,召回率指所有真实异常中被成功检出的比例。工业异常检测中异常样本极其稀少,若只看准确率,模型全部判为正常也能得到很高分数,因此F1更能反映真实检测能力。调和平均对两者中较低的一项更敏感,可避免“只报少量高置信异常”或“大量误报换取高召回”的偏科现象。本文报告的F1相对提升,即在该指标上相较基线按比例改善,同时配合误报率下降,说明方法在漏报与误报之间取得了更好的平衡。
对工业落地的启示
工业IoT异常检测长期面临数据孤岛与分布异构的双重挑战。该研究将过程挖掘这一业务流程分析工具引入联邦学习聚合环节,提供了一种轻量级的相似性评估手段。对于拥有多个生产基地的制造企业,这意味着可以在不集中数据的情况下,训练出更贴合各厂实际工况的检测模型。
不过,该方法依赖全局节点提供可靠参考,且过程挖掘的计算开销在节点规模扩大时的表现仍需进一步验证。论文未披露具体节点数量与部署成本,实际落地时需结合场景权衡。
总体而言,这项研究为联邦异常检测在非IID工业数据上的应用提供了新思路,实验数据也展示了可观的性能增益。后续工作可关注参考基准的动态更新机制以及跨行业迁移的泛化能力。
相关推荐
Vibe Coding之父的多模型策略:免费复制他的AI编程setup
Vibe Coding概念提出者从不信任单一AI模型,采用多模型分工——一个写代码一个审查。本文解析其免费可复制的多模型setup,以及单模型工具下架模型带来的风险与应对思路。
Cursor规则文件不生效?.mdc扩展名是关键
Cursor规则文件不生效?可能是扩展名问题。本文介绍如何通过.mdc文件和Always apply设置让规则在每个对话中自动生效,避免重复提醒AI,提升开发效率。
三款免费AI编程工具横评:Copilot、Cursor与Gemini CLI
对比 GitHub Copilot、Cursor 与 Gemini CLI 三款免费 AI 编程工具的免费额度、使用形态与适用场景,分析各自天花板,帮你按工作流选出最合适的 AI 编程助手。