gzip 也能当语言模型?压缩即预测的深层逻辑

从gzip与语言模型的类比出发,阐明压缩与预测在信息论上的本质等价关系。
本文以"gzip能否成为语言模型"这一反直觉问题为切入点,追溯了压缩与预测在信息论上的深层等价关系:对数据建模越准确,就能压缩得越彻底,语言模型训练的交叉熵损失与最优压缩的目标在数学上完全一致。文章介绍了gzip结合k近邻的文本分类实验及其背后的归一化压缩距离原理,说明一个无需训练的通用压缩器如何隐式扮演相似度模型的角色。进而分析了gzip基于LZ77滑动窗口和霍夫曼编码的机制局限——只能捕捉局部重复模式,无法建立长距离语义关联,与Transformer的全局注意力机制不在同一层级。文章最终指出,这场思想实验的真正价值不在于gzip能否替代GPT,而在于帮助我们从第一性原理重新审视大语言模型:其本质是一台极其精巧的、学会了预测下一个token的压缩机器。
一个反直觉的问题
当我们谈论语言模型时,脑海里浮现的往往是数十亿参数的神经网络、庞大的算力集群和复杂的注意力机制。但有一个看似荒诞的问题正在技术社区引发讨论:一个诞生于上世纪的通用压缩算法 gzip,能不能扮演语言模型的角色?
这个问题源自 Nathan 的一篇博客文章《Can gzip be a language model?》,该文在 Hacker News 上获得了 263 个点赞和 92 条评论,热度不低。它触及了一个深刻却常被忽视的原理——压缩与预测本质上是同一件事。
压缩与预测为何是一体两面
信息论奠基人香农早就揭示了这一点:一个能够很好压缩数据的模型,必然对数据的分布有良好的建模能力。压缩的核心是消除冗余,而消除冗余的前提是能够预测——如果你能准确预测下一个字符或单词是什么,你就能用更少的比特来编码它。
换句话说,压缩率越高,说明模型对数据的"理解"越深。现代大语言模型在训练时优化的交叉熵损失,本质上就是在最小化对文本的编码长度。GPT 系列模型可以被视为极其强大的、有损(或近似无损)的文本压缩器。这就是为什么会有人提出:既然压缩就是预测,那反过来,一个压缩算法能否被当作预测器、当作语言模型来使用?
这一等价关系有严格的数学基础。香农熵 H(X) 定义了一个随机变量所含信息量的下界,也就是无损压缩所能达到的极限。而语言模型输出的每个 token 的负对数概率之和,恰好就是对该序列的编码长度估计——这正是"困惑度"(Perplexity)指标的由来。困惑度越低,说明模型对文本的概率分布拟合得越好,等价于它能用更少的比特编码该文本。因此,训练一个语言模型让交叉熵损失最小,与训练一个最优压缩器让平均编码长度最短,在数学上是完全相同的优化目标。这一视角由 Kolmogorov 复杂度理论进一步推广:一段数据的"真正复杂度"被定义为能生成它的最短程序的长度,而智能系统可以被理解为在近似逼近这一理论极限。
gzip 分类实验的启示
这类讨论并非凭空而来。此前已有研究者展示过用 gzip 结合 k 近邻算法做文本分类,效果竟然能媲美一些神经网络方法。其原理是:如果两段文本属于同一类别,把它们拼接在一起压缩,压缩率会更高,因为它们共享更多的模式和冗余信息。
这个所谓的"归一化压缩距离"(Normalized Compression Distance)提供了一种无需训练、无需参数的相似度度量方式。gzip 在这里扮演的角色,正是一个隐式的"模型"——它对数据分布的建模能力被巧妙地转化为了分类能力。
归一化压缩距离(NCD)的公式为:NCD(x, y) = [C(xy) - min(C(x), C(y))] / max(C(x), C(y)),其中 C(x) 表示字符串 x 的压缩长度,C(xy) 表示两者拼接后的压缩长度。其直觉在于:如果 x 和 y 高度相似,压缩器在处理 y 时可以大量复用已经从 x 中学到的模式,拼接后的压缩文件不会比单独压缩大多少,NCD 接近 0;反之若两者毫无关联,NCD 接近 1。这一方法由 Cilibrasi 和 Vitányi 于 2005 年正式提出,其优雅之处在于完全无监督、无需任何领域知识,仅凭通用压缩器即可估计任意类型数据(文本、DNA 序列、音乐)之间的相似度。2023 年一篇论文展示了 gzip + kNN 在小样本文本分类任务上超越部分 BERT 变体,引发广泛讨论,但后续研究指出其在大数据集上的优势会显著减弱。
从压缩器到生成器的距离
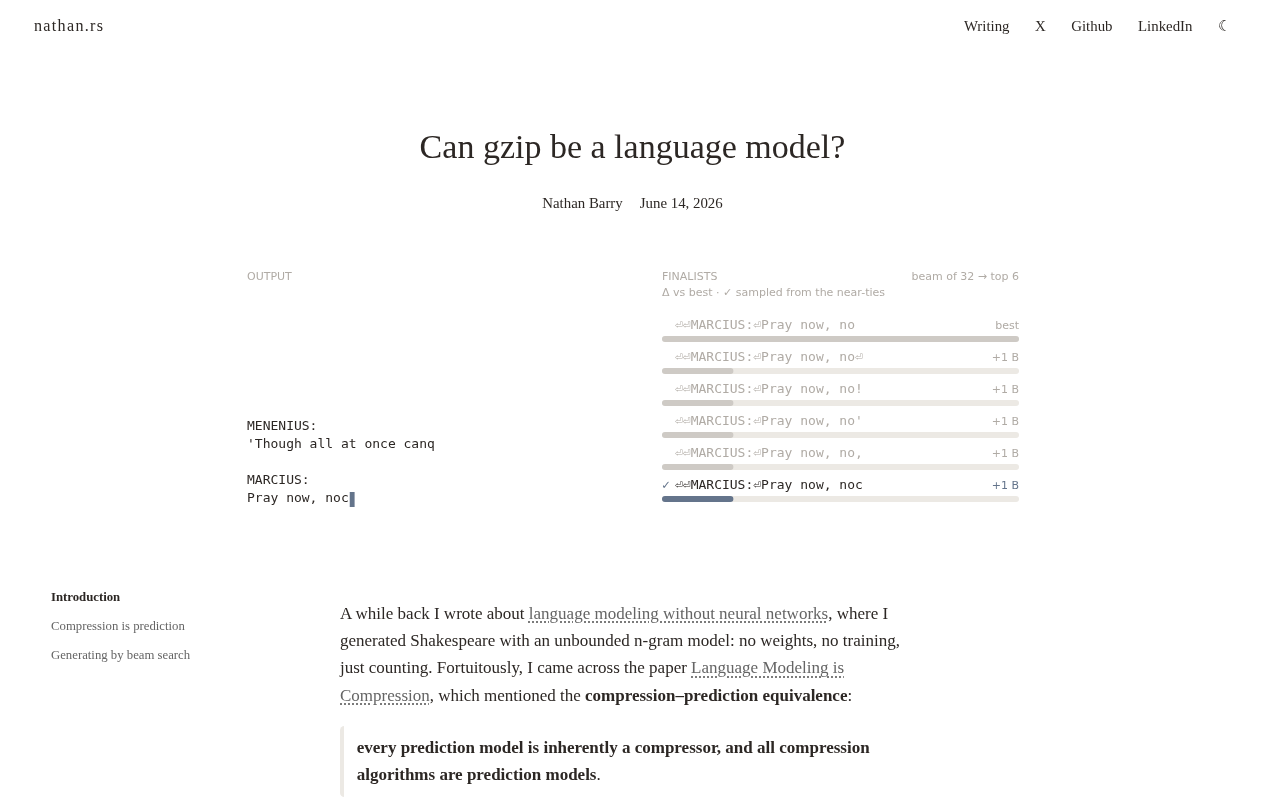
把 gzip 当作分类器已经令人惊讶,把它当作生成式语言模型则更进一步。理论上,任何压缩算法都对应着一个概率模型:压缩器给某段数据分配的编码长度,反映了它认为这段数据出现的概率。据此,我们可以反推出一个字符级或词级的概率分布,从而进行文本生成。
不过现实与理论之间存在鸿沟。gzip 使用的 DEFLATE 算法基于 LZ77 滑动窗口和霍夫曼编码,它捕捉的主要是局部重复模式,窗口大小有限(通常 32KB),无法建立长距离语义关联。这意味着即便它能生成文本,也只是在做低阶的模式复现,远谈不上理解语言的语法和语义。这与 Transformer 通过自注意力机制建立的全局依赖能力完全不在一个层级。
DEFLATE 算法由两个阶段组成。第一阶段是 LZ77:维护一个滑动窗口(标准 gzip 最大 32KB),将当前位置之后的字节序列与窗口内已出现的内容进行匹配,如果找到重复,就用"偏移量+长度"的指针替代原始字节,从而消除局部重复冗余。第二阶段是霍夫曼编码:对第一阶段输出的符号集构建可变长前缀码,让高频符号用更短的编码表示,进一步压缩输出体积。这两层机制决定了 gzip 的"语言模型能力"上限:它只能利用 32KB 窗口内的历史信息,无法感知段落级、篇章级的语义结构。相比之下,Transformer 的自注意力机制可以在整个上下文窗口内任意建立 token 之间的依赖,并通过数十亿参数将训练语料中的全局统计规律编码进权重,两者的建模能力存在本质差距。
这个思想实验的真正价值
讨论 gzip 能否成为语言模型,重点从来不在于它能否真的取代 GPT,而在于它帮助我们看清语言模型的底层数学本质。当一个技术被神秘化、被过度包装时,回到最朴素的信息论视角往往能带来清醒的认知。
对从业者而言,这个视角有几个实际意义:其一,评估模型质量可以从压缩率的角度切入;其二,在资源受限的场景,简单的压缩方法可能提供出人意料的基线;其三,它提醒我们,智能的很大一部分或许就是对世界规律的高效压缩。Hacker News 上的热烈讨论也反映出,工程师群体对这种"第一性原理"式的思辨始终抱有浓厚兴趣。
结语
gzip 当然不是也不会成为真正意义上的语言模型,它缺乏理解语义、处理长上下文和泛化的能力。但"压缩即智能"这一命题的价值,在于它把神经网络从神坛拉回到坚实的理论地基上。当我们下次惊叹于大模型的能力时,不妨记得:它归根结底,仍然是一台极其精巧的、学会了预测下一个 token 的压缩机器。
相关推荐

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。

Antigravity 2.0 保姆级教程:MCP、Skill与自动化全解析
Antigravity 2.0 保姆级教程,详解项目/会话/Agent 三大核心概念、消息队列与权限设置、自动化任务、MCP 连接 Figma、Skill 专业技能,并演示设计稿转代码、Android 应用生成、产品页 1:1 复刻等 6 个实战案例。