HAIDL:将人机交互升级为可复现的结构化数据

论文提出将人机交互视为一等数据,用HAIDL语言和JupyterLab中间件实现结构化记录与分析。
文章介绍了一项将人机交互提升为“一等数据”的研究。当前AI助手在JupyterLab等环境中的交互多为瞬态交换,上下文散落于聊天历史,损害复现性、可解释性、行为分析与自适应支持。论文提出HAIDL交互描述语言,借鉴BNF思想把每次交互编码为包含计算上下文、用户请求、提示载荷、AI响应、反馈、问题上下文、来源与模型元数据的结构化对象,使其可存储、检索、重放与分析。配套的HAIDL-X作为JupyterLab中间件,在后台自动捕获并存储交互,降低采集成本。其上的学习层将交互对象与notebook执行轨迹映射为参与度、表现、求助行为、错误应对方式及学习persona等可复现度量。该方案为AI协作工具提供了数据架构层面的设计参考,但当前适用范围限于JupyterLab生态。
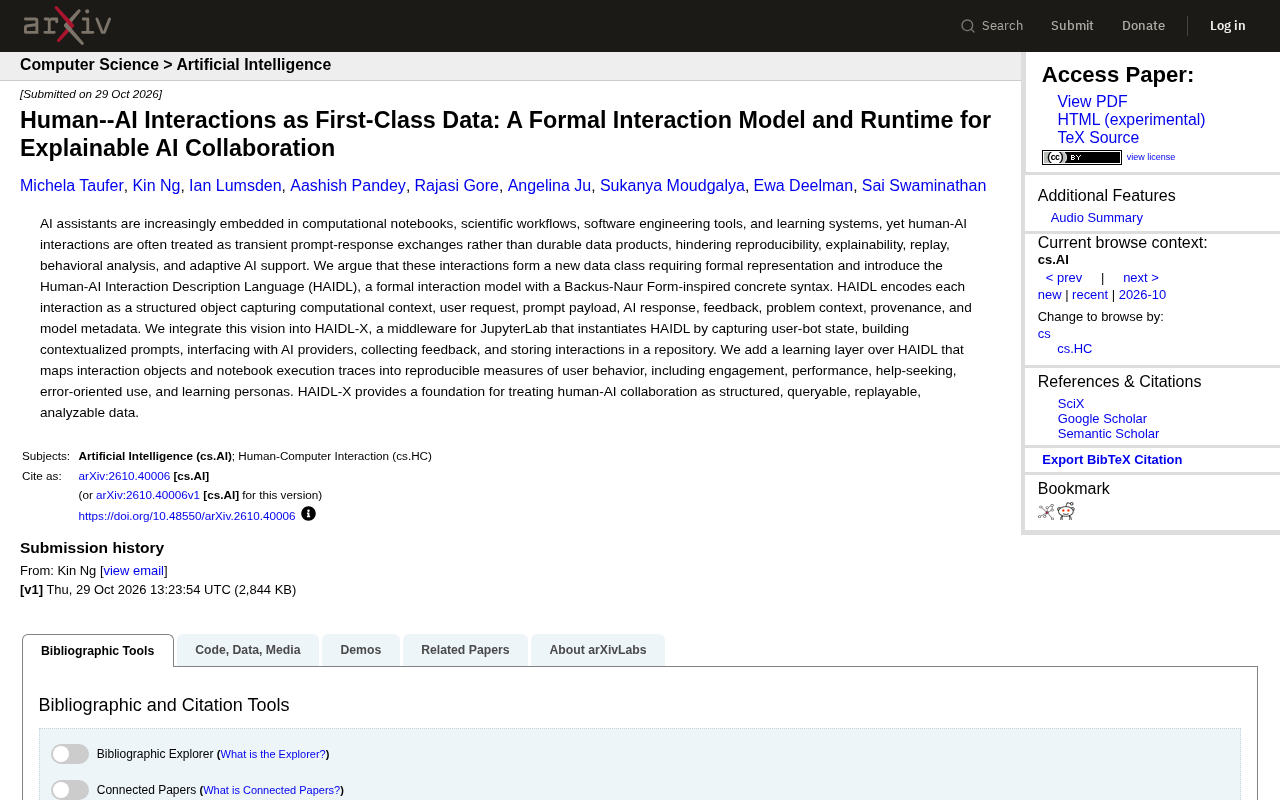
AI助手已经深度嵌入计算笔记本、科学工作流、软件工程工具和学习系统,但大多数工具仍把人机交互当作一次性的“提示-响应”交换,用完即弃。这种处理方式让复现、可解释性、行为分析和自适应支持都变得困难。一篇新论文提出,人机交互应当被视为一种新的数据类别,需要形式化表示,并给出了名为HAIDL的交互描述语言以及配套的JupyterLab中间件HAIDL-X。
为什么人机交互需要“一等数据”地位
当前AI助手在JupyterLab等环境中的交互记录通常只存在于聊天历史里,缺乏结构化上下文。用户当时在哪个notebook单元格、运行了什么代码、遇到了什么错误、AI给出了什么建议、用户是否采纳——这些信息要么散落各处,要么根本没有被记录。
论文指出,这种“瞬态交换”模式直接损害了几个关键能力:复现性(无法重放AI辅助的完整过程)、可解释性(无法追溯AI建议的上下文依据)、行为分析(无法量化用户如何寻求帮助)以及自适应支持(系统无法根据历史交互调整策略)。把交互提升为持久化数据产品,才有可能系统性地解决这些问题。
HAIDL:用类BNF语法描述每次交互
HAIDL(Human-AI Interaction Description Language)的核心思路是把每次交互编码为一个结构化对象。这个对象包含多个字段:计算上下文、用户请求、提示载荷、AI响应、反馈、问题上下文、来源信息以及模型元数据。
论文借鉴了Backus-Naur Form(BNF)的思想,为HAIDL设计了具体语法。这意味着交互记录不再是自由文本,而是可解析、可查询的结构化数据。每个字段都有明确的语义边界,使得不同工具、不同时间产生的交互可以在同一套框架下比较和聚合。
这种形式化带来的直接好处是:交互对象可以被存储、检索、重放,也可以作为下游分析的输入。作者强调,这是将人机协作视为“结构化、可查询、可重放、可分析”数据的基础。
Backus-Naur Form(BNF)是计算机科学中用于描述编程语言语法的元语法(meta-syntax)记法,由John Backus和Peter Naur在20世纪50年代末提出,最初用于定义ALGOL 60的语法。BNF通过一组产生式规则(production rules)将语法结构拆解为终结符(terminal symbols)和非终结符(non-terminal symbols),规则形式通常为 <non-terminal> ::= <expression>。其核心价值在于:用极少的记法约定就能精确、无歧义地刻画一种语言的合法结构,使语法可被机器解析,也便于不同实现之间共享同一份规范。在HAIDL中借鉴BNF思想,意味着交互对象的字段结构、嵌套关系和取值约束都可以用简洁的规则显式写出,从而让交互记录从自由文本变为可校验、可解析的结构化数据,并为跨工具的互操作性提供共同语法基础。
HAIDL-X:JupyterLab中的运行时实现
为了验证这套模型,作者构建了HAIDL-X——一个JupyterLab中间件。它负责在真实交互中实例化HAIDL:捕获用户与bot的状态、构建带上下文的提示、对接AI提供商、收集反馈,并把交互存入仓库。
HAIDL-X的价值在于它把形式化模型落到了实际工作流里。用户不需要手动填写结构化字段,中间件在后台完成捕获和存储。对于研究者来说,这意味着可以在不干扰用户自然操作的前提下,获得高质量的交互数据。
JupyterLab是Jupyter项目的下一代Web交互式开发环境,在经典Notebook基础上扩展为可多面板布局的工作台:左侧可同时打开文件浏览器、控制台、终端,中央区域可并排摆放notebook、文本编辑器、数据查看器等组件。其架构关键在“扩展系统”——JupyterLab本身是一个内核与前端分离的容器,第三方可以通过TypeScript/JavaScript扩展(extension)挂载到前端,监听单元格执行、内核状态、文档切换等事件,并在UI中注入自定义面板或按钮。这种“事件可订阅、UI可插拔”的机制,正是HAIDL-X能以中间件形式在后台无感捕获用户与AI交互、绑定单元格上下文、并把结构化记录写入仓库的技术前提。
学习层:从交互数据到可复现的行为度量
论文在HAIDL之上增加了一个学习层,把交互对象和notebook执行轨迹映射为可复现的用户行为度量。这些度量包括参与度、表现、求助行为、面向错误的使用方式,以及学习persona(用户画像)。
这一层的意义在于,它把原始交互记录转化为有解释力的指标。例如,通过分析用户请求和后续代码执行的关系,可以判断用户是独立解决问题还是依赖AI;通过反馈字段和错误上下文,可以识别哪些交互真正帮助了用户。由于底层数据是结构化的,这些度量本身也是可复现的——换一个研究者用同一份交互仓库,应当能得到一致的结果。
Notebook执行轨迹(execution trace)指的是在notebook中按时间顺序记录下来的单元格执行事件序列,包括每个单元格的输入代码、执行次序编号、执行时间戳、内核状态变化以及输出或异常信息。与静态的notebook文件不同,执行轨迹保留了“实际发生了什么”的时序信息,例如同一单元格被反复修改重跑、错误后回退到之前的单元格、或跳过某些单元格执行。在HAIDL框架中,执行轨迹与交互对象相互对齐,使得“用户在哪一步遇到错误、AI建议何时出现、建议后用户是否修改并重跑”这类因果链条可以被还原,这也是学习层能够计算求助行为、错误应对方式和参与度等度量所依赖的底层证据。
对AI协作工具设计的启示
这项工作传递出一个明确信号:AI助手的产品设计不应只关注单次回答的质量,还应关注交互记录的数据架构。当交互成为一等数据,工具就能支持回放调试、行为审计、个性化适配,甚至跨会话的学习迁移。
对于构建AI编程助手或教育类AI产品的团队来说,HAIDL的思路值得借鉴:提前定义交互的数据模式,比事后从日志里拼凑上下文要可靠得多。当然,这套方案目前聚焦于JupyterLab生态,能否推广到更广泛的IDE和对话式界面,还需要进一步验证。
相关推荐

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。

Salesforce 3.75亿美元收购Rune,AI物流技术补强国防业务
Salesforce 据报道以 3.75 亿美元收购国防科技初创公司 Rune,这家 AI 物流公司的技术将用于补强 Salesforce 的 Missionforce 国防平台,也延续了 Salesforce 近期的并购节奏。

Mistral Large 4开源万亿参数,微软6万员工自愿离职
Mistral Large 4 开源万亿参数多模态模型,编码智能体评测得分 48;闪迪财报显示 AI 推理重塑 NAND 需求;谷歌 Gemini 上线应用内文件编辑,OpenAI 上调 Codex 额度,微软向 6 万员工提供自愿离职方案。