Haiku 5.5深度评测:Anthropic终于有了一款值得用的小模型

Haiku 5.5以75%降价填补Anthropic小模型短板,最佳用法是作为子agent配合Opus并行试错。
Anthropic发布的Haiku 5.5终于填补了其产品线长期存在的小模型短板。核心卖点是激进定价:缓存读取仅1美分/百万token,整体成本较Haiku 4.5低约75%,但超过10万token上下文后价格骤涨5倍,以此引导用户将其用于短上下文高频任务。同期,Sonnet 5.5缓存读取价格腰斩至10美分/百万,与OpenAI GPT-6.1 Sol持平,理顺了整条产品线的定价逻辑。性能上,Haiku 5.5在开启推理模式时表现亮眼(Terminal Bench从0提升至近40%),但关闭推理后不如OpenAI同价位模型。创作者最核心的结论是:Haiku的价值不在于手动调用写代码,而在于作为子agent被Opus调度——并行试错场景下,Opus+10个Haiku仅花14美分,远低于Opus单独的47美分,且速度快三倍以上。
Anthropic的小模型困局终于被打破
长久以来,Anthropic在大模型领域一直表现强势——从早期的Sonnet 3.5奠定了工具调用(tool calls)的工程范式,到后来的Opus系列,再到最新的Opus 5.5和Sonnet 5.5。但它的产品线始终存在一个明显的短板:小模型。
上一代的Haiku 4.5刚发布时还算有些亮点,但很快就显得既贵又无用。这位YouTube创作者坦言,他甚至专门调整了自己所有的工具链、agent配置和Claude MD文件,明确告诉所有agent「不惜一切代价避开Haiku 4.5」。他的理由很直接:这个模型「几乎没用」,为了省钱,他宁可训练自己的Claude去调用Sol(OpenAI的模型),也不敢信任Haiku 4.5。
正是因为这段痛苦经历,他几周前公开吐槽:Anthropic没有一款值得用的小模型。而Haiku 5.5的发布,正是冲着这个「最大的缺失拼图」而来。
Haiku 5.5的定价才是真正的杀手锏
按照Anthropic官方的说法,Haiku 5.5是「我们发布过的最便宜、最快、能力最强的小模型」,专为高频、成本敏感的任务设计——摘要、压缩、数据库查询、分类请求等等。平均而言,它的运行成本比Haiku 4.5低约75%。
具体价格拆解很有意思:
- 缓存读取(cache reads):1美分/百万token,是Haiku 4.5的十分之一
- 缓存写入:12.5美分/百万token
- 普通输入:10美分/百万token
- 输出:50美分/百万token(上一代是5美元/百万,便宜了约20倍)
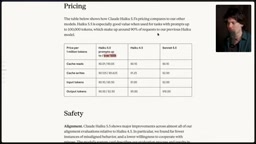
但这里有个关键的「门槛」:以上价格仅适用于10万token以内的上下文。一旦超过10万token,价格不是翻倍而是直接涨5倍——输出从50美分飙到2.5美元/百万,输入从10美分涨到50美分。
创作者对此的解读很到位:这是Anthropic在刻意引导用户。超便宜的低价区间(<100K)让人很难再有理由去调用其他API(比如GPT的小模型),因为「随手扔给Haiku就行」;而对超长上下文的高价则是防止用户在Claude Code里无节制地消耗,避免拖垮自己的利润。
Anthropic员工Lydia也公开建议:如果想控制账单,可以手动把Haiku 5.5的auto-compact窗口设为100K,这样就始终在便宜区间内运行,且该设置是按模型保存的,只影响Haiku(包括其子agent)。
缓存读取(Cache Reads) 是大模型API定价中一个容易被忽视但极为关键的成本项。当同一段上下文(如系统提示、代码库前缀、长篇文档)被反复送入模型时,服务商可以将其在服务器端缓存,后续请求只需支付"缓存读取"费用,而非重新处理全部token的"普通输入"费用。在agentic工作流中,主agent的系统提示和工具定义往往数万token,每次子任务都要携带这段上下文,因此缓存读取的调用次数可以远超普通输入,轻松占到总账单的30%–50%。这也是为什么Sonnet 5.5的缓存读取降价会让创作者如此激动——对高频调用场景而言,这一个价格变动对实际花费的影响,甚至比正常输入/输出价格更大。
一个被忽略的重磅改动:Sonnet降价
创作者在视频中半路「破防」——他发现这次发布悄悄藏了一个大新闻:Sonnet 5.5的缓存读取价格直接腰斩,从20美分/百万降到10美分/百万。
这恰恰是他之前在Sonnet 5.5评测中猛烈吐槽的点。此前Sonnet的缓存读取价格居然和Opus一样,而缓存读取通常占账单的30%到50%,这意味着在agentic工作场景下,Sonnet和Opus的实际价差小得可怜,Sonnet因此远不如OpenAI的6.1 Sol有吸引力。
降价后,Sonnet的缓存读取价格终于和GPT-6.1 Sol持平,整个产品线的逻辑一下子变得合理多了。他甚至直言,这可能才是本次发布中他最喜欢的部分。
性能表现:翻倍的进步与现实的局限
在创作者自制的benchmark套件中,Haiku 5.5在绝大多数项目上拿到了Haiku 4.5两倍以上的分数。几个值得注意的数据:
- Terminal Bench:从Haiku 4.5的0分一路提升到接近40%
- 代码能力:超过GPT-6 Luna(16.4%)的两倍以上
- Computer Use(计算机操作):表现惊艳,比6 Luna高出约40%,这在OpenAI长期领先的领域是个意外
速度方面,Haiku 5.5在不同供应商处能跑到100到200 TPS,创作者自己用Claude Code测试时稳定在180 TPS左右。
但也有不同声音。开发者Prime反馈,当他把推理(reasoning)关闭、作为Luna的drop-in替代用于自动化任务时,Haiku 5.5的通过率更差、失败率更高、速度也更慢。创作者对此并不意外——OpenAI的模型被专门训练得擅长「无推理」模式,而Anthropic的模型恰恰相反。Opus和Sonnet 5.5干脆取消了无推理选项,Haiku虽保留了这个选项,但在这个模式下表现并不好。结论是:开着推理用Haiku很香,关掉推理不如用GPT的Jev或Luna。
文中多次提及的 推理模式(Reasoning) 指的是让模型在给出最终答案之前,先输出一段内部"思考链"(chain-of-thought),以此提升复杂任务的准确率。Anthropic的Opus和Sonnet 5.5已将推理设为默认且不可关闭;Haiku 5.5虽然保留了关闭选项,但显然是针对"开推理"场景优化的。相比之下,OpenAI的小模型(如Luna、Jev)被刻意训练在不输出推理链的"直接响应"模式下也能高效工作,适合延迟极敏感、成本极苛刻的分类、路由任务。这种训练哲学的差异,导致两家模型在相同价位上各有擅长的工作负载,直接影响到替换方案的选择。TPS(Tokens Per Second) 则是衡量模型推理速度的常用指标,代表每秒能生成的token数量;Haiku 5.5在部分供应商处可达180 TPS,意味着即便开启推理,延迟依然可控。
Haiku的真正价值:当子agent,而不是主力
创作者反复强调一个核心观点:Haiku 5.5最佳的使用方式不是在UI里手动选中它来写代码,而是让你的agent和应用去调用它。

他对「用便宜模型写代码」这件事提出了尖锐的反驳:编程本身并不是让LLM变贵的原因。一旦上下文进入模型并被缓存,生成正确的代码文件其实相当便宜。真正烧钱的是其他环节——收集上下文、验证结果是否正确、编写大量测试代码、因为前七次错了而重新生成第八次。
「那500个输出token一旦输入被缓存,根本不贵。我不理解为什么大家都在找一个笨模型去做写代码这部分。」
Anthropic的官方demo很好地印证了Haiku作为子agent的价值。他们让Opus 5.5单独完成一个「鸡蛋安全降落」的模拟任务,又让Opus 5.5搭配10个Haiku 5.5子agent完成同样任务:
- Opus单独:3.5分钟,25次尝试,花费47美分
- Opus + 10个Haiku:不到1分钟,86次尝试,仅花费14美分

对于那些「大多数答案都是错的、需要大量试错」的任务——比如在庞大代码库里找一个文件,Haiku凭借便宜和快速的优势可以并行尝试多次,又不会造成惊人的账单。创作者总结:当更多次尝试比更聪明的尝试更有价值时,Haiku 5.5会碾压对手。
Multi-agent(多智能体)架构 是指由一个"主agent"(orchestrator)负责规划和决策,并在执行具体子任务时动态调用一个或多个"子agent"的系统设计模式。主agent通常使用能力更强、成本更高的模型(如Opus),而子agent负责执行并发、重复或低复杂度的工作(如搜索文件、读取文档、调用API、运行测试),因此可以用更廉价、更快的小模型承担。这种分工使得整体任务耗时和费用大幅下降——官方demo中,Opus单独完成任务花费47美分,而Opus调度10个Haiku子agent仅花14美分,且完成速度快了3倍以上。Haiku 5.5的价值正在于此:它不需要在每一步都"最聪明",只需要足够快、足够便宜,从而让主agent可以"广撒网"式地并行探索多条路径。
前端设计与真实demo的惊喜
社区成员做的几个demo让创作者印象深刻。社区的Arsh用Haiku编程生成的视频效果「贵得离谱地好」——仅花60美分API成本、20分钟内完成。创作者认为Anthropic模型在设计方面天生「有品味」,很可能是因为训练数据里有大量优质设计素材。
配合Design Skill技能后,Haiku的前端设计能力远超Grok 4.7。但关掉Design Skill后,就立刻退回到「经典LLM设计」的平庸水准,说明这个技能对Claude模型的加成极大。
不过在创作者的招牌测试「fish slop」小游戏里,Haiku 5.5暴露了短板:没有鼠标移动、没有声音、拐角逻辑有问题、第二波外星人攻击的时机不对。他的评价很精准:「它的下限没有Astra那么低,但它的上限只有Astra的十分之一。」 这次构建约花费1美元。
该不该用Haiku?该不该放弃Sonnet?
从artificial analysis的成本-智能图表看,加入完整数据后,Haiku 5.5几乎和GPT-6 Luna并驾齐驱。创作者的几个判断值得玩味:
- 如果纯粹按「每美元智能」优化,最优组合是GPT-6 Luna、GPT-6.1 Sol和Opus 5.5,加上被低估的开源模型Mimo V26 Pro
- 但如果你想在单一供应商体系内(比如只用Anthropic的API或Claude Code订阅),Opus + Haiku的组合已经非常合理,几乎可以完全跳过Sonnet
- Sonnet的真正价值不在于「填补Haiku和Opus之间的空档」,而在于它是一个「不同家族的视角」——就像请教一位在别家公司工作的朋友。创作者特别推崇用GPT-6.1 Sol做代码审计,让Opus写代码、Sol审查,PR上线速度大幅提升
你可能没注意到,Opus 5 low到Haiku 5.5 max的价差其实并不大(20美分 vs 55美分)。而且创作者亲身踩坑:当Haiku卡住自己、无法完成任务却烧掉大量token时,反而比直接用Opus更贵。他在用Haiku审计1500个PR时就遇到了GitHub速率限制,Haiku把自己困死了,而换成Opus后,模型反而「聪明地」想办法绕过了限制、合理分批调度子agent。
订阅用户的隐藏福利
本次发布还有一个对开发者友好的改动:订阅Claude 20X计划(200美元/月)的用户,每月额外获得200美元的API credit;5X用户获得100美元。这意味着你可以用这笔额度去vibe code一个内置Haiku或Sonnet的应用再分享给朋友。
创作者透露自己曾多次与Anthropic沟通这类集成设计,并对他们「真的在倾听」表示赞赏——本来可能变成一个糟糕决策的事情,最终变成了真正酷的功能。此外,Anthropic还更新了Python和TypeScript SDK,加入了对computer use和browser use的支持。
总结
回到创作者最初那句吐槽——「Anthropic没有一款值得用的小模型」。现在他的措辞变成了:「Anthropic现在有了一款有时候值得用的小模型。」
这是一个克制但真诚的评价。Haiku 5.5不会是你手动选来写代码或做前端的主力,但作为agent可以调用的工具——去收集数据、读文档、做分类、并行试错——它是一个极具性价比的补充。配合Sonnet降价,整个Anthropic 5.5产品线的定价逻辑终于理顺了。创作者最后放话:如果他是OpenAI,现在会「非常害怕」,并祈祷下一代Astra的训练能有突破。
相关推荐

OpenAI 推出 Decisions API:让 AI 在毫秒间做决定
OpenAI 推出 Decisions API,基于 GPT-6 Luna 运行,可在毫秒级完成文本与图像的智能决策,支持销售线索分流、车道判断、机器人控制等场景,速度较传统推理提升近十倍。

AssemblyAI自研客服Joey:解决率从10%飙升至80%
AssemblyAI每天收到1000次API注册却仅有一名接入工程师,团队基于Claude Agent SDK自研AI客服Joey,一周内将端到端解决率从10%提升到80%,月成本仅700美元。本文拆解其四层架构与dogfooding方法论。

AI Agent开发入门:企业级智能体学习路径全解析
一套面向零基础的AI Agent开发系统课程解析,涵盖基础原理、提示工程、工具调用、多智能体协同,以及LangChain、CrewAI、Dify等主流框架实战,帮助开发者系统入门企业级智能体开发。