HakemBench:土耳其语「类型化决策」基准测试解析

HakemBench 是首个面向土耳其语的类型化决策基准,兼顾准确率、校准度与选择性自动化三维评测。
HakemBench 是一个开源的土耳其语基准测试(CC BY 4.0),包含 2,346 条目、4,275 道题,覆盖事实核查、法律路由、内容审核等七大高风险决策场景。其核心创新在于评测框架:模型不仅需要给出答案,还要为每个选项输出概率,基准从决策质量(macro F1)、校准度(归一化 Brier 分数)和选择性自动化(风险-覆盖曲线)三个维度几何平均合成综合得分,并附带 bootstrap 置信区间和鲁棒性探针。值得注意的是,其黄金标签来自多模型评审团投票而非人工核验,存在模型偏好局限;发布方自家模型因训练数据污染主动标记受影响赛道,这种透明度在基准建设中较为罕见。该基准的方法论参考价值高于绝对排名数字。
什么是 HakemBench
HakemBench 是一个面向土耳其语的「类型化决策」(typed decisions)基准测试。它的核心任务模式与常见的问答基准略有不同:被测模型需要阅读一段文本、一个问题,以及一组固定的选项,然后为每个选项返回一个概率值,而非简单地给出一个唯一答案。
这种设计让 HakemBench 不仅能衡量模型答对与否,还能评估模型对自身判断的「信心」是否可靠——这正是真实业务场景中决策类任务最稀缺的能力。
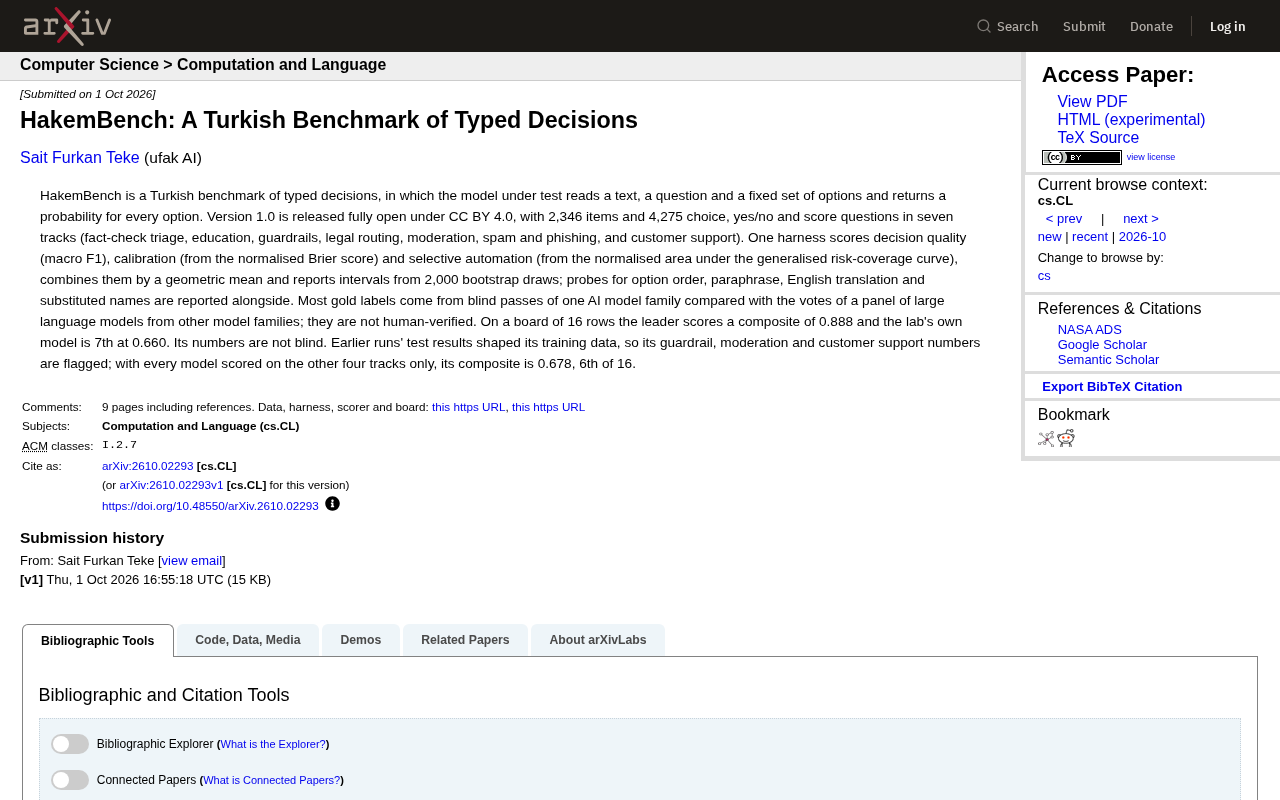
当前发布的 Version 1.0 以 CC BY 4.0 协议完全开源,包含 2,346 个条目、4,275 道题目,题型涵盖多选、是/否以及打分三类,分布在七个赛道(tracks)中。
「类型化决策」(Typed Decisions)是一种将决策输出结构化为带概率分布的离散选项的任务形式,区别于开放式生成任务。在这种范式下,模型不仅要选出最可能的答案,还要为每个候选选项赋予一个归一化的置信概率,这与分类任务中的 softmax 输出在形式上类似,但评测关注的是概率本身的质量而非仅仅是 argmax 是否正确。这种设计使得基准能够同时捕捉模型的判别能力与不确定性量化能力,后者在医疗诊断辅助、法律风险评估、内容合规审核等高风险自动化场景中至关重要——这些场景中一个过度自信的错误答案,其危害往往远大于一个诚实的"不确定"。
七大赛道与评测维度
覆盖的七个任务赛道
HakemBench 的七个赛道都紧贴实际应用场景:
- 事实核查分流(fact-check triage)
- 教育(education)
- 安全护栏(guardrails)
- 法律路由(legal routing)
- 内容审核(moderation)
- 垃圾信息与钓鱼识别(spam and phishing)
- 客户支持(customer support)
这些赛道大多属于需要「可信决策」的高风险领域,模型一旦出错或过度自信,都会带来实际成本。因此单纯的准确率不足以说明问题。
三位一体的评分框架
HakemBench 用一套统一的评测流程(harness)从三个维度衡量模型表现,再通过几何平均合成为综合得分:
- 决策质量:以 macro F1 衡量,关注模型在各类别上的均衡表现;
- 校准度(calibration):基于归一化 Brier 分数,衡量模型输出概率与真实正确率是否匹配;
- 选择性自动化(selective automation):基于广义风险-覆盖曲线下归一化面积,衡量模型在「可自动处理」与「需人工介入」之间的取舍能力。
综合得分还通过 2,000 次 bootstrap 抽样给出置信区间,并额外报告了针对选项顺序、同义改写、英文翻译和替换人名等扰动的鲁棒性探针(probes)。这套方法论的严谨程度,在小语种基准中并不多见。
校准度(Calibration) 是指模型输出的概率与其实际正确率的一致性。例如,一个校准良好的模型在输出"80%置信度"时,它在类似问题上的实际准确率也应接近80%。Brier 分数是衡量概率预测误差的经典指标,计算方式为预测概率与真实结果(0或1)之差的平方均值,分数越低越好。HakemBench 使用的是归一化版本,使得不同题型间的分数可以横向比较。
选择性自动化(Selective Automation) 则回答了一个更实际的问题:当模型被允许"拒绝作答"并将不确定的案例转交人工时,系统整体的风险-覆盖权衡是否合理?风险-覆盖曲线(Risk-Coverage Curve)以"模型自动处理的比例"为横轴、"在该覆盖率下的错误风险"为纵轴,曲线下面积越小代表模型在高置信度区间的判断越可靠。这一维度直接对应真实部署中"何时信任模型、何时升级人工审核"的核心决策。
关于标签来源的重要说明
HakemBench 在透明度上有一个值得警惕也值得称赞的细节:大部分黄金标签并非人工核验。
这些标签来自一个 AI 模型家族的盲测结果,再与来自其他模型家族的大语言模型评审团的投票进行对比得出。换言之,标签本质上是「模型共识」而非「人类共识」。
这意味着在使用 HakemBench 的分数时,需要意识到其评测的参照系本身带有模型偏好。对于法律、审核这类对标注质量极为敏感的赛道,这是一个必须纳入考量的局限。基准团队主动披露这一点,反而提升了结果的可解释性。
在 NLP 基准建设中,「黄金标签」(gold labels)通常指由人类专家标注、被视为绝对正确答案的参照数据。依赖模型共识来构建黄金标签是近年来因标注成本高企而兴起的一种替代方案,有时称为「LLM-as-annotator」范式。这种方法的优势在于规模化速度快、成本低,但其固有风险是:若多个评审模型共享相似的训练数据或价值观对齐方式,它们可能系统性地在同一类错误上达成共识,导致标签偏差难以通过「少数服从多数」的投票机制被发现。对于法律路由或内容审核这类任务,人类的规范性判断(如法律条文解释、文化语境下的冒犯性认定)与模型倾向之间可能存在系统性偏差,这是使用该基准时需要格外审慎的地方。
排行榜与「自评」问题
在 16 行的排行榜上,领先者取得了 0.888 的综合得分,而发布该基准的实验室自家模型排名第 7,综合得分为 0.660。
团队坦承,自家模型的成绩不是盲测的。更关键的是,早期测试结果曾影响过该模型的训练数据,因此它在安全护栏、内容审核和客户支持三个赛道上的分数被明确标记为「可能受污染」。
为了给出更公允的对照,当所有模型都只在其余四个赛道上计分时,该实验室模型的综合得分变为 0.678,排名第 6。这种对自身潜在数据污染的主动暴露,是基准建设中少见的自律做法。
为什么 HakemBench 值得关注
HakemBench 的价值不只在于填补了土耳其语评测的空白,更在于它示范了一种更成熟的基准理念:
- 不只看准不准,还看模型是否「知道自己可能错」;
- 用鲁棒性探针对抗数据泄漏与表面模式匹配;
- 对标签来源和自评偏差保持高度透明。
对于关注多语言 AI、模型校准以及安全/合规类部署的研究者和工程团队来说,这是一个方法论参考价值高于绝对分数的开源资源。随着越来越多应用进入高风险决策场景,像 HakemBench 这样强调校准与选择性自动化的评测范式,可能会成为未来基准设计的主流方向。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。