Harness工程:同一模型得分翻三倍的秘密
同一模型仅因外围harness不同,得分从13.3%升至38.3%,harness才是代理表现的关键。
文章指出,同一个前沿模型在相同谜题任务中,仅因外围工程代码(harness)设置不同,得分就从13.3%提升到38.3%,说明代理表现的关键变量往往不是模型本身。作者用「HARNESS」助记词拆解出七个组件:心跳循环、动作、读取上下文、笔记记忆、权限与护栏、验证、可观测性,并以退款支持代理为例逐一演示落地方式。文章还介绍了OpenAI在ARK AGI 3上的两个关键设置——跨步骤保留推理与历史摘要——并给出改进路径:读运行记录、一次只改一个变量、在相同任务上重新测量,追求能工作的最简单harness。
同一个前沿模型在同一个谜题游戏中,仅仅因为外围代码和设置不同,得分从13.3%飙升到38.3%。这个差距不是模型能力带来的,而是「harness」——包裹在模型外面的那一层工程代码。如果你在构建AI代理,理解和优化harness就是你的核心工作。
什么是Harness?
Harness直译是「马具」。一匹马力再大,没有马具,骑手可能被甩下来,马也会乱跑;有了马具,骑手才能驾驭这股力量。模型本身只会回复或请求工具调用,而harness就是围绕它的代码:执行工具、承载对话、决定工作何时停止。
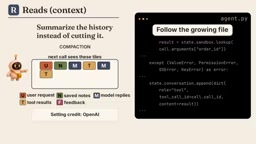
OpenAI在ARK AGI 3(来自ARC的谜题基准)的报告中给出了一个直观案例:它在自己的harness中打开了两个设置——跨步骤保留模型的推理过程,以及对历史进行摘要而不是直接截断。结果,在相同的输出token数量下,更好的harness让模型采取了更多动作、通过了更多关卡。
这个案例的核心启示是:当你的代理表现不佳时,先检查外围代码,而不是急着重写提示词。
ARC(Abstraction and Reasoning Corpus) 是2019年由François Chollet提出的通用智能评测基准,由一系列视觉网格谜题组成。每个谜题给出若干输入-输出示例,要求从示例中归纳出变换规则并应用到新输入上。它的设计刻意贴近“少样本归纳”这一人类强项,对依赖大规模预训练的模型构成挑战,因此常被用来衡量模型的抽象推理与泛化能力,而非记忆或语言流畅度。ARK AGI 3 是围绕该基准的评测尝试之一,其报告之所以被反复引用,是因为它把“同一模型、不同外围工程”的变量隔离得比较干净,得分差异可以较直接地归因于harness而非模型权重。
Harness的七个组成部分
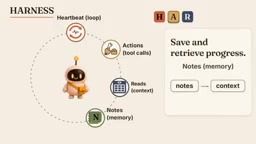
视频作者用一个助记词「HARNESS」来概括七个部分,每个字母对应一个组件:
- Heartbeat(心跳/循环):在调用模型和执行模型请求之间交替,直到得到最终答案或触及限制。
- Actions(动作):代理的「手」,即让它在真实世界中做事的工具调用。
- Reads(读取/上下文):模型每一步能看到什么,由harness决定。
- Notes(笔记/记忆):在模型视野之外存储进度,让工作跨步骤、跨会话存活,检索时再放回上下文。
- Enforce(执行/权限与护栏):三件事——谁可以做什么、运行代码能触及什么、进出时检查什么。
- Sanity check(验证):在代理交回答案前,比对答案与任务的检查。
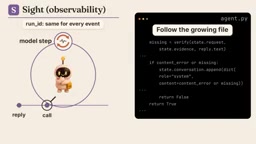
- Sight(可观测性):记录步骤,出错时你能看到哪里出了问题。
这七个部分构成了harness工程的完整框架。作者用退款支持代理为例,逐一演示了每个组件如何落地。
以退款代理为例:七个组件的实战
循环与动作
一个循环可能在没有进展的情况下持续运转,所以需要步数限制,并在同一失败动作重复时给出响应。作者加入了一个循环,每次携带对话调用模型,并设置步数上限;当同一调用连续失败两次后,插入提示要求换一种方法,但仍在原步数限制内。
工具调用是命名的结构化请求,代码必须检查并执行它。如果执行失败却没有有用反馈,下一次调用就缺少纠正请求的线索。因此需要加入输入检查、在try块中运行工具、把错误捕获为可读结果,再追加到对话中并链接回原始调用——真实模型才能据此尝试纠正。
上下文与记忆
随着运行推进,历史不断增长,必要时会被丢弃,下一次回复可能丢失先前工作依赖的信息。OpenAI的第二个设置——保留模型跨步骤的推理——本质上也是存储信息。作者的做法是:把对话列表显式化,加入一行清除不再需要的旧工具结果;其他技术包括按需加载和子代理摘要。长时运行的代理对上下文压力更大,这是独立的话题。
没有地方存储进度,后续调用就会丢失继续所需的信息。作者在开始时检索保存的笔记放回上下文,退出前保存进度笔记。对于退款代理,笔记可以保留正在处理的订单和工具确认的结果。
Compaction(历史压缩/摘要) 指的是当对话历史接近上下文窗口上限时,并非简单丢弃最早的消息,而是让模型把已有历史概括成一段更短、保留关键事实与决策的摘要,再以该摘要作为新的起点继续运行。它与“截断”的本质区别在于:截断会无差别丢失信息,模型可能忘记任务目标、已确认的参数或失败过的路径;摘要则试图保留对后续决策有用的部分。代价是摘要本身需要额外调用模型,且可能引入信息损失或偏差。OpenAI在ARK AGI 3中的实验表明,在相同输出token预算下,采用摘要而非截断能让模型完成更多有效动作,这说明上下文管理策略与模型能力是相乘而非相加的关系。
权限、沙箱与护栏
没有这些控制,动作可能超越用户权限,运行代码可能触及不应触及的资源,或让不允许的内容通过。作者在分发前加入权限检查,决定该用户是否可以对这笔订单请求此操作;执行通过沙箱路由,教学替身会检查文件路径和主机;再加一道护栏,按应用规则检查答案。护栏也可以检查传入请求和工具调用。沙箱并不决定客户是否有权退款——那是权限层的职责。
沙箱(sandbox) 是一种隔离执行环境,让代理生成的代码或工具调用只能访问被显式允许的资源,例如限定可读写的文件路径、限制可访问的主机和端口、约束可用的系统调用。它的目标是限制“破坏半径”:即使模型被提示注入误导或产生错误代码,影响也被圈定在隔离区内。需要强调的是,沙箱解决的是“能触及什么”的问题,而不是“该不该做”的问题——后者属于权限层与护栏层的职责。三者常被混为一谈,但边界清晰:权限决定某个主体能否发起某动作,沙箱决定该动作在技术上能碰到什么,护栏则在输入、工具调用与输出环节按业务规则做内容层面的拦截。
验证与可观测性
代理可能提前停止、工作未完成。在退款例子中,可能漏掉客户请求的一部分,或声称工具从未确认的退款。因此要在退出前对照请求检查可用的工具结果。如果失败,追加关于失败内容的反馈;若还有步数,把答案送回循环重试,且仍在原步数限制内。限制用尽则返回不完整结果。
可读的追踪帮助你找到运行出错的位置,而不是从最终答案猜测。作者在每一步周围加入追踪行,在同一运行标识下记录模型回复、工具请求、结果和检查。OpenAI团队正是通过阅读谜题尝试找到了修复方法。
不要从头写:SDK与自建的取舍
你不需要从零编写harness。Claude Agent SDK和OpenAI Agents SDK都提供了可构建的循环。Claude Agent SDK包含上下文管理、工具、权限和钩子,钩子让应用响应事件;OpenAI Agents SDK同样运行循环,并提供指令、工具、护栏和生命周期钩子。你仍然通过规则、工具、权限和钩子来塑造harness——这些应用决策始终是你的。
作者建议:需要完全控制时自己写;自己构建循环也是理解调用之间发生了什么的最好方式。
Agent SDK 中的“钩子(hooks)” 指在代理循环的固定生命周期节点上注册回调函数的机制,例如工具调用前、工具返回后、模型回复生成后、会话结束时。钩子让应用代码可以在不修改SDK内部循环的前提下注入横切逻辑:记录追踪、做权限校验、改写工具结果、触发外部通知或强制终止。它与“护栏”互补——护栏是判定规则,钩子是规则被挂载和执行的位置。理解钩子的触发时机,是判断一段harness逻辑应该写在循环内还是挂在钩子上的关键;写错位置会导致检查发生在错误的阶段,例如在工具已执行后才做权限判断。
如何改进你的Harness
作者给出的改进路径很务实:
- 跑真实任务,读运行记录,尤其关注出错前的几步。
- 找到可能解释行为的harness选择:结果是否消失了?工具失败了还是循环在重复?
- 一次只改一件事,然后在相同任务上用对应用重要的指标重新测量。
- 保留有效改动,用记录的步骤理解差异。
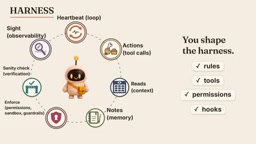
模型能力提升后,还要重新测试harness:检查继承的规则和辅助代码在你任务上的表现,移除模型不再需要的,补充新模型需要的,验证效果后再保留。目标是「能工作的最简单harness」,让每段代码都在你读过的运行记录中证明自己的价值。
核心结论
同一个模型,外围代码决定了表现差距。当代理卡住时,读运行记录,检查你的harness在下一步携带了什么。这比反复打磨提示词更接近问题的根源。
相关推荐
万圣节扮什么?试试宇宙中最恐怖的东西:黑洞
万圣节装扮灵感:科普创作者建议扮成黑洞,并解释了潮汐力如何拉伸身体、奇点如何把物质挤压成一个点,以及什么是“意大利面化”。文章还分析了这一建议背后的科普传播思路。
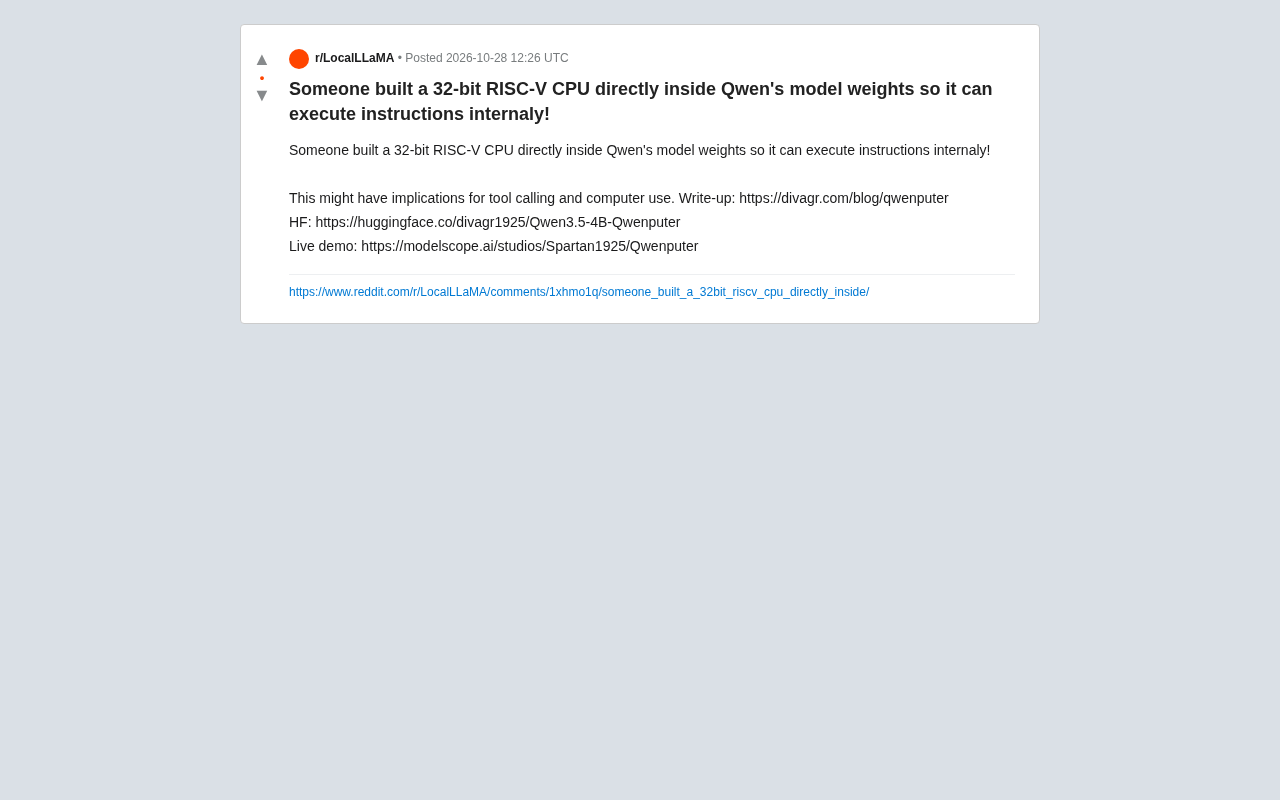
Qwen模型权重里塞进RISC-V CPU:AI执行指令新思路
Reddit热议项目Qwenputer将32位RISC-V CPU嵌入Qwen3.5-4B模型权重,使模型能内部执行指令。本文介绍项目背景、技术思路及其对工具调用和计算机使用的潜在影响。

Free Fire重返印度:Garena推本地化版本,四年禁令后回归
Garena旗下《Free Fire》在四年禁令后以本地化版本重返印度市场。本文分析其回归背景、本地化策略及对印度移动游戏竞争格局的影响。