合成查询多样性:是真有用,还是幻觉?
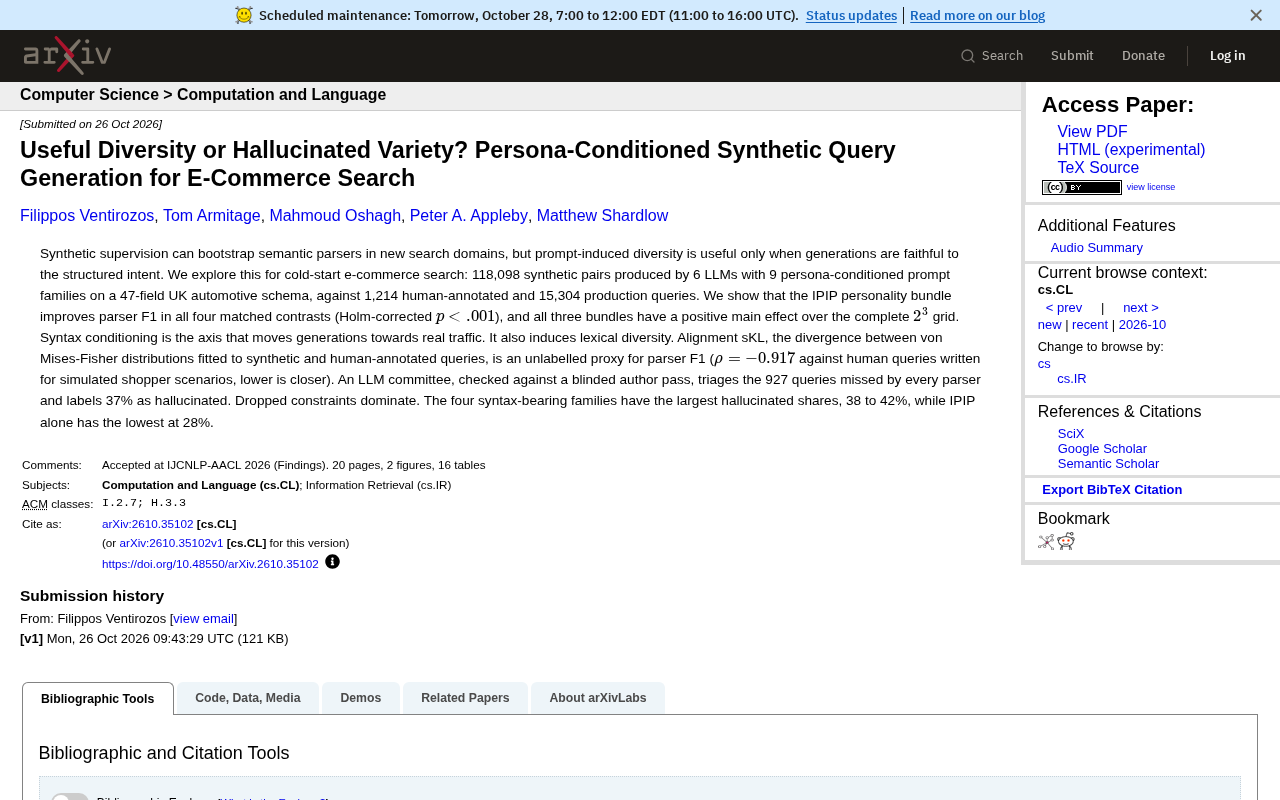
英国汽车电商研究量化合成查询多样性:人格与语法条件化提升解析器F1,但语法约束也放大约束丢失型幻觉。
一项针对英国汽车电商搜索冷启动的研究,用6个LLM在9组人格条件化提示下合成了118,098对查询-意图数据,并与人工标注及生产查询对比。结果显示,IPIP人格组合在全部四组匹配对比中显著提升语义解析器F1;语法条件化是推动合成分布对齐真实流量的关键轴,但同时也带来更高的幻觉风险——所有解析器漏掉的927条查询中37%被LLM委员会判为幻觉,主要形态是丢失约束。研究提出对齐sKL这一无标签代理指标,可在训练前预判合成数据质量。结论是合成数据管线应从“生成更多”转向“生成后可验证”。
电商搜索的冷启动难题,通常卡在标注数据上。用大模型合成查询来训练语义解析器,看起来是一条捷径——但前提是合成的多样性得“有用”,而不是“幻觉出来的花样”。一篇针对英国汽车电商场景的研究,把这个问题拆开做了量化。
实验设计:多大体量的合成数据
研究构建了 118,098 对合成查询-意图数据,由 6 个 LLM 在 9 组人格条件化提示家族下生成,覆盖一个 47 字段的英国汽车 schema。对照组包括 1,214 条人工标注查询和 15,304 条生产环境真实查询。这个数据规模足以把“提示词多样性”和“生成忠实度”两个变量分开检验。
人格条件化的真实收益
最直接的结论:IPIP 人格组合在全部四组匹配对比中都提升了语义解析器的 F1(Holm 校正后 p<.001),而且三种人格组合在完整的 2³ 网格上都有正向主效应。这意味着人格条件化不只是让句子读起来更像人话,它确实把生成数据往结构化意图上推了一把。
但三种组合的作用并不对称。语法条件化才是把生成分布推向真实流量的那个轴,同时带来词汇层面的多样性。换句话说,真正有用的多样性来自结构与语法的约束,而非单纯的人格口吻变化。
IPIP(International Personality Item Pool)是一套公共领域的、用于测量大五人格特质的条目库。所谓“人格条件化提示”,是指在提示词中注入特定的人格描述(例如“你是一个严谨、有条理的人”),引导大语言模型以符合该人格风格的语气和表达方式生成查询。在本研究中,三种人格组合分别对应不同的大五特质组合,与语法条件化(如强制查询包含特定句法结构或字段约束)正交设计,从而能在 2³ 网格上分离二者的主效应与交互效应。
用无标签指标预测解析器表现
研究提出了对齐 sKL 这个指标:分别对合成查询和人工标注查询拟合 von Mises-Fisher 分布,取两者之间的散度。它不需要标签,却能作为解析器 F1 的代理指标——与针对模拟购物者场景撰写的人工查询对比时,相关系数达到 ρ=-0.917,数值越低表示越接近。
这个指标的价值在于,它让团队在训练解析器之前就能预判合成数据的质量走向,而不是等到跑完一轮训练才发现分布偏移。
von Mises-Fisher(vMF)分布是球面上的一种概率分布,可视为高斯分布在方向数据上的类比。将查询嵌入向量归一化到单位球面后,vMF 分布能刻画这些方向向量的集中趋势与离散程度。对齐 sKL(symmetric Kullback-Leibler divergence)即两个 vMF 分布之间的对称散度,用于度量合成查询与人工查询在嵌入空间中的分布差异。由于散度计算不依赖意图标签,因此可在解析器训练前作为数据质量的无标签代理指标。
被所有解析器漏掉的查询里藏着什么
研究用一个 LLM 委员会对全部解析器都漏掉的 927 条查询做分诊,并以盲审作者复核作为校验,最终把其中 37% 判为幻觉。幻觉的主要形态是“丢失约束”——生成查询把原始意图里的关键限制条件丢掉了,表面看句式丰富,实际语义已经跑偏。
分家族看,四个带语法条件的提示家族幻觉占比最高,达到 38% 至 42%;只用 IPIP 人格的家族最低,为 28%。这和前面“语法条件化带来多样性”的结论形成一对张力:语法约束把分布拉近真实流量的同时,也放大了约束丢失的风险。
“LLM 委员会”指让多个大语言模型独立对同一查询进行判断(如判断是否为幻觉),再通过投票或共识机制聚合结论的方法。其目的是降低单一模型判断的偏差,提高标注的可靠性。本研究中,委员会的分诊结果还经过作者盲审复核作为校验,以控制假阳性。
对冷启动搜索落地的启示
这项研究给出的实用判断是:合成查询的多样性需要被拆成“有用”和“幻觉”两部分来管理。人格条件化值得用,它能稳定提升解析器 F1;语法条件化对分布对齐更关键,但必须配套幻觉检测,尤其是针对约束丢失的检查。对齐 sKL 这类无标签代理指标,可以在训练前就筛掉明显偏离真实分布的生成批次。
对冷启动的电商搜索团队而言,这意味着合成数据管线的重心不是“生成更多”,而是“生成后可验证”。多样性本身不是目标,忠实于结构化意图的多样性才是。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
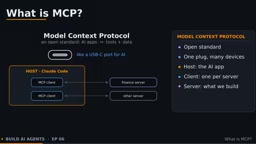
30行Python自建MCP服务器并接入Claude Code
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。