合成基准破解可解释AI评估难题:九种XAI方法测试揭示局限

论文提出基于合成真值与受控干预的XAI评估框架,揭示保真度指标的根本缺陷,并对九种主流解释方法进行严格基准测试。
可解释AI(XAI)领域长期面临一个评估困境:由于缺乏"真值解释",研究者只能用保真度(解释能否复现模型输出)来衡量解释质量,但这无法验证解释是否真实反映了模型的内部决策过程。针对这一问题,论文提出了一套基于合成数据和受控干预的评估框架:通过在数据生成阶段人为设定特征重要性,将评估问题从"无法验证"转变为"可以验证"。框架在二值图像、表格数据和时间序列三大数据域完成实例化,并对SHAP、LIME、LRP等九种主流XAI方法进行了测试。结果表明,当前技术存在显著局限——保真度高并不等同于解释质量高,这对医疗、金融等高风险决策场景具有直接的警示意义。
可解释AI评估的核心困境
可解释人工智能(XAI)近年来成为机器学习领域的研究热点,但一个长期被忽视的问题始终困扰着研究者:我们如何知道一个解释方法给出的解释是否真的正确?
问题的根源在于——缺乏可靠的评估流程,尤其是缺失所谓的"真值解释"(ground truth explanation)。当模型是一个黑盒时,我们并不知道它内部真正依赖哪些特征做决策,因此也就无法验证解释方法产出的结果是否忠实反映了模型的推理过程。
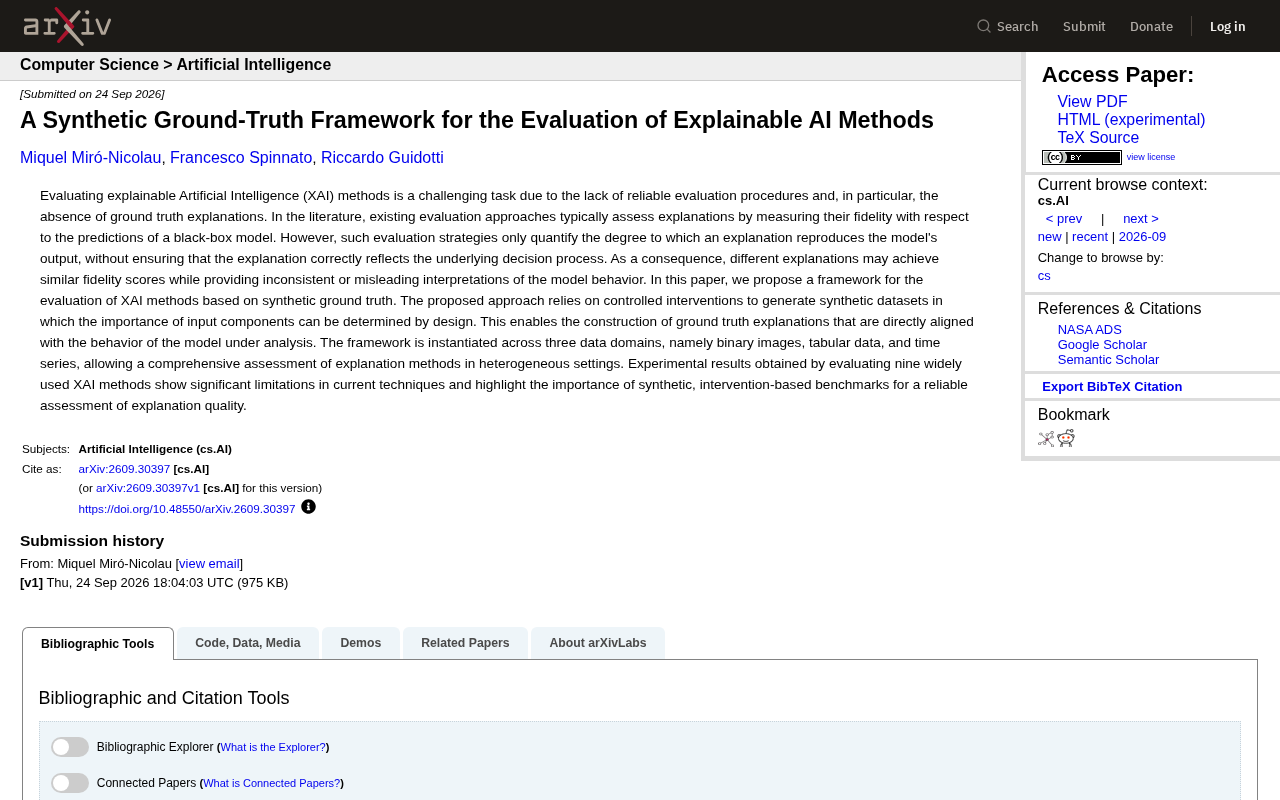
这篇发表于 arXiv 的论文(arXiv:2609.30397v1)正是针对这一痛点,提出了一套基于合成真值的评估框架,试图为XAI方法的可靠评估提供更坚实的基础。
现有评估方法为何不够可靠
目前学界评估解释质量的主流做法,是衡量解释与黑盒模型预测之间的保真度(fidelity)。简单说,就是看解释能在多大程度上复现模型的输出。
但论文尖锐地指出了这种策略的缺陷:保真度只能量化"解释是否能重现模型输出",却无法保证"解释正确反映了底层的决策过程"。这两者之间存在本质区别。
后果是显而易见的——不同的解释可能获得相近的保真度分数,但对模型行为却给出彼此矛盾、甚至具有误导性的解读。换句话说,你可能拿到两份分数差不多的"解释报告",它们讲述的却是完全不同的故事。这对于依赖解释来做关键决策的场景(如医疗、金融、司法)而言,是相当危险的。
保真度(fidelity)在XAI领域通常有两种具体形式:局部保真度衡量解释在单个样本附近是否能近似模型行为,全局保真度衡量解释在整个输入空间上的复现程度。常见的计算方式包括:在解释方法给出的"重要特征"子集上对模型输出进行扰动,观察预测结果的变化幅度。LIME、SHAP等主流方法在设计时本身就将最大化局部保真度作为优化目标,这也是为什么它们在保真度排行榜上往往占据领先位置——这种"自我背书"的评估逻辑,恰恰是论文所批评的核心问题所在。
用受控干预构建"已知答案"的数据集
论文提出的核心思路是:既然真实场景下没有真值,那就人为制造真值。
框架依赖于**受控干预(controlled interventions)**来生成合成数据集。在这类数据集中,每个输入分量的重要性是通过设计预先确定的——研究者从一开始就"知道"哪些特征应该重要、哪些不重要。
这一设计的巧妙之处在于,它使得构建出的真值解释能够直接与被分析模型的行为对齐。当我们既掌握数据生成机制、又能观测模型行为时,就有了一把可靠的"标尺"来衡量各种解释方法的表现。
这种以合成、干预为基础的思路,本质上是把评估问题从"无法验证"转变为"可以验证",为XAI评估建立了一个可复现的实验环境。
受控干预(controlled interventions)的思路来源于因果推断领域的干预演算(do-calculus)。在数据生成阶段,研究者显式地操控某些特征变量对标签的影响权重,从而在数据层面"编码"好特征重要性的真值。这与因果模型中的"do算子"逻辑一致:通过外部干预而非自然观测来确定变量间的因果关系,进而消除混淆变量的影响。类似的思路也见于鲁棒性评估中的"像素翻转"实验(pixel flipping)和"删除-然后-测量"(Remove and Retrain, ROAR)等方法,但论文的框架更进一步,将真值直接嵌入数据生成过程,而非依赖事后的代理指标。
三大数据域的全面验证
为了确保框架的通用性,作者将其实例化到了三个不同的数据领域:
- 二值图像(binary images):适合直观观察空间上的特征重要性分布
- 表格数据(tabular data):机器学习中最常见的结构化数据形态
- 时间序列(time series):涉及时序依赖的复杂场景
跨越这三种异构数据形态,意味着框架不是针对某一类特殊问题的"定制解法",而是能够在多样化环境中对解释方法进行综合评估。这种覆盖面对于验证方法的普适性至关重要。
九种主流XAI方法的测试结果
论文在上述框架下评估了九种被广泛使用的XAI方法。实验结果传递出一个值得警惕的信号:当前技术存在显著的局限性。
这一发现的意义在于,很多在保真度指标上表现优异的解释方法,在面对已知真值的严格检验时可能暴露出问题。这印证了前文的判断——高保真度并不等于高质量的解释。
作者据此强调,基于合成、干预的基准测试对于可靠评估解释质量具有重要价值。它不仅是一种新工具,更代表了一种评估范式的转变:从"能不能复现模型输出"转向"能不能真正解释模型决策"。
论文评估的九种XAI方法涵盖了当前学界最具代表性的技术路线:基于梯度的方法(如Vanilla Gradient、Integrated Gradients)、基于扰动的方法(如LIME、SHAP/KernelSHAP)、以及基于传播规则的方法(如LRP,即逐层相关性传播)。这些方法的设计假设各异——梯度类方法假设模型局部线性,扰动类方法通过采样近似特征贡献,传播类方法则沿网络层逐层分配"信用"。正因为出发点不同,它们在合成真值基准下的表现差异可以揭示各自假设在不同数据类型下的适用边界,而非笼统地给出一个保真度排名。
对行业与研究的启示
这项工作对XAI领域有几层现实意义。
对研究者而言,它提供了一个可以横向比较不同解释方法的公共标尺,有助于减少"各说各话"的评估乱象。对应用方而言,它提醒我们:不要盲目相信解释方法给出的结论,特别是在高风险决策场景中,解释的"看起来合理"和"实际正确"之间可能有巨大鸿沟。
当然,合成数据框架也有其固有局限——人为构造的数据与真实世界的复杂性之间始终存在差距,如何将这套评估思路迁移到真实业务数据上,仍是需要进一步探索的方向。但作为一个提供"已知答案"的受控实验环境,它无疑为XAI评估的严谨化迈出了扎实的一步。
相关推荐

Firebase AI Logic 实战:让 Gemini 返回结构化 JSON
本教程讲解如何在 Firebase AI Logic 中通过定义响应 Schema,让 Gemini 返回干净、可预测的结构化 JSON。涵盖字段定义、请求配置与解析流程,适用于 API、仪表盘、表单和自动化等场景。

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。