荷兰赌局测试:13个大模型为何单独提问时集体"赔付"

13个大模型在孤立逐题调用时均可被荷兰赌套利,问题不在于模型不懂概率,而在于调用方式本身。
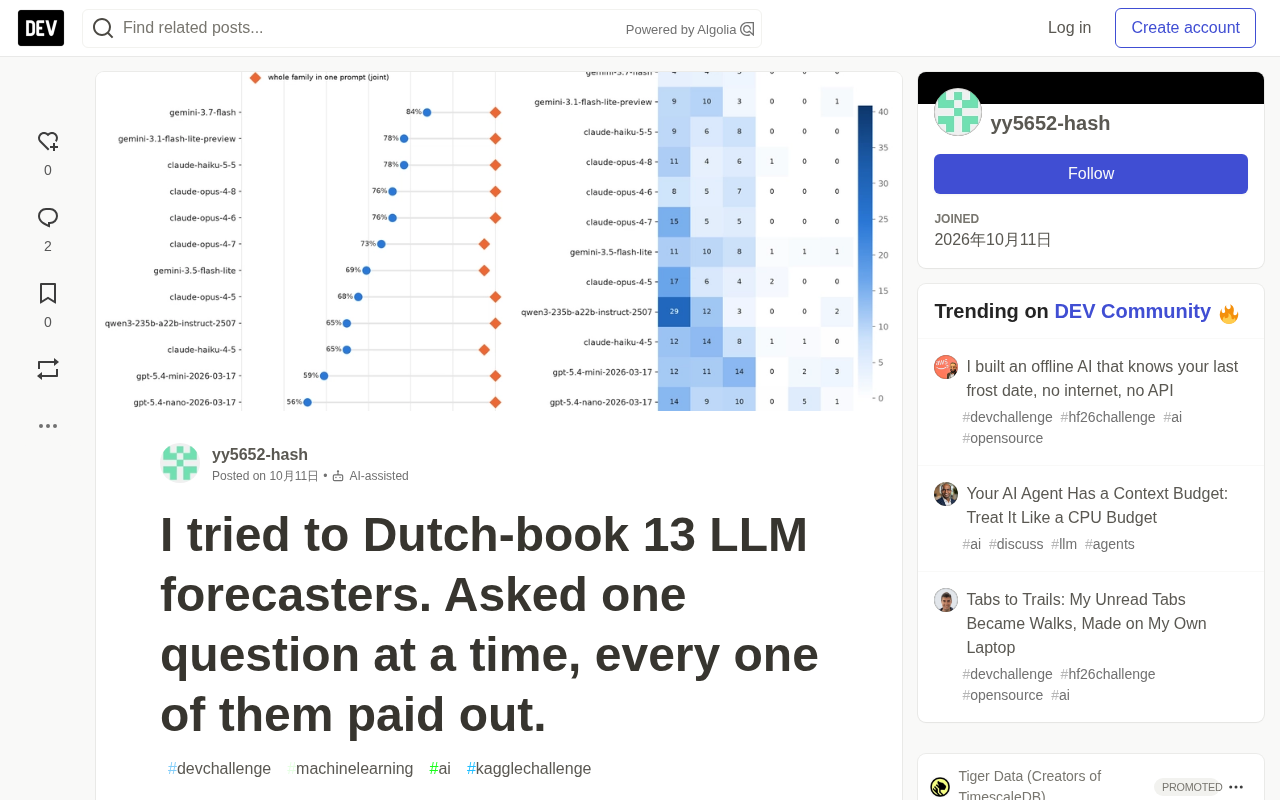
本文报告了一项针对13个主流大模型的概率自洽性基准测试。作者构建了37个"问题家族",每个家族从不同角度描述同一组可能世界,并分别以孤立提问(模拟真实预测机器人的调用方式)和联合提问两种模式测试模型。结果显示,所有模型在联合提问时自洽率高达95–100%,但一旦改为孤立调用,自洽率骤降至49–84%,意味着对手可通过荷兰赌套利稳赚不赔。问题根源不是模型不理解概率规则,而是跨对话时无法维持一致性。合取、划分、否定三类需要数字"加得起来"的问题是套利重灾区,而具有单调结构的阈值和期限题则几乎不受影响。价格最低的gemini-3.7-flash在一致性上击败了所有Claude Opus型号。作者建议开发者在单次调用中索要完整分布,或事后将结果投影到自洽概率集合上。
当预测机器人逐题提问时,概率为何不自洽
在 Metaculus 的 AI 预测锦标赛里,几乎所有预测机器人都遵循同一套流程:把每个问题扔进一个全新的对话里单独询问模型。这位开发者由此提出了一个尖锐的问题——当同一个事件从两个角度出现时,比如"2027年12月美国失业率是否≥5%"和"是否低于5%",模型给出的两个答案加起来真的等于100%吗?
如果不等于,这个预测器就是可被荷兰赌局套利的(Dutch-bookable)。一个庄家可以同时买卖它报出的合约,使得无论未来如何发展自己都稳赚不赔。德·菲内蒂(de Finetti)早在上世纪30年代就证明过:这种可套利性,恰恰定义了一组数字"不是概率"。
这个测试的巧妙之处在于:**你不需要知道未来,就能衡量预测的质量。**基准问的都是2027到2050年的事件,没有任何模型能靠记忆作弊,但答案今天就能打分。
荷兰赌局(Dutch Book)是概率论与博弈论中的经典概念,指的是一组赌注安排,使得无论实际结果如何,下注方都必然亏损。如果一个主体对同一事件给出的一组概率判断存在内在矛盾,精明的对手就能构造出这样一套组合合约,锁定无风险利润。德·菲内蒂的荷兰赌定理(Dutch Book Theorem)正式证明了其逆命题:一组信念能够免于荷兰赌套利,当且仅当它满足概率公理(非负性、归一性、可加性)。这意味着"可被套利"不仅仅是实践上的漏洞,更是该信念体系在数学意义上"根本不算概率"的判定标准。在本文的语境下,测试模型是否可被荷兰赌套利,等价于检验其输出是否真正构成自洽的概率分布,而非仅仅是一组听起来合理的数字。
37个问题家族与套利评分机制
作者构建了37个"问题家族",每个家族都是围绕同一组可能世界的一系列陈述。其中28个关于真实未来,另外9个是对照组(骰子、硬币、扑克牌),拥有精确答案。对照组的作用是把"算不出概率"和"在真正不确定时不自洽"这两种情况区分开。
六类家族各自对应一条一致性规则:
- 否定(negation):P(A) + P(非A) = 1
- 阈值(threshold):概率不能随阈值升高而增加(比特币高于5万/10万/15万/25万美元)
- 期限(deadline):概率不能随时间推移而下降(人类登陆火星 by 2030/2035/2040/2050)
- 划分(partition):所有互斥结果之和为1(2030世界杯冠军归属)
- 合取(conjunction):P(A∧B)≤min,P(A∨B)≥max
- 故事(story):加细节的版本不能更可能(经典的"琳达问题")
每条陈述都在全新对话中孤立提问(模拟机器人的真实调用方式),同时每个家族也会在一个提示里联合提问。每个模型约160次调用,温度设为0。
评分核心是一个"庄家能锁定多少利润"的指标:对每个家族,计算庄家在模型报价下交易最多1美元合约所能保证的无风险收益。通过线性规划对偶,这个值恰好等于模型答案到最近一组自洽概率的L1距离。排行榜分数就是无套利率——庄家最多只能锁定5美分的家族占比。一个覆盖率低于90%的模型(API出错、无法解析数字)直接不计分,避免把掉线误判为不一致。
"琳达问题"是认知心理学中最著名的实验之一,由特沃斯基(Tversky)与卡尼曼(Kahneman)于1983年提出,用于演示合取谬误(conjunction fallacy)。实验给被试描述一位热衷社会公正的女性林达,然后询问"林达是银行柜员"与"林达是女权主义的银行柜员"哪个更可能。大多数人选择后者,但根据概率公理,P(A∧B)≤P(A)永远成立,加入更多细节只能降低或维持概率,而不能提高它。本文将这一逻辑移植到预测场景:在星际旅行类问题中加入"乘坐SpaceX星舰"这一具体细节,若模型给出更高概率,即判定发生了合取谬误。高达96%的无套利率表明,大模型在这一经典陷阱上表现出乎意料地稳健。
13个模型的核心发现
作者在 Kaggle 每天10美元的额度内测试了四家厂商的13个模型,涵盖 Gemini、Claude、GPT 系列以及开源的 gpt-oss-20b 和 qwen3-235b。结果相当有启发性。
模型都懂概率规则,只是跨对话时不执行
在9个骰子扑克对照组上,全部13个模型几乎完美自洽(每家族≤1美分)。把整个家族放进一个提示里联合提问时,无套利率高达95–100%。可一旦改成每个陈述一个独立对话,这一数字骤降至49–84%。问题不在于模型无知,而在于"孤立"——而这恰恰是预测机器人调用模型的标准方式。
钱都藏在合取、划分和否定里
按家族类型统计孤立提问的无套利率,分化极其明显:
| 家族类型 | 无套利率(孤立) |
|---|---|
| 合取 conjunction | 49% |
| 划分 partition | 48% |
| 否定 negation | 60% |
| 阈值 threshold | 91% |
| 期限 deadline | 92% |
| 故事 story | 96% |
带有单调结构的期限和阈值问题,模型即使跨对话也能处理得不错。而三类带有"守恒律"(数字必须加得起来)的家族,正是庄家大快朵颐的地方。
最离谱的几个答案
几个具体案例令人瞠目:
- qwen3-235b 的地震合取题:P(2035年前加州7级以上地震)=0.18,P(关东7级以上)=0.35,但 P(两者都发生)=0.75,P(至少一个)=0.98。"两者都发生"竟比任一单项都更可能——每1美元合约可套利1.20美元,是本基准能给出的理论最大值。
- gpt-5.4-mini 关于登月:P(2029年前有人登月)=0.74,P(没人登月)也=0.74,两者相加达1.48。模型会"同意"任何向它展示的措辞框架。
- gpt-oss-20b 的2030世界杯划分题则走向另一个极端:六个穷尽的互斥结果加起来只有0.36。
最便宜的模型反而最一致
一个反直觉的结论是:价格几乎无法预测一致性。成本最低的 gemini-3.7-flash(2.0美分/家族)击败了所有 Claude Opus 型号(3.9–5.4美分)。唯一清晰的规律出现在底部——两个开源权重模型(gpt-oss-20b、qwen3-235b)最容易被荷兰赌局套利,几乎全拜合取题所赐。
此外作者也诚实地指出了方法论上的坑:在这个代理环境下,温度0并不等于确定性输出。默认模型在三次完全相同的运行中分别得到67.6%、75.7%和83.8%,单次排行榜数字大约携带±8个百分点的噪声,因此他把差距在10个点以内的结果都视为平手。
值得一提的是,经典的"琳达问题"基本被解决了——加上一个看似合理的细节("乘坐 SpaceX 星舰")几乎从不会提高概率估计,故事家族的无套利率高达96%。
给预测机器人开发者的实用建议
这份测试最终落到了可操作的工程建议上,这也是它超越单纯"刷榜"的价值所在:
- 对于多选题和数值题,应当在一次调用中索要全部选项或整条累积分布函数(CDF),然后重新归一化,而不是逐项分别提问。
- 对于其他任何情况,可以在事后把答案投影到自洽的概率集合上。由于真实结果一定是这个凸集的某个顶点,这种投影无论未来如何都不会让 Brier 分数变差。作者在 notebook 里用线性规划实现了这个投影。
未来的研究方向也已列出:测试同义改写的鲁棒性(否定题的失败看起来像一种"顺从"效应)、验证采样多次取平均能否恢复一致性,以及最关键的一问——一年后,当这些问题真正揭晓时,一致性能否预测准确性?
这项工作与 Paleka 等人的《Consistency Checks for Language Model Forecasters》一脉相承,但独特之处在于:精确答案的对照组、孤立对比联合的直接设计、一个能把任意事件家族转化为保证利润数字的通用线性规划,以及完整的 Kaggle 模型阵容。对于任何依赖大模型做概率估计的系统,这都是一个值得警惕的提醒:模型可能完全懂规则,却在你调用它的方式下系统性地违反规则。
Brier分数是预测准确性的标准评估指标,定义为预测概率与实际结果之差的平方均值:对于二元问题,若实际结果为1,预测概率为p,则单题Brier分数为(p-1)²;结果为0时为p²。分数越低代表预测越准确,完美预测得分为0,随机猜测约为0.25。文中提到的"投影到自洽集合不会让Brier分数变差"是一个重要的理论保证:由于真实结果恰好是自洽概率凸集的某个顶点(极端情形),将不自洽的概率向量投影到该凸集上,根据凸优化的性质,投影点与任意顶点的距离不超过原始点与该顶点的距离,因此事后归一化操作在期望意义上不会损害预测质量,这为工程上的后处理修正提供了严格的理论背书。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。