Headroom:为LLM输入瘦身,JSON令牌直降95%

Headroom在数据进入LLM前压缩令牌,编码代理减20%、JSON减60-95%,保答案质量。
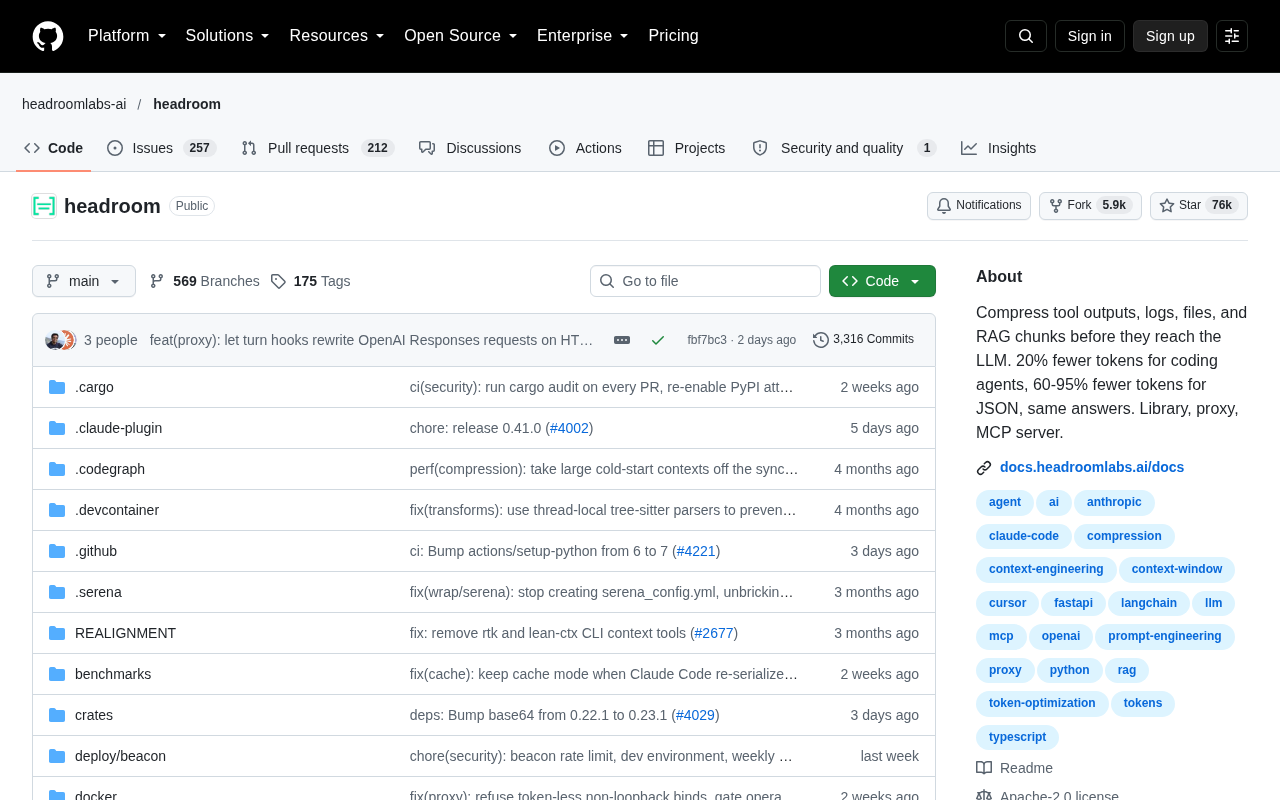
GitHub开源项目Headroom提出“前置压缩”思路,在工具输出、日志、文件和RAG分块进入LLM之前进行语义感知的压缩,从而大幅减少令牌消耗。据项目描述,编码代理场景令牌减少20%,JSON数据压缩率达60-95%,且保持答案质量不变。项目以Python实现,提供库、代理和MCP服务器三种集成方式,适配不同架构。Headroom已获超7.5万星标,今日新增317星,热度较高。其核心价值在于切中LLM成本优化刚需,但缺乏详细基准测试,实际效果需开发者结合场景验证。
在AI应用开发中,上下文窗口的消耗往往成为成本与性能的瓶颈。GitHub上名为Headroom的开源项目提供了一种新思路:在工具输出、日志、文件和RAG分块进入LLM之前进行压缩,从而大幅减少令牌数量。据项目描述,对于编码代理(coding agents),令牌数可减少20%;对于JSON数据,压缩率高达60-95%,同时保持答案质量不变。该项目以Python实现,已获得超过7.5万星标,今日新增317星,热度可见一斑。
压缩策略:在源头减少令牌消耗
Headroom的核心在于“前置压缩”。传统做法是将原始数据直接塞给LLM,导致大量无关信息占用上下文。Headroom则通过智能算法对输入进行精简,例如移除JSON中的冗余空格、合并重复键值、压缩日志中的重复模式等。这种压缩并非简单截断,而是保证语义完整性的前提下减少令牌。项目提供了三种使用方式:作为库集成到代码中、作为代理(proxy)拦截请求、或作为MCP服务器运行,灵活适配不同架构。
据项目文档,压缩后的数据仍能产生“相同的答案”,这意味着信息损失在可接受范围内。对于需要处理大量结构化数据的RAG应用,60-95%的令牌节省尤为可观,直接降低API调用成本并提升响应速度。
令牌(Token)与上下文窗口
令牌是LLM处理文本的基本单位,通常一个英文单词被切分为1-2个令牌,一个中文字符约占1-2个令牌。上下文窗口是模型单次调用能接收的最大令牌数,例如GPT-4为128K、Claude为200K。窗口大小直接决定了可放入的工具输出、日志和RAG分块总量。当输入接近上限时,要么截断丢失信息,要么拆分多次调用,两者都会增加成本或降低回答质量。因此,在数据进入LLM之前压缩令牌数,等价于在不扩大窗口的前提下提升有效容量,这是Headroom这类“前置压缩”方案的核心价值所在。
编码代理与JSON场景的显著收益
编码代理通常需要读取工具输出、文件内容和日志,这些数据往往包含大量样板文本。Headroom针对此类场景优化,实现20%的令牌减少。虽然比例看似不高,但在高频调用中累积效应明显。而JSON作为API交互的常见格式,其冗余性更高,Headroom的压缩效果达到60-95%,几乎颠覆了传统的数据传递方式。
项目作者强调,压缩过程不会改变答案的正确性。这得益于对数据结构的理解而非粗暴删除。例如,对于JSON,可以移除不必要的空白和重复的元数据;对于日志,可以聚合相似行。这种“语义感知”的压缩是Headroom区别于通用文本压缩工具的关键。
语义感知压缩与无损/有损边界
通用文本压缩(如gzip)以字节为单位,解压后必须完全还原原始内容;而LLM输入压缩只需保留对生成答案有影响的语义信息,属于“有损但任务无损”。Headroom对JSON移除空白、合并重复键值,对日志聚合相似行,都是利用数据结构的可预测性来剔除冗余,而非随机删减。其风险在于:某些元数据(如时间戳顺序、嵌套层级)可能对特定推理任务有用,压缩后答案虽“相同”却难以覆盖所有场景。因此开发者应针对自身数据做A/B验证,确认压缩前后答案一致性,再决定压缩强度。
三种集成方式:库、代理与MCP服务器
Headroom提供了三种灵活的集成路径。作为Python库,开发者可以在代码中调用压缩函数,直接处理待发送的数据。作为代理,它可以部署在LLM API之前,自动压缩所有经过的请求,无需修改应用代码。作为MCP(Model Context Protocol)服务器,它能够与支持MCP的AI工具链无缝对接,例如在Claude Desktop等环境中使用。这种多模态的集成设计降低了采用门槛,适应从原型到生产的各种场景。
项目采用Python编写,对于AI开发者而言上手容易。75970个星标和5911个fork表明其社区活跃度较高,今日317个新星也说明项目正处于上升期。不过,项目尚未提供详细的性能基准测试数据,实际压缩效果可能因数据特性而异,开发者需结合自身场景验证。
MCP(Model Context Protocol)
MCP是由Anthropic提出的一种开放协议,用于标准化AI应用与外部工具、数据源之间的连接方式。它定义了客户端(如Claude Desktop)与服务器之间的通信格式,使模型能够以统一接口调用文件系统、数据库、API等资源。Headroom作为MCP服务器运行时,可在工具返回结果给模型之前自动执行压缩,对上层应用完全透明。这意味着任何支持MCP的AI工具链都能零代码接入Headroom,无需关心压缩逻辑的实现细节。MCP的生态仍在扩展,将其作为压缩入口,有助于Headroom快速覆盖多样化的代理框架和IDE插件。
开源生态中的定位与展望
在LLM应用成本高企的当下,Headroom切中了“令牌优化”这一刚需。与单纯的提示词压缩不同,它专注于工具输出和结构化数据,填补了细分市场的空白。开源属性使其有望成为AI代理基础设施的一部分。未来,如果项目能补充更多真实场景的基准测试和案例研究,其可信度将进一步提升。对于追求降本增效的AI团队,Headroom值得关注和试用。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。