Hermes Agent完整教程:Windows WSL部署+微信连接指南

Hermes Agent 是什么?为何值得关注
作为继 OpenClaude 之后备受关注的 AI 智能体项目,Hermes Agent 近期在 GitHub 上迅速走红。
AI 智能体(AI Agent)背景:AI 智能体是一种能够自主感知环境、制定计划并执行多步骤任务的 AI 系统,与传统单轮问答式 AI 的根本区别在于它具备「自主行动能力」。技术上,智能体通常由大语言模型(LLM)作为「大脑」,配合工具调用(Tool Use/Function Calling)、记忆模块(Memory)和任务规划器(Planner)共同构成。代表性框架包括 LangChain、AutoGPT 和 Anthropic 的 Claude 工具使用体系。
AI 智能体领域经历了三个明显的发展阶段:早期的 ReAct(Reasoning + Acting)框架由 Google 和普林斯顿大学于 2022 年提出,首次系统性地将 LLM 的推理能力与外部工具调用结合,标志着智能体从「会思考」迈向「能行动」;2023 年 AutoGPT 的病毒式传播则让公众意识到 AI 可以自主分解并执行多步骤目标;到了 2024 年,以 Claude 的 Computer Use 为代表的多模态感知能力让智能体得以直接操控 GUI 界面,进一步拓展了可执行任务的边界。如果说第一代 AI 智能体解决了「能不能干活」的问题,那么 Hermes Agent 的核心卖点则是「越用越懂你」——它具备自我进化能力。
具体来说,当你让它完成一件复杂任务后,它会自动把执行过程总结成一个「技能」并保存下来。下次遇到类似任务时,无需重复教学,它可以直接调用。Hermes Agent 在此基础上引入了技能持久化机制,本质上是将执行日志压缩为可复用的结构化 Prompt 或代码片段,属于「程序合成 + 上下文蒸馏」技术方向的应用。
程序合成与上下文蒸馏:程序合成(Program Synthesis)是 AI 领域的经典研究方向,最早可追溯至 1960 年代的自动编程研究,目标是让系统从示例、规范或执行轨迹中自动生成可复用的程序逻辑。近年来,DeepMind 的 AlphaCode 和 OpenAI Codex 将神经网络与程序合成结合,使这一方向重新焕发活力。上下文蒸馏(Context Distillation)则是近年大语言模型领域的新兴技术,由 Anthropic 在训练 Claude 系列模型时广泛采用,核心思想是将冗长的 Few-shot 示例或复杂的推理链压缩为更紧凑的表示形式,减少推理时的 token 消耗。Hermes Agent 的技能持久化机制正是两者的结合:将一次完整的任务执行轨迹(包括中间推理步骤、工具调用序列和最终输出)压缩为结构化的 Prompt 模板或可执行代码片段,形成可跨会话调用的「技能库」。随着技能库的积累,系统的任务完成效率会呈现出类似「学习曲线」的指数级提升——这与人类技能习得中从「有意识胜任」到「无意识胜任」的过渡机制在形式上颇为相似。
更关键的是,这个技能并非一成不变,而是每使用一次就优化一次,越用越顺手。
除此之外,Hermes Agent 还会主动沉淀你的个人信息、项目背景、工作习惯和使用偏好。
记忆机制的实现原理:AI 智能体的记忆系统通常分为三个层次——短期记忆(当前对话上下文窗口)、长期记忆(持久化存储,如向量数据库或结构化文件)和技能记忆(可复用的操作程序)。这一分层架构的灵感部分来自认知科学对人类记忆的经典划分:工作记忆对应上下文窗口,情景记忆与语义记忆对应长期存储,程序性记忆则对应技能库。Hermes Agent 将个人信息和使用偏好写入 memory 文件,本质上是将关键信息序列化为文本或 JSON,并在每次对话时作为系统提示词(System Prompt)的一部分注入,从而绕过大语言模型本身无状态的限制。更先进的实现会使用 RAG(检索增强生成)技术:RAG 由 Meta AI 于 2020 年提出,工作流程分为两阶段——离线阶段将文档切片并通过嵌入模型转化为高维向量存入向量数据库(如 Chroma、Pinecone、Faiss);在线阶段将用户查询同样向量化,通过余弦相似度或 ANN 近似最近邻算法检索出最相关的 Top-K 文档片段后拼接进 Prompt 再交由 LLM 生成答案。值得一提的是,向量数据库的检索效率直接决定了记忆系统的响应延迟:HNSW(Hierarchical Navigable Small World)是目前主流向量数据库(包括 Chroma 和 Faiss)默认采用的索引算法,能在毫秒级完成百万量级向量的近似最近邻搜索,使得即便记忆库积累到数千条目,检索开销依然可以控制在可接受范围内。在 Hermes Agent 的场景中,RAG 解决了一个关键工程问题:当用户积累的记忆条目越来越多时,无法将全部记忆塞入有限的上下文窗口,只能按需检索最相关的片段,既保证个性化效果,又控制推理成本,避免上下文窗口溢出。换句话说,它不仅能力在成长,对使用者本人的理解也在持续加深。用一天和用一个月,得到的会是两个完全不同的助手。
部署前的准备:为什么需要 WSL
Hermes Agent 在 Windows 上基于 WSL(Windows Subsystem for Linux)运行,因此第一步是安装 WSL 环境。
WSL 技术背景:WSL 是微软于 2016 年推出、2019 年以 WSL 2 形式大幅升级的技术组件,允许在 Windows 上原生运行 Linux 二进制文件,无需虚拟机。值得注意的是,WSL 1 与 WSL 2 在底层架构上存在根本差异:WSL 1 采用「系统调用转译」机制,由微软实现了一个将 Linux 系统调用映射到 Windows NT 内核调用的兼容层,兼容性有限且存在性能瓶颈;WSL 2 则彻底转向「轻量级虚拟机」路线,内置一个经微软深度定制的真实 Linux 内核(基于上游 Linux 主线,随 Windows Update 自动更新),运行在 Hyper-V 隔离容器中,文件 I/O 性能相比 WSL 1 提升数倍。
这一架构转变的工程意义不容小觑:WSL 2 中 Linux 内核与 Windows 宿主机之间通过 Plan 9 文件系统协议(9P)共享文件,并经由高度优化的 Virtio 半虚拟化驱动实现网络和存储的高效通信,整体虚拟化开销远低于传统 VMware 或 VirtualBox 方案。WSL 2 还支持 GPU 直通(通过 WDDM 驱动),使 CUDA 工作负载可以直接访问宿主机 NVIDIA GPU,这对本地模型推理和训练场景尤为重要——用户可以在 WSL 2 环境中直接运行 Ollama、llama.cpp 等本地推理框架,享受接近原生 Linux 的 GPU 加速性能。大多数 AI 开发工具(如 PyTorch、CUDA 工具链、各类 Python 包)都以 Linux 为一等公民,WSL 的存在让 Windows 用户得以直接使用这些生态,避免了因路径格式、换行符、权限模型差异带来的大量兼容问题。这也是 Hermes Agent 等开源 AI 项目优先支持 Linux/WSL 而非原生 Windows 的核心原因。
Plan 9 与 Virtio 的工程选择:Plan 9 文件系统协议(9P)最初来自贝尔实验室 1980 年代研发的分布式操作系统 Plan 9 from Bell Space,其设计哲学是「一切皆文件,文件皆网络资源」。微软在 WSL 2 中选用 9P 协议作为跨系统文件共享方案,正是看中其协议简洁、适合内核态实现的特点,相比 SMB/CIFS 等更重量级的网络文件系统协议,9P 在低延迟虚拟化场景下的表现更为出色。Virtio 则是 Linux 内核社区于 2007 年提出的半虚拟化 I/O 框架标准,已成为 KVM、QEMU 乃至各大云厂商虚拟化基础设施的通用接口规范。WSL 2 采用 Virtio 意味着其网络和块设备驱动路径与主流 Linux 虚拟化生态完全对齐,为未来的性能优化和社区协作奠定了良好基础。
第一步:安装 WSL
点击开始菜单,搜索 PowerShell 并以管理员身份打开,执行官方安装命令即可自动下载并安装 WSL。需要注意的是,WSL 虽然是 Windows 官方组件,但默认并未预装,需要手动获取。
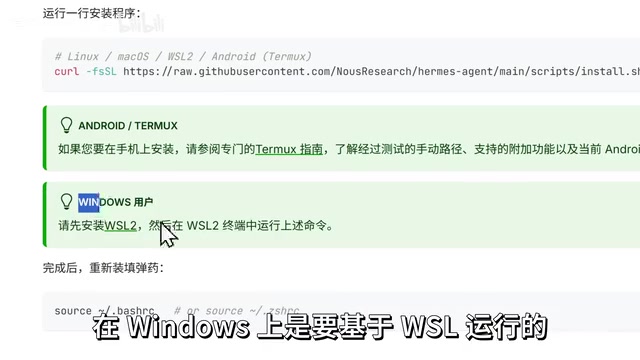
如果安装过程中遇到 403 错误提示,大概率是系统版本过旧所致,将 Windows 更新到最新版即可解决。安装完成后按提示重启系统。
第二步:安装 Ubuntu 发行版
重启后再次打开 PowerShell,执行命令自动下载并安装 Ubuntu 发行版,此过程需要耐心等待。安装完成后需设定用户名和密码。
这里有一个容易踩坑的细节:输入密码时屏幕不会显示任何字符,这是 Linux 系统的安全机制(称为「哑终端输入」或 silent password input),属于正常现象。这一设计可追溯至 Unix 系统的早期设计哲学——不仅隐藏密码字符本身,连密码长度信息也不予暴露,从而防止旁观者通过观察光标位置推断密码复杂度。建议密码不要设得过于复杂,因为后续使用中会频繁输入。当出现蓝绿色提示符时,即表示 Ubuntu 已就绪。
安装与配置 Hermes Agent
一键安装
确保网络能够访问外部资源(软件源均在境外),复制官方提供的一键安装命令,在 PowerShell 中右键粘贴并回车。安装程序会自动完成系统检测、Python 和 Node.js 等依赖组件的安装。

过程中会询问是否安装快速文本搜索等工具,输入 Y 同意,并按提示输入此前设定的系统密码。由于依赖组件较多,安装时间取决于网络状况,需要一定耐心。
配置大模型(关键避坑点)
安装完成后进入设置阶段,选择默认的快速设置流程。Hermes Agent 和 OpenClaude 一样支持多种大模型,但这里有一个重要的坑需要提醒:
关于 OpenRouter 与模型计费:OpenRouter 是一个聚合型大模型 API 路由平台,允许开发者通过统一接口调用 GPT-4、Claude、Llama、Mistral、MiMo 等数十种模型,无需分别注册各家服务商账号。其商业模式是在原始 API 价格基础上加收少量路由费用。从架构设计上看,OpenRouter 扮演的是「模型中间件」角色:它统一了不同厂商之间参数命名不一致(如 max_tokens vs max_completion_tokens)、响应格式差异、错误码体系不统一等工程碎片化问题,并提供故障转移(Fallback)和负载均衡能力,当某一模型服务不可用时自动切换至备选方案。关于小米 MiMo 模型的「免费」误区——所谓免费使用实际需要通过 Hermes 官方订阅才能实现,而小米官方渠道以及 OpenRouter 中的 MiMo 模型均不免费。即便是 Hermes 的免费订阅也需要绑定信用卡,对国内用户并不友好。
因此更稳妥的选择是使用 MiniMax 模型。MiniMax 是国内 AI 独角兽企业,旗下拥有 MoE 架构的 abab 系列模型及对话产品「海螺 AI」。MoE(Mixture of Experts,混合专家模型)是当前大语言模型扩展的主流架构范式,最早由 Google Brain 在 2017 年的「Outrageously Large Neural Networks」论文中系统性提出,并被 Mixtral 8x7B、GPT-4(据传)和 DeepSeek广告 系列模型广泛采用。其核心思想是将模型参数拆分为多个「专家」子网络,每个 token 在推理时仅激活其中 Top-K 个专家,通过门控网络动态路由——这意味着 MoE 模型总参数量可以远超密集模型,但实际计算量(FLOPs)与激活参数量挂钩,在维持推理速度的同时大幅提升模型容量。以 Mixtral 8x7B 为例,其总参数量约 46B,但每个 token 仅激活约 13B 参数,推理成本与 13B 密集模型相当,而能力却接近 70B 级别。这一特性使 MiniMax 在国内开发者中具备较强的性价比优势。
MoE 架构的工程挑战:MoE 模型虽然在参数效率上表现出色,但工程落地面临独特挑战。首先是「专家负载不均衡」问题——如果门控网络将大量 token 都路由到同一批热门专家,其他专家将处于空转状态,导致实际吞吐量下降;为此研究者引入了辅助损失函数(Auxiliary Loss)在训练时强制均衡各专家的负载分配。其次是分布式推理中的通信开销——当不同专家分布在多张 GPU 上时,token 的跨设备路由会产生大量 All-to-All 通信,成为推理延迟的主要瓶颈;DeepSeek 团队在其技术报告中详细记录了针对这一问题的定制化通信优化方案。MiniMax 的 abab 系列模型在国内服务器上完成推理,无需跨境网络访问,在响应延迟和数据合规性上对国内用户具有天然优势。
此外需特别注意:MiniMax 分国内版和国际版,其国内版 API(api.minimax.chat)与国际版(api.minimax.io)在端点地址、计费体系和访问方式上完全独立。国内用户大概率订阅的是国内版,配置时务必选择 minimax China。从 MiniMax 官方控制台复制 API 密钥,回到终端右键粘贴(同样不会显示),接入端点保持默认即可。
验证功能与网页界面部署
配置完成后输入 1 进入聊天界面。可以先测试提问验证模型是否正常,再让它记住个人信息以验证记忆能力——它会自动将信息写入 memory。

告别命令行:部署可视化网页界面
Hermes Agent 原版只能在命令行中操作,但社区已提供开源免费的网页界面方案。网页界面不仅对话体验更好,还能可视化查看和配置模型、连接聊天平台、管理记忆等,比黑底命令行窗口直观得多。
安装方式非常巧妙——你甚至可以直接让 Hermes 自己帮你安装。只需对它说「帮我安装这个软件」并粘贴项目仓库链接,它就能自动完成。这一能力的背后是智能体的「自主工具调用」机制:Hermes Agent 会将自然语言指令解析为可执行的 shell 命令序列,依次完成 git clone、依赖安装、服务启动等步骤,并在每一步骤后验证执行结果,遇到错误时进入自我诊断-重试循环。这一「执行-验证-修正」的闭环模式在学术上被称为 ReAct 或 Reflexion 框架的实践应用——智能体在行动后会生成对结果的反思(Reflection),将错误信息纳入下一轮推理的上下文,从而实现动态纠错而非盲目重试。安装后在浏览器输入对应地址即可访问。
为了省去每次手动运行的麻烦,还可以让 Hermes 编写一个一键启动脚本。脚本报错时,将错误提示复制给 Hermes,它能自行分析出是编码问题并重写脚本,最终成功运行——这也侧面印证了它的自我调试能力。
连接微信:手机端远程操控 Hermes Agent
Hermes Agent 支持连接 Telegram、WhatsApp、Slack 等国外工具,也支持飞书、微信、钉钉等国内平台。以微信为例:
微信机器人接入的技术原理与风险:微信官方并未开放个人账号的 Bot API,因此 Hermes Agent 所使用的微信接入方案大概率基于 Web 微信协议逆向工程(如 WeChatpy 或 itchat 的变体)。微信网页版在 2013 年至 2017 年间是微信的官方多端入口,开发者社区基于其公开的 HTTP 协议衍生出 itchat、wxpy 等广受欢迎的 Python 开源库,高峰期 GitHub Stars 均超万级。然而自 2017 年起,腾讯逐步收紧 Web 端登录权限——官方解释是安全策略升级,但业界普遍认为这也与压制第三方自动化工具有关。现代微信 Bot 方案因此转向基于 Android/iPad 客户端协议的逆向工程,通常通过中间人代理(MITM)或内存注入捕获客户端与服务端的通信协议,并在本地搭建协议模拟服务器实现消息收发。这类方案在技术实现上更加复杂,需要持续跟进腾讯的协议变更(微信通常每隔数周至数月更新一次协议版本),维护成本较高。这类方案处于腾讯用户协议明确禁止的灰色地带,存在一定的封号风险,腾讯会定期更新检测策略。建议以小号操作,避免将主账号用于自动化 Bot 场景以降低损失。
打开终端输入 wsl 进入 Ubuntu,再输入 hermes setup 进入设置。大模型配置可跳过,进入消息设置后将光标移到微信选项,按空格键选定并回车。

选择通过二维码登录(输入 Y),按住 Ctrl 键点击生成的链接在浏览器中打开二维码,用手机微信扫码后点击连接。二维码扫码登录的逻辑与网页版微信一致:客户端生成临时 UUID,服务端以长轮询(Long Polling)或 Server-Sent Events 方式轮询该 UUID 的认证状态,手机端扫码后首先返回「已扫码待确认」状态,用户点击确认后服务端下发 Session Cookie 或 Access Token,后续所有请求携带该凭证完成鉴权。整个流程中二维码本身仅承载 UUID 信息,敏感凭证始终在服务端流转,即便二维码被截图也不会直接泄露账号凭据。
长轮询与 Server-Sent Events 的技术选型:长轮询(Long Polling)是在 WebSocket 普及之前实现服务端推送的经典方案——客户端发起 HTTP 请求后,服务端会将连接挂起直到有新消息或超时才返回响应,客户端收到响应后立即发起下一次请求,形成伪实时推送效果。Server-Sent Events(SSE)则是 HTML5 引入的标准化单向推送协议,基于持久 HTTP 连接,服务端可持续向客户端推送文本事件流,无需客户端反复轮询。二维码登录场景选用哪种方案取决于后端架构偏好:长轮询兼容性更好,无需特殊服务器配置;SSE 则在连接管理和资源占用上更为高效,是现代 Web 推送的推荐选项。微信 Web 端历史上采用长轮询,而新一代基于 Protocol Buffers 的通信协议则已转向更高效的二进制流式传输。
连接成功后还需完成配对:在微信中随意发送一条消息,系统会返回配对码和配对命令,在终端中执行即可。配对成功后,就能直接在微信上远程操控 Hermes Agent 处理任务了。
从 OpenClaude 迁移:一条命令搞定
如果你此前已经使用过 OpenClaude,Hermes Agent 提供了专属迁移命令,可将原有的技能、记忆、API Key 等配置全部迁移过来,无需从头配置,大大降低了老用户的切换成本。这一迁移能力的技术基础在于两个项目共享了相似的配置文件结构——技能以 JSON 或 Markdown 格式存储,记忆以纯文本序列化,API 凭证以环境变量或配置文件管理,标准化的数据格式使跨项目迁移成为可能,也体现了开源 AI 智能体生态逐渐向互操作性靠拢的趋势。
开源 AI 智能体生态的互操作性:这一趋势与云原生领域的发展轨迹颇为相似。正如容器编排领域最终围绕 Kubernetes API 形成统一标准、各大云厂商相继宣布兼容,AI 智能体领域也在逐步形成围绕 MCP(Model Context Protocol,由 Anthropic 于 2024 年底提出)的互操作规范。MCP 定义了 LLM 应用与外部工具、数据源之间的标准化通信协议,目标是让不同智能体框架能够共享工具插件和上下文资源,而无需为每个框架单独开发适配层。Hermes Agent 与 OpenClaude 之间的配置格式兼容,是这一互操作趋势在具体项目层面的早期实践,预示着未来 AI 智能体生态可能走向类似 npm 或 pip 的标准化插件市场模式。
总结
Hermes Agent 的最大差异化在于自我进化与个性化沉淀,让 AI 助手从「工具」逐步变成「越来越懂你的伙伴」。它部署灵活,可运行于本地 PC、家用 NAS 的 Docker 或云端 VPS。对于普通用户而言,Windows + WSL 的部署路径虽然步骤稍多,但按本文流程操作并避开 MiMo「伪免费」等坑点,即可一次性完成从安装、网页界面到微信连接的全套配置。
核心要点
- 技术本质:Hermes Agent 通过程序合成 + 上下文蒸馏实现技能持久化,通过分层记忆架构(短期/长期/技能记忆)实现个性化沉淀,核心价值是「越用越懂你」的自我进化能力
- 部署路径:Windows 用户需借助 WSL 2(轻量级虚拟机架构,支持 GPU 直通)运行 Linux 原生工具链,这是 AI 开发生态以 Linux 为一等公民的现实映射
- 模型选择:国内用户推荐 MiniMax(选 minimax China 端点),避开需要绑定境外信用卡的 MiMo「伪免费」方案;MiniMax 采用 MoE 架构,在性价比和访问延迟上对国内用户更友好
- 微信接入:基于逆向工程的 Bot 方案处于腾讯用户协议灰色地带,建议以小号操作降低封号风险
- 迁移兼容:与 OpenClaude 配置格式兼容,体现了开源 AI 智能体生态向互操作性靠拢的趋势
相关推荐
AI+网络安全入门指南:从零基础到SRC挖洞实战
面向零基础学习者的AI+网络安全入门指南,拆解SRC漏洞挖掘课程的核心模块:高频漏洞原理、资产信息收集、CVE漏洞复现与AI工具实操,分析学习路径与职业方向。
谁更不受欢迎:民主党还是共和党?
民主党与共和党谁更不受欢迎?本文深入分析两党支持率困境、民主党在立法博弈中的两难选择,以及政府停摆策略的政治风险,揭示美国政治极化的深层逻辑。
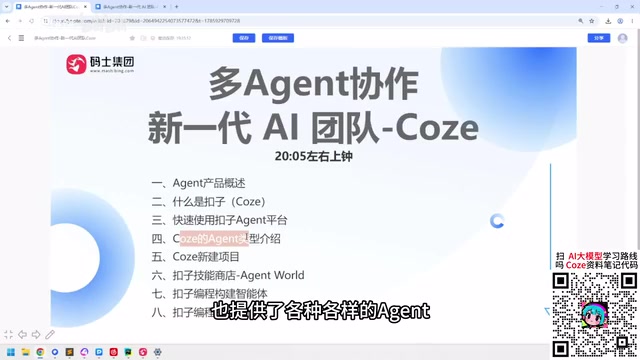
Coze 3.0从入门到多Agent协作实战指南
Coze 3.0新版教程:从AI Agent产品分类讲起,解析Coze Studio、Dify等搭建平台与Claude Code等Agent软件的区别,梳理Coze多Agent协作、技能商店与项目管理的核心玩法,适合0基础入门。