Hermes Agent的.md文件如何工作?核心机制解析
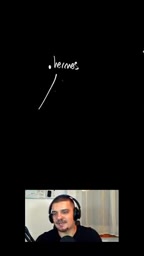
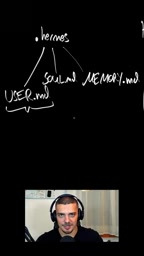
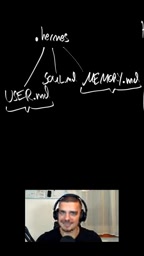
Hermes Agent 用三个 Markdown 文件分别承载用户档案、动态记忆与人格设定。
Hermes Agent 将跨会话的连贯性建立在一个 `.hermes` 目录之上,其中 `user.md`、`soul.md`、`memory.md` 三个 Markdown 文件分别承担个人档案、人格设定和动态记忆的职责。`user.md` 接近静态身份信息,`memory.md` 在对话中被动态写入值得记住的细节,`soul.md` 则用自然语言描述 Agent 的性格与表达风格,替代硬编码的行为参数。纯文本方案带来透明、可编辑、可迁移和可审计的优势,用户可随时查看和修正记忆。代价是记忆写入依赖 Agent 的判断,文件增长后如何检索并注入上下文成为新的工程难题,方案的成败很大程度取决于写入与读取的调度逻辑。
Hermes Agent 把「记忆」和「人格」都交给了几个 Markdown 文件。理解这套机制,是理解这个 Agent 如何跨会话保持连贯性的关键。
.hermes 目录:Agent 的「自我」存放处
无论你通过什么方式与 Hermes 交互,最终面对的都是同一个 Agent。这意味着 Hermes 自身会维护一个 .hermes 目录——理论上,根据你的配置方式,系统里可能还存在多个分散的目录。
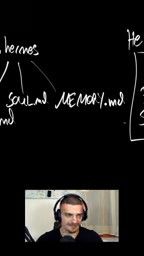
这个目录里存放着大量信息,其中最关键的是三个 Markdown 文件:user.md、soul.md 和 memory.md。.md 即 Markdown,对不熟悉的人来说,它不过是带有基础格式的纯文本,可以写标题、加粗文字等。这些文件描述的是「Hermes 知道关于你的什么」以及「它知道关于自己的什么」。
Markdown 的选择并非随意。纯文本意味着这些文件可读、可编辑、可版本控制,用户不必依赖任何专有格式就能查看 Agent 到底记住了什么。
user.md 与 memory.md:区分「档案」与「记忆」
这里有一个容易混淆的点:user.md 和 memory.md 在某些描述中内容相似——都包含你的姓名、出生日期(如相关)、所在国家等信息。原文的表述在这两个文件的职责划分上存在重叠,值得开发者留意实际实现中的差异。
更清晰的区分来自写入方式。memory.md 是动态的:当你告诉它某件值得记住的事,或者明确说出「记住这个细节」,它会将该信息写入 memory.md。也就是说,user.md 更接近静态的个人档案,而 memory.md 是随对话不断积累的记忆池。
这种设计的好处在于透明:你随时可以打开 memory.md 检查 Agent 记了什么,也可以手动修正错误记忆,而不必担心信息被锁在某个黑盒向量数据库里。
soul.md:用自然语言定义 Agent 的性格
soul.md 定义的是 Hermes Agent 的性格。你可以写「你总是简洁、高效、不说废话」,也可以写「你总是友善、话多、富有同理心」。你往 soul.md 里写什么,Agent 就会以相应方式行事。
用 Markdown 文件承载人格设定的思路,本质上是用自然语言提示词替代硬编码的行为参数。相比在代码里调整 temperature 或系统提示,soul.md 让非工程用户也能直接改写 Agent 的行为风格,且改动即时生效、易于回滚。
系统提示词(System Prompt) 是大语言模型应用中一种特殊的输入,它在用户对话开始前被注入,用于设定模型的身份、行为准则和输出风格,相当于给模型一个「角色设定」。与普通对话消息不同,系统提示词通常拥有更高的优先级,模型在生成回复时会优先遵循其中的指令。传统做法是把系统提示词硬编码在应用代码或配置文件中,修改需要开发者介入;而 soul.md 的思路是把系统提示词外化为用户可直接编辑的 Markdown 文件,每次会话启动时读取其内容并注入。这使得行为调整从「改代码」变成「改文档」,降低了迭代门槛。需要注意的是,系统提示词并非绝对约束,模型仍可能偏离指令,因此人格设定的表述越具体、越一致,效果通常越稳定。
这套设计的取舍
三个文件的分工体现了「档案—记忆—人格」的三层结构:user.md 管身份,memory.md 管经验,soul.md 管表达。全部基于纯文本,意味着高度可迁移、可审计。
代价也同样存在。纯文本记忆依赖 Agent 判断「什么值得记」,写入策略的准确性直接决定长期表现;文件数量增长后,如何检索和注入上下文会成为新的工程问题。原文并未展开这些细节,但从机制设计上可以预判,这套方案的成败很大程度上取决于记忆写入与读取的调度逻辑。
上下文注入(Context Injection) 指在模型生成回复之前,把外部信息(如记忆文件内容)拼接到提示词中,使模型「看到」这些信息并据此作答。由于大模型的上下文窗口有限,不能把所有记忆文件无差别塞入每次请求,因此需要一套调度逻辑:先根据当前对话判断哪些记忆相关,再选择性加载。常见策略包括按关键词或语义相似度检索、按时间近因排序、设置固定配额等。注入内容过多会挤占对话空间并增加成本,过少则可能遗漏关键信息。这正是纯文本记忆方案在文件规模增长后面临的核心工程挑战——记忆的「写入」只是第一步,「在正确时机读入正确片段」才是决定长期表现的关键。
相关推荐
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
联合国“杀手机器人”谈判再陷僵局:自主武器监管为何难破冰
联合国日内瓦会议就自主武器(“杀手机器人”)规则展开谈判,一周磋商收效甚微,代表仅同意“开始讨论选项”。本文分析谈判僵局背后的定义分歧、安全诉求冲突与多边机制局限。

GTA VI 正在构建玩家行为画像,隐私边界再引争议
GTA VI 被曝正在构建玩家行为画像,引发 Hacker News 社区对游戏数据收集与隐私边界的讨论。本文分析行为画像的技术维度、隐私张力及对游戏行业的潜在影响。