HF热榜深度解析:Qwen-Image-2.1生态霸榜,开源模型迎来爆发时刻
Hugging Face热榜揭示开源AI竞争从拼参数转向拼生态速度与部署效率。
本文梳理了Hugging Face当前热榜前30名的核心趋势。Qwen-Image-2.1以统一文生图能力与强劲的生态扩散速度霸占榜首,ComfyUI整合版三天斩获567万下载,展现出开源飞轮效应的惊人威力。DeepSeek-V4.1-Flash凭借CSA2技术将763B MoE模型的KV缓存压缩至每Token 890字节,让超长上下文推理成本大幅下降。LTX-2.5视频模型以6.8秒生成10秒720P视频,实现"比实时还快"的里程碑。榜单后半段,三值量化(27B→5.9G)、决策型小模型CLEF-27B、99M参数说话人分离模型及1.4B文档OCR模型相继上榜,共同指向同一个信号:开源竞争已从比拼参数规模,全面转入比拼落地效率与垂直场景解题能力的新阶段。
Hugging Face 的模型总量已突破200万,而今天热榜前30名中,Qwen(通义千问)系模型几乎占据了半壁江山。从统一文生图模型到763B参数的MoE巨兽,再到比实时还快的视频生成模型,这份实时trending榜单勾勒出开源生态当下最真实的竞争格局:拼的不再是参数规模,而是落地速度和部署效率。
Qwen-Image-2.1:一个模型带火一整条产品线
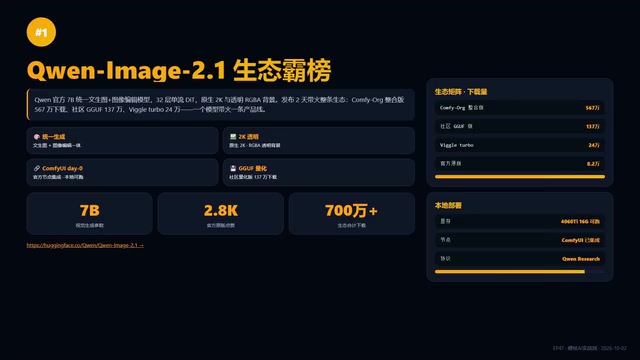
热榜第一梯队被 Qwen-Image-2.1 生态整体占据。官方原版是一个7B参数的统一模型,同时支持文生图和图像编辑,采用32层单流DiT架构,原生支持2K分辨率以及透明RGBA背景输出。
真正令人惊讶的是生态扩散的速度。据B站UP主「硬核AI实战派」的数据梳理,Comfy Org的整合版发布三天就拿下567万下载,Vigo的Turbo加速版24万下载,社区GGUF量化版也有137万下载。一个模型发布两天,就带火了从整合包、加速版到量化版的完整产品链——这正是开源生态的飞轮效应。
对普通用户来说,门槛也相当友好:4060Ti 16G显存就能本地运行,ComfyUI在Day 0就完成了节点集成。
DeepSeek-V4.1-Flash:763B巨兽的KV缓存革命
热榜第二是 DeepSeek广告-V4.1-Flash,一个总参数763B的MoE(混合专家)巨兽,但每个Token仅激活8B到16B参数。
这次发布的真正主角并非参数规模,而是KV缓存压缩技术。通过CSA2(吸收注意力)为每一层分配 Fall/Reindex/Reuse 三种模式,再配合FP4主KV缓存,全局KV被压缩到每Token仅890字节——这是上一代的四分之一,更是初代DeepSeek的四百三十七分之一。
模型基于45T Token的多模态预训练,上下文推理强度支持1到100连续可调,并采用宽松的MIT协议。换句话说,长上下文推理的成本被它打到了地板价,这对需要处理超长文档的Agent应用意义重大。
MoE(Mixture of Experts,混合专家)架构的核心思路是将模型拆分为多个"专家"子网络,每次推理时只激活其中少数几个,而非让全量参数参与计算。763B总参数但每Token仅激活8B-16B,意味着实际算力消耗接近一个中等规模的稠密模型,却能享有超大模型的知识容量。KV缓存(Key-Value Cache)则是Transformer推理时的另一个成本重心:自回归生成中,每个已生成Token的注意力键值对都需要缓存以供后续步骤复用,上下文越长、并发请求越多,显存占用就越惊人。CSA2技术通过对不同层动态分配缓存策略(复用、重建或索引重排),再叠加FP4低精度存储,将这一开销压缩到初代DeepSeek的四百三十七分之一,本质上是在推理侧做了一次架构级的成本革命,而非单纯的工程调优。
LTX-2.5:比实时更快的视频生成
热榜第三是从Lightricks分拆出的公司LTX推出的开放权重视频模型LTX-2.5,收获158万下载、5900点赞。
官方演示显示,一张图生成10秒720P视频只需6.8秒,比实时播放还快。它用全新的扩散视频解码器替换了传统VAE,支持多镜头原生生成,能保持角色、光照、声音在跨镜头之间的一致性。文本编码器也换成了Gemma 4的2B版本,支持4K HDR和RAW工作流。
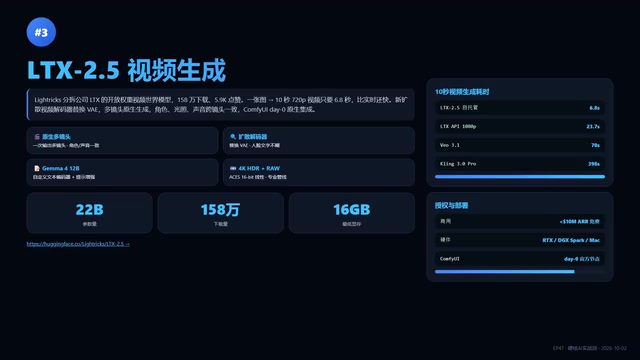
商用授权方面,年营收1000万美元以下的团队可免费商用,16G显存起步,ComfyUI同样做了Day 0原生集成,本地部署完全可行。
传统视频生成模型普遍依赖VAE(变分自编码器)作为像素空间与潜在空间之间的桥梁:先将视频压缩为低维潜空间表示,在其中完成扩散去噪,再解码回像素。这一流程在解码阶段往往成为速度瓶颈,且时序一致性依赖潜空间的隐式约束。LTX-2.5将VAE替换为扩散视频解码器,意味着解码本身也参与扩散过程,使运动一致性与细节还原成为可显式优化的目标,而非副产品。文本编码器升级至Gemma 4的2B版本,相较于早期视频模型常用的CLIP或T5,Gemma 4具备更强的语义理解与长文本跟随能力,这直接决定了模型对复杂镜头描述的执行精度。6.8秒生成10秒720P视频的速度,让视频生成首次具备实时预览的工程可行性。
三值量化与决策型小模型的集体崛起
热榜后半段,几个方向性的信号同样值得关注。
Bonsai 2:把27B压进普通笔记本
PrismML推出的Ternary Bonsai 2基于Qwen3.8的27B模型做三值量化,获387万下载。所谓三值量化,是把权重取-1、0、+1三个值,连2bit都不到。效果却相当惊人:语言模型从54G压到5.9G,缩小9.3倍,官方称保留了FP16模型98.2%的能力,14个思考基准平均84.78分。在苹果M5 Max笔记本上可跑到47 Token/秒,并通过llama.cpp全面支持CUDA、Metal、CPU。
三值量化(Ternary Quantization)是极端低比特量化的一种形式。常规INT8量化用8位表示权重,INT4用4位,而三值量化仅用两个比特位(甚至不足两位)来编码-1、0、+1三种状态。其理论依据是:神经网络的大量权重在训练收敛后绝对值接近零,将它们强制归零并不显著损失表达能力,而剩余的正负权重可以用加减法替代乘法运算,大幅降低硬件计算压力。与之相关的BitNet系列研究(微软)是这一方向的学术先驱,PrismML的Bonsai 2则代表了该技术在主流开源模型上的工程落地。54G→5.9G的9.3倍压缩比,使27B级别的推理能力首次真正进入消费级笔记本的显存预算,这对边缘部署和离线隐私场景具有里程碑意义。
CLEF-27B:不聊天的决策型模型
Cloudflare的CLEF-27B多模态决策模型定位非常特别:它不聊天、不写代码,输入状态加一组带类型的选择题,一次前向传播直接输出每个选项的概率,没有自由文本生成,也不需要输出解析。文本、JSON、图像、视频都能读,专门用于点选类自动化决策,采用Apache 2.0协议,同厂还发布了9B的CLEF Flash轻量版。
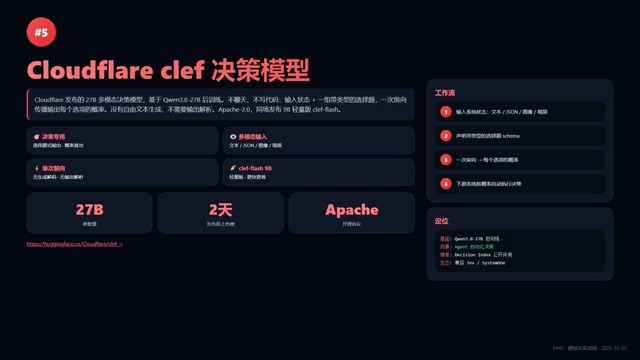
CLEF-27B代表了一种刻意收窄输出空间的模型设计哲学。传统多模态大模型追求通用性,以自由文本作为统一输出接口,但这在自动化流程中带来了一个隐性成本:需要额外的输出解析层将自然语言转化为可执行的结构化指令,且结果的确定性难以保证。CLEF的做法是从训练目标上就放弃自由文本生成,直接对离散选项输出概率分布,本质上将语言模型转化为一个高维分类器。这与强化学习中的策略网络(Policy Network)在结构上高度相似——给定状态,输出动作概率。这种设计的代价是丧失通用性,收益则是推理延迟更低、输出可直接被程序消费、部署栈更简单。Cloudflare将其定位于点选类自动化决策,实际上是在为未来的Agent工作流提供一个确定性更强的"决策原语"。
垂直小模型各显神通
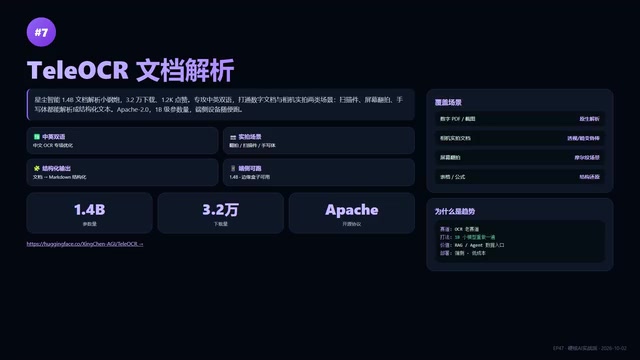
NVIDIA的Nemotron 3说话人分离模型仅99M参数,支持流式与离线推理,最多处理8个说话人,流式延迟最低80毫秒,直指会议记录、客服质检、播客转写等场景。星辰智能的Tele-OCR则是1.4B参数的文档解析小钢炮,专攻中英双语文档,打通了数字文档与相机实拍两类场景,扫描件、屏幕翻拍、手写体都能解析成结构化文本,端侧设备随便跑。
从拼参数到拼落地:三大趋势清晰浮现
综合这份热榜,开源竞争的逻辑正在发生根本转变。
生态速度决定生死。 Qwen-Image-2.1发布两天,ComfyUI整合版567万下载、社区量化版137万下载,一个模型带火整条生态链。生态响应速度已成为模型能否霸榜的关键变量。
效率就是竞争力。 DeepSeek把KV缓存压到每Token 890字节,PrismML把27B压到5.9G。成本每降一档,用户就多一层——显存门槛和推理成本的下降,直接决定了模型的可触达人群。
小模型解决具体问题。 Cloudflare做决策、NVIDIA做分离、Tele-OCR做文档,垂直小模型集体上榜说明开源竞争已从「比参数」进入「比落地」的阶段。
当200万模型同台竞技,真正能脱颖而出的,往往不是参数最大的,而是生态最快、部署最轻、问题最具体的那一个。
相关推荐
Databricks Genie重大更新:上下文、数据接入与自动化全面升级
Databricks Genie One迎来重大更新,涵盖业务感知上下文、工作区指令、多格式文件上传、Unity Catalog直连查询和定时自动化任务,推动企业级AI数据助手深度融入数据工作流。
Omnigent:让Claude Code与Codex协同工作的开源元框架
Omnigent是一款开源元框架,让Claude Code、Codex等多个编码智能体共享会话、规则与安全策略。本文解析其任务分叉、Debby多Agent评审辩论与Polly子Agent拆分等协作模式。
算力上太空:谷歌与Planet原型卫星成功发射意味着什么
谷歌与Planet合作的太空算力原型卫星由SpaceX成功发射。本文解析把计算搬到太空的动因、工程挑战以及商业航天生态的协同意义。