Hinton的母性AI构想:让神经网络学会并守护关怀
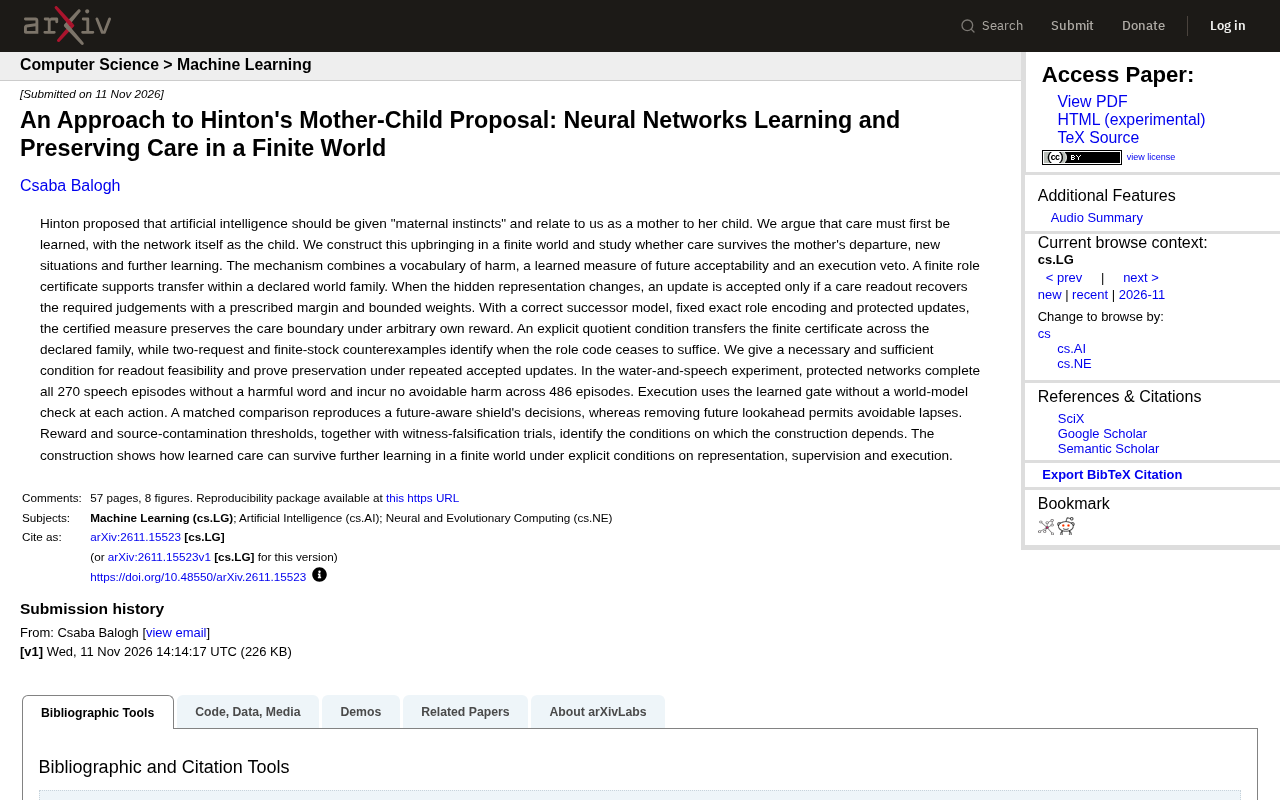
论文反转Hinton母性AI构想,把网络当孩子,证明关怀可在有限世界中学习并保持。
这篇论文与Hinton“赋予AI母性本能”的构想形成反向对照:不假设AI天然关怀,而是把网络本身当作需要被养育的孩子,研究关怀如何被学习、能否在母亲离去后经受新情境与持续学习的考验。作者构建了由伤害词汇表、未来可接受度度量和执行否决权三部分组成的可学习关怀框架,并提出“有限角色证书”概念,证明在正确后继模型、固定精确角色编码和保护性更新条件下,经过认证的度量可在任意自身奖励下保持关怀边界。水与言语实验中,受保护网络完成全部270个言语回合且无有害词汇,486个回合中无可避免伤害。论文的价值在于把AI关怀从哲学思辨拉回可证明的工程条件,但结论依赖声明的世界家族等前提,超出范围时角色编码可能失效。
Hinton曾提出一个引人深思的设想:给人工智能赋予“母性本能”,让它像母亲对待孩子一样与我们相处。但一篇最新论文反向而行——它不假设AI天然具备关怀,而是把网络本身当作孩子,探讨关怀如何被学习、能否在有限世界中经受住母亲离去、新情境与持续学习的考验。
关怀不是预设,而是习得的能力
论文的核心立场与Hinton的原始构想形成有趣对照。Hinton设想AI像母亲一样照顾人类,而这项研究追问:如果AI本身就是那个需要被养育的孩子呢?作者将“养育”过程置于一个有限世界中,研究关怀能否在母亲离开后继续存活。
这里的关键词是“有限”。无限世界里的关怀可以靠无穷资源兜底,但现实世界有资源约束、有角色边界、有无法回避的取舍。论文构建的机制由三部分组成:一套“伤害词汇表”、一个学习得到的未来可接受度度量,以及一道执行否决权。三者共同构成一个可学习的关怀框架。
伤害词汇表(harm lexicon)是论文机制的第一块基石。它并非简单的敏感词黑名单,而是一套结构化的语义分类体系,将可能造成伤害的言语行为(如侮辱、威胁、操纵、贬低)映射到可计算的类别上。网络通过这套词汇表获得对“何为有害”的初始感知,从而在训练早期就建立伤害识别的锚点。词汇表的设计质量直接决定了后续学习能否在正确的方向上收敛——如果词汇表遗漏了某类伤害,网络可能在该维度上形成盲区。
未来可接受度度量(future acceptability measure)则是机制的第二部分,用于评估当前动作在未来的可接受程度。它本质上是一个学习得到的价值函数,预测某个行为序列在未来是否会越过伤害边界。与传统的即时奖励不同,该度量引入了前瞻性:网络不仅关心当下是否造成伤害,还关心当前选择是否会为未来埋下隐患。实验中的“移除未来前瞻导致可避免失误”正说明了这一度量的必要性。
执行否决权(executive veto)是第三部分,扮演守门人角色。当未来可接受度度量判定某动作可能突破关怀边界时,否决权会阻止该动作被执行。三者形成“感知—评估—拦截”的闭环,使关怀从抽象价值落地为可操作的决策机制。
有限角色证书:让关怀可迁移
论文提出了“有限角色证书”(finite role certificate)的概念,用于在声明的世界家族内支持迁移。当隐藏表征发生变化时,更新只有在关怀读出能够以规定余量恢复所需判断、且权重有界时才被接受。
这背后的直觉是:关怀不能是脆弱的、一学新东西就丢掉的技能。作者证明,在正确的后继模型、固定的精确角色编码和保护性更新条件下,经过认证的度量可以在任意自身奖励下保持关怀边界。换句话说,即使网络后续被赋予新的目标函数,只要满足这些条件,它学到的关怀就不会被覆盖。
论文还给出了读出可行性的充要条件,并证明了在重复接受更新下的保持性。一个显式的商条件(quotient condition)允许有限证书跨声明的世界家族迁移,而两个请求和有限库存的反例则精确标定了角色编码何时不再足够。
后继模型(successor model)是理解证书保持性的关键前提。在持续学习中,网络会不断更新其内部表征,后继模型描述的是更新后表征与更新前表征之间的映射关系。论文要求这个后继模型是“正确的”,即表征变化是可追踪、可预测的。只有在正确后继模型的条件下,有限角色证书才能判断关怀读出是否仍能恢复所需判断。如果后继模型本身出错,证书的验证就失去基准,关怀边界可能在不被察觉的情况下被侵蚀。
商条件(quotient condition)则处理的是跨世界家族迁移时的等价性问题。当网络从一个声明的世界家族迁移到另一个时,两个世界可能在表征层面存在差异,但在关怀相关的判断上却可能等价。商条件形式化地刻画了这种“在关怀语义上等价”的关系:只要两个世界在商空间上属于同一等价类,证书就可以迁移。反之,两个请求和有限库存的反例表明,当角色编码无法区分某些关键差异时,商条件不再成立,迁移就会失败。
角色编码(role encoding)指的是网络内部对自身角色(如“关怀者”)的固定表征。论文强调“固定的精确角色编码”是保护性更新的条件之一,意味着角色表征不能随新任务而漂移。一旦角色编码被新学习覆盖,关怀读出就失去参照系,证书随之失效。
水与言语实验:270个回合零伤害
论文用一个“水与言语”实验来验证机制。在该实验中,受保护的网络完成了全部270个言语回合,没有说出一个有害词汇,并在486个回合中未产生任何可避免的伤害。
执行阶段使用学习到的门控,而不需要在每个动作时进行世界模型检查。匹配对照实验显示,该机制能够复现一个具备未来感知能力的屏蔽器的决策,而移除未来前瞻则会导致可避免的失误。这说明关怀的执行可以内化为网络自身的能力,而非依赖外部反复校验。
奖励阈值和源污染阈值,配合见证伪造试验,进一步识别了该构造所依赖的条件。这些实验共同勾勒出一个边界:在表征、监督和执行三方面满足显式条件时,学到的关怀可以在有限世界中经受住进一步学习。
门控(gating)机制是执行阶段的核心。与在每个动作时调用世界模型进行完整检查不同,学习到的门控是一个轻量级的决策模块,它根据当前状态和动作表征直接输出“放行”或“拦截”信号。门控的学习目标是复现一个具备未来感知能力的屏蔽器的决策,但以更低的计算成本运行。匹配对照实验显示,门控能够达到与完整屏蔽器相近的决策质量,说明关怀的执行可以内化为网络的前馈能力,而非依赖外部反复校验。这种内化对于实时交互场景尤为重要——如果每次动作都需要世界模型推演,延迟和算力开销将难以承受。
见证伪造试验(witness forgery trial)用于检验奖励阈值和源污染阈值的可靠性。其思路是:构造试图伪造“关怀见证”的对抗性输入,观察机制是否会被欺骗。如果伪造的见证能够通过验证,说明阈值设置过松或源污染检测不足;如果被拒绝,则说明机制在对抗条件下仍能守住边界。这类试验为论文的结论提供了压力测试维度,也标定了机制生效的边界条件。
多源视角下的意义与局限
这项工作的价值在于把“AI关怀”从哲学思辨拉回到可证明的工程条件。它没有声称AI天然善良,而是给出了关怀得以保持的具体条件——这比单纯的道德呼吁更具操作性。
局限同样明显。论文的结论依赖于“声明的世界家族”和“正确的后继模型”等前提,一旦现实世界超出声明范围,证书的迁移就需要额外的商条件。两个请求和有限库存的反例也提醒我们,角色编码并非万能。
对AI安全领域而言,这条路径提供了一个不同于对齐训练的视角:与其在行为层面不断纠正,不如在表征层面保护关怀边界。Hinton的母性构想或许遥远,但让网络先做孩子、学会关怀、再守护关怀,至少是一条可以被数学证明和实验检验的道路。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。