History Monk:重构浏览器历史记录的本地搜索工具

History Monk 是一款以本地优先、模糊搜索为核心的 Chrome 历史记录管理扩展。
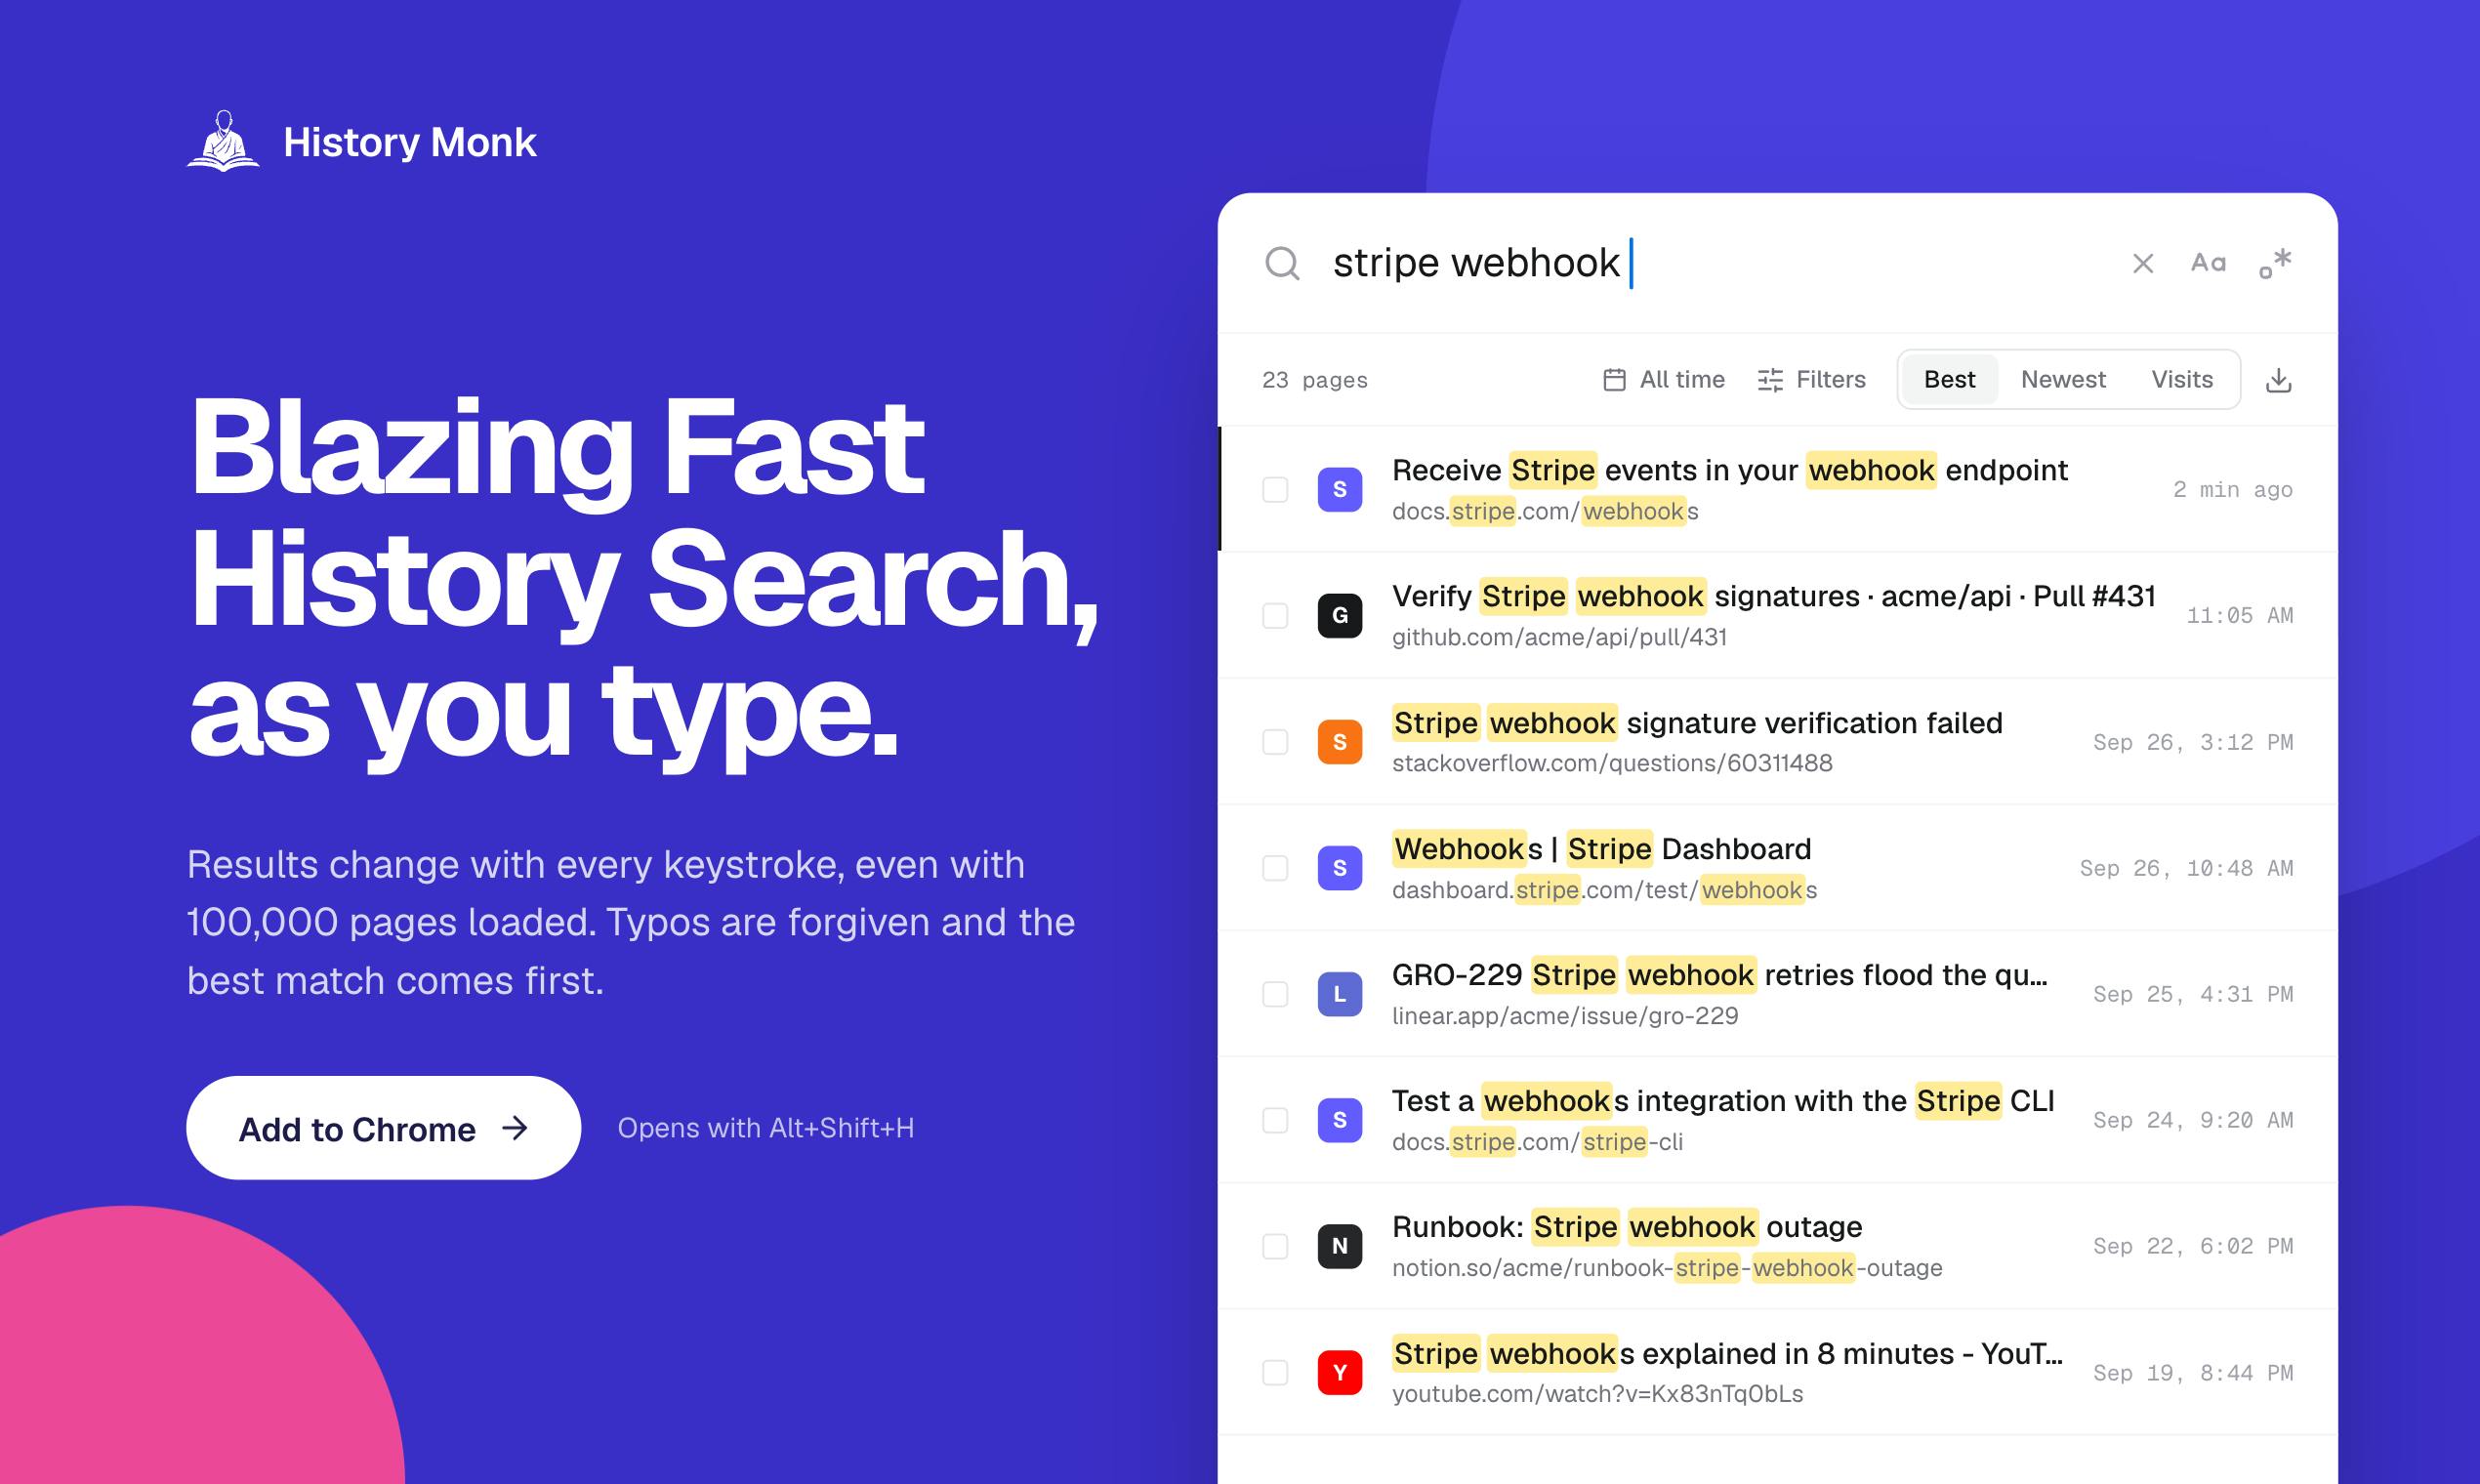
History Monk 是一款上线于 Product Hunt 的 Chrome 扩展,旨在替代功能陈旧的浏览器原生历史页面。它提供即时模糊搜索、按网站/天/小时的多维筛选、批量删除与数据导出,以及浏览时间分布可视化,帮助用户快速找回曾访问的页面并审视自身上网习惯。产品强调 100% 本地处理,所有历史数据不上传云端,在隐私保护与搜索响应速度上形成双重优势。目标用户主要为标签页重度使用者与知识工作者,但产品尚处早期阶段,跨浏览器支持与大数据量下的稳定性仍有待验证。
浏览器历史页面为何需要被取代
浏览器自带的历史记录页面多年来几乎没有大的变化:一长串按时间排列的链接,搜索框功能孱弱,想找回几天前看过的某个页面往往要滚动翻找很久。History Monk 是一款在 Product Hunt 上线的 Chrome 扩展,定位非常直接——替换掉浏览器原生的历史页面,提供一套更快、更可控的历史管理体验。
这款产品在 Product Hunt 当日排名第 14,获得 66 个投票,归类于浏览器扩展(Browser Extensions / Chrome Extensions)。虽然评论数为零,但它切中了一个长期被忽视的真实痛点:历史记录作为用户数据的一部分,始终缺乏像样的管理工具。
核心功能:搜索、筛选与批量清理
从官方介绍来看,History Monk 的能力集中在三个方向。
即时模糊搜索
产品宣称「输入几个字母,想要的页面就会出现」。相比原生历史页面需要精确匹配或缓慢加载的体验,这种即时响应式搜索是它的主要卖点。对于每天打开大量标签页的重度用户来说,快速定位某个曾经访问过的页面能节省不少时间。
模糊搜索(Fuzzy Search)是一种允许不精确匹配的搜索技术,即使输入存在拼写错误、缺少单词或只记得关键词片段,也能返回相关结果。常见实现算法包括 Levenshtein 距离计算和 Bitap 算法,主流 JavaScript 库如 Fuse.js 让这项能力在浏览器端变得易于集成。对于历史记录搜索场景来说,模糊搜索尤其关键——用户通常只能记住页面标题的一两个词,甚至只有模糊印象,精确匹配在此场景下几乎无法满足需求。Chrome 原生历史页面(chrome://history)依赖简单的字符串包含匹配,大量历史记录下响应也较迟缓,而本地化的模糊搜索引擎可以将整个历史索引加载到内存中实现毫秒级响应。
多维度筛选
工具支持按网站、按天、按小时进行筛选。这意味着用户不仅能找到某个页面,还能回顾「某个下午我都浏览了哪些内容」。这种时间颗粒度的筛选,让历史记录从单纯的链接列表变成了一种可回溯的行为轨迹。
导出与批量删除
产品名称中直接点明了 Export(导出)与 Bulk Delete(批量删除)两项功能。原生浏览器往往只能逐条删除或一键清空,缺乏中间地带。History Monk 让用户可以选择性地批量清理「杂乱内容」,同时保留需要的记录,并支持将历史数据导出备份。
时间可视化:看清你的注意力去哪了
除了检索和清理,History Monk 还加入了「查看你的时间花在哪里」的能力。这类统计视图把浏览行为转化为可读的数据,让用户直观看到自己在不同网站上投入的时间分布。
这其实把一个纯粹的工具型扩展,往「数字习惯自省」的方向推进了一步。近年来屏幕使用时间、注意力管理成为热门话题,History Monk 的这一设计思路与之呼应——历史记录不只是用来回溯,也可以成为了解自身上网习惯的一面镜子。
本地优先的隐私承诺
在隐私敏感度持续上升的当下,History Monk 强调「100% 本地且私密」。所有历史数据的处理都在用户设备本地完成,不上传云端。这对一款需要读取完整浏览历史的扩展而言是关键信任点——毕竟浏览历史往往包含大量敏感信息。
本地优先(local-first)也是当前工具类产品的一个明显趋势。用户越来越警惕数据被收集和分析,而将计算放在本地既能保护隐私,又能避免网络延迟,对于强调「即时搜索」的产品来说是一举两得的选择。
Local-First(本地优先)是近年软件设计领域兴起的一种架构理念,由 Ink & Switch 研究团队于 2019 年在同名论文中系统阐述。其核心主张是:用户数据首先存储在本地设备,应用在离线状态下仍可完整运行,云端同步(若有)仅作为辅助而非必要依赖。对于 Chrome 扩展而言,浏览器本身的 chrome.history API 已提供对本地历史数据的直接访问权限,天然适合本地优先架构——开发者无需搭建后端服务即可实现全部核心功能。这也意味着扩展的隐私承诺在技术层面具有可验证性:用户可通过浏览器的网络请求监控工具(如 DevTools Network 面板)确认是否存在数据外传,这比单纯依赖隐私政策声明更具说服力。
适合谁用,又有哪些局限
History Monk 的目标用户相当清晰:标签页重度使用者、需要频繁回溯资料的研究者和知识工作者,以及对浏览数据有管理和备份需求的人群。它解决的是一个高频但低调的痛点,这类工具通常不惊艳,却能在日常使用中持续产生价值。
当然,从目前公开的信息看也存在一些待观察之处。它目前主要面向 Chrome 生态,跨浏览器支持情况未明;产品尚处早期阶段(零评论),实际的搜索性能、数据量较大时的稳定性仍需真实使用验证;此外「时间统计」功能的深度和准确性,也要看后续迭代。
对于被原生历史页面困扰已久的用户来说,History Monk 提供了一个值得一试的轻量替代方案。它不改变浏览本身,而是让「找回曾经看过的东西」这件小事变得顺手——这正是优秀工具型产品的价值所在。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。