HLR-LLM:让音视频大模型听懂声音的空间方位

研究提出分层基准与双耳分支模型,为音视频大模型补上空间感知能力。
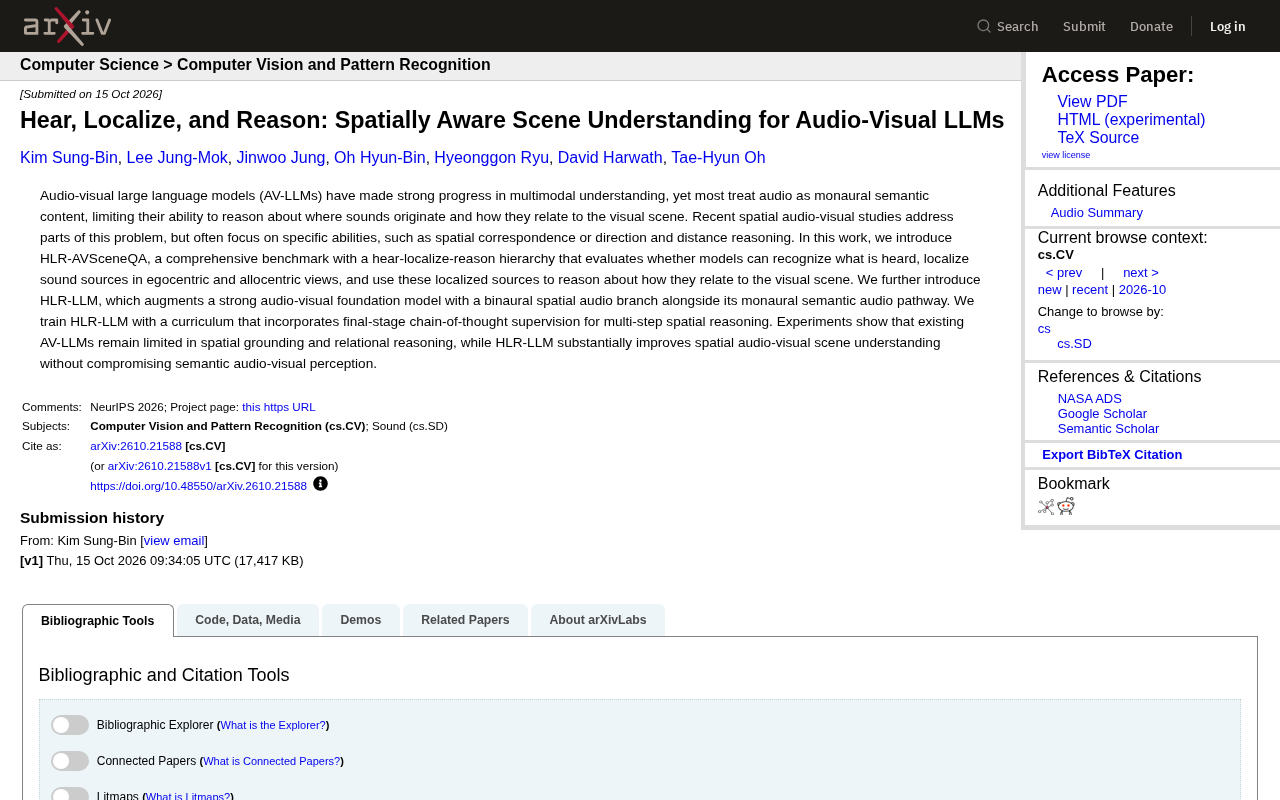
当前音视频大语言模型普遍把音频当作单声道语义信息处理,能识别声音内容却无法判断声源方向及其与画面物体的关联。为此,研究提出分层评测基准HLR-AVSceneQA,按"听—定位—推理"三层递进结构评估模型能力,可诊断瓶颈究竟出现在声音识别、空间定位还是关系推理环节;同时提出HLR-LLM,在原有语义音频通路之外增加双耳空间音频分支,并配合课程学习与思维链监督训练多步空间推理。实验表明,现有模型在空间定位与关系推理上存在明显短板,而HLR-LLM显著提升空间场景理解能力,且未损害原有语义感知能力。
当AI能"听见",却未必知道声音来自哪里
音视频大语言模型(AV-LLM)在近期取得了显著进展,能够同时理解视觉画面与音频内容。然而,这类模型大多把音频当作单声道(monaural)的语义信息来处理——它们能识别"这是什么声音",却无法回答"声音从哪个方向传来"以及"它与画面中的哪个物体相关"。
这一局限并非细枝末节。在真实场景中,空间信息是理解环境的关键维度:一辆从左侧驶来的汽车、身后传来的呼喊声、画面右下角正在发声的乐器——这些都需要模型具备空间感知能力才能准确推理。
近期一项研究工作针对这一问题提出了系统性方案,同时构建了评测基准与改进模型。
单声道(monaural)音频指用单个麦克风或单条声道录制、回放的声音信号。传统语音识别、音频事件分类等任务几乎都基于单声道音频,因为它足以承载语音内容、音色、节奏等语义信息。但单声道把来自不同方向的声音全部叠加在同一条波形里,物理上丢失了到达时间差(ITD)、强度差(ILD)和频谱线索(HRTF)等空间定位依据,因此仅凭单声道信号无法反推声源方位。这正是当前音视频大模型"听得见、找不到"的根源:训练语料与模型输入端都默认了单声道假设,空间维度被结构性抹去,而语义理解能力的提升并不会自动恢复这一维度。
HLR-AVSceneQA:一个分层的空间音视频评测基准
研究团队首先指出现有评测的不足:此前的空间音视频研究往往只聚焦于某一项具体能力,比如空间对应关系、方向判断或距离推理,缺乏对模型空间理解能力的全面考察。
为此,他们提出了 HLR-AVSceneQA,一个按照"听—定位—推理"(Hear-Localize-Reason)层级结构设计的综合基准。这个三层结构分别对应三类递进的能力:
- 听(Hear):模型能否正确识别所听到的声音内容;
- 定位(Localize):模型能否在以自我为中心(egocentric)和以他人/环境为中心(allocentric)两种视角下定位声源位置;
- 推理(Reason):模型能否利用定位到的声源,推理其与视觉场景中其他元素的关系。
这种分层设计的价值在于,它不仅能给出一个总体评分,还能诊断模型究竟在哪一层出现瓶颈——是听不出声音,还是能听出但找不到位置,抑或能找到位置却不会做关系推理。
HLR-LLM:双路径音频架构
针对现有模型的不足,研究团队提出了 HLR-LLM。其核心思路是在保留原有单声道语义音频通路的基础上,额外增加一条双耳空间音频分支(binaural spatial audio branch)。
这一设计的关键在于"不牺牲":语义音频通路负责回答"是什么声音",空间音频分支负责回答"声音在哪里",两条路径协同工作,使模型同时具备语义理解和空间感知能力。
训练方面,团队采用了课程学习(curriculum)策略,并在最终阶段引入了思维链(chain-of-thought)监督,专门针对多步空间推理任务进行训练。这意味着模型不仅要输出答案,还要学会"先定位、再推理"的分步思考过程。
**双耳空间音频(binaural spatial audio)**指用左右两个麦克风模拟人耳间距录制的声音,两条声道之间保留了到达时间差(ITD)、强度差(ILD)和头部相关传输函数(HRTF)等线索。人类正是依靠这些微小差异判断声源方位,因此双耳信号是空间定位的关键输入。将双耳分支接入大模型,意味着模型可以从声道间的差异中回归出声源的角度信息,而不只是从波形中提取"这是什么声音"。这一分支必然引入额外的编码与对齐成本,因此工程上的难点在于如何让空间特征与视觉、语义特征在统一表示空间中对齐,而非简单拼接。
**以自我为中心(egocentric)与以他人/环境为中心(allocentric)**是空间认知中的两种参照系。前者以观察者自身的视角描述位置,例如"声音在我的左前方";后者以场景或外部参照物为基准,例如"发声者位于画面中钢琴的右侧"。两者在感知上并不等价,尤其在视角动态变化时容易混淆。模型需要同时掌握两套参照系,才能完成从"我的左边"到"画面中哪个物体在发声"的跨视角推理。基准将这两类视角分开考察,能够判断模型是真正建立了场景级的空间表征,还是只学会了与相机姿态绑定的一种方位捷径。
实验结果:现有模型的空间短板与HLR-LLM的改进
实验结果揭示了两个重要发现:
现有AV-LLM在空间定位和关系推理方面仍然存在明显局限。 即便是强大的音视频基础模型,在面对"声音从哪里来"和"这个声音与画面中什么物体有关"这类问题时,表现并不理想。这说明语义理解能力的提升并不会自动带来空间理解能力。
HLR-LLM在空间音视频场景理解上取得了显著提升,同时没有损害语义音视频感知能力。 这一结果验证了双路径架构的有效性——增加空间分支并不会让模型"分心"而丢掉原有的语义理解能力。
这项工作的意义
从更宏观的视角看,这项工作触及了多模态AI的一个核心问题:感知的维度是多元的,语义只是其中之一。 人类在理解环境时,天然地同时处理"是什么"和"在哪里",而当前的AI系统在这两个维度上发展并不均衡。
HLR-AVSceneQA基准的提出也为后续研究提供了可量化的评估工具。有了分层诊断能力,研究者可以更精准地定位模型的具体短板,而不是笼统地判断"空间理解能力不行"。
当然,从基准测试到真实应用之间仍有距离。空间音频在消费级设备上的采集质量、不同声学环境下的泛化能力、以及实时推理的计算开销,都是这类技术走向实用需要面对的问题。但至少,这项工作为音视频大模型补上"空间感"提供了一条清晰的技术路径。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。