HN社区投票:当年对AI的技术挑战兑现了多少?
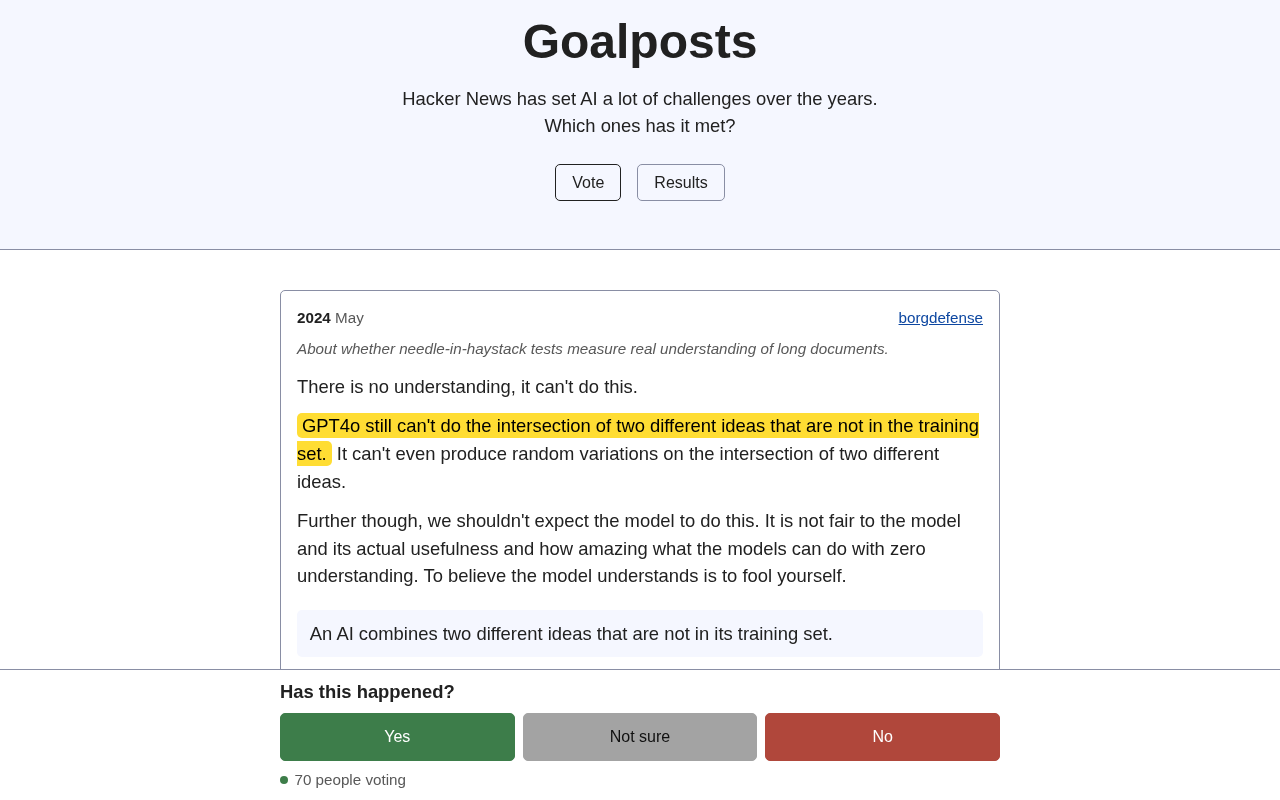
HN社区投票检验历史上「AI做不到」的断言,揭示技术预判的系统性低估与认知校准的必要性。
Hacker News上出现了一个颇具反思意味的社区项目:发起者整理了过往关于「AI做不到」的各类断言,邀请用户投票判断哪些已被当下AI技术攻克。这一轻量实验触及了一个深层命题——技术社区对AI能力边界的集体预判,是否系统性地过于保守?文章指出,此类回溯校准对技术决策、投资判断和产品规划均有实际价值。与此同时,作者也清醒地标注了投票机制的局限:缺乏统一衡量标准(基准测试表现与真实场景可靠性之间差距悬殊),加之HN用户群体整体偏技术乐观,投票结果更多反映社区「感知」而非客观事实。文章最终落脚于一个务实建议:与其执着于静态判断某项AI能力「能或不能」,不如持续动态跟踪并定期校准自身认知模型。
一个值得玩味的社区实验
Hacker News 上出现了一个有趣的 Show HN 项目:发起者整理了社区过往提出的各类「AI 做不到」的挑战清单,并邀请用户投票评判——哪些挑战已经被当下的 AI 技术真正攻克,哪些仍然悬而未决。
这个项目本身的技术含量并不高,但它触及了一个耐人寻味的命题:技术社区对 AI 能力边界的预判,究竟准不准?在快速迭代的生成式 AI 浪潮中,许多曾被视为「AI 永远做不到」的任务,正在以超出预期的速度被逐一突破。
为什么这类「打脸清单」有意义
技术社区历来不乏对 AI 能力的断言。有人断言 AI 无法写出可用的代码,有人认为它永远无法理解上下文,还有人坚持创造性工作是人类的专属领域。这些观点在提出时往往基于当时的技术现状,具有合理性,但技术的演进常常让预言落空。
将这些历史断言集中起来投票,实质上是在做一次「集体认知的回溯校准」。它能帮助从业者反思:我们对技术局限的判断,有多少是基于扎实的原理分析,又有多少只是被当下技术水平所框定的直觉?
这种回溯有现实价值。在制定技术路线、评估投资方向、规划产品能力时,对「什么能做、什么不能做」的判断直接影响决策质量。如果社区一再低估 AI 的进步速度,那么相关的战略判断也可能系统性偏保守。
投票机制背后的局限
不过,这类投票也存在明显的方法论问题。所谓「挑战已被满足」往往没有统一的衡量标准——是指 AI 在某个基准测试上超过人类,还是在真实场景中稳定可靠地完成任务?这两者之间差距巨大。
以代码生成为例,AI 能在演示场景写出漂亮的函数,不等于它能在复杂的生产环境中独立交付可维护的系统。投票者若基于不同的理解标准来判断「是否完成」,结果的参考价值就会打折扣。
此外,社区投票天然带有群体偏差。Hacker News 的用户群体整体对技术持乐观态度,可能倾向于高估 AI 的实际成熟度。缺乏严格的验证流程,投票结果更多反映的是社区的「感知」而非客观事实。
衡量AI能力的标准在学术界和工业界本就存在长期争议。学术界常用基准测试(Benchmark)来量化模型表现,例如MMLU测试通识推理、HumanEval测试代码生成能力;但基准测试存在「数据污染」风险——模型可能在训练时已见过测试题,导致分数虚高。工业界则更关注「真实世界可靠性」,即模型在生产环境中面对噪声输入、边缘案例和长尾需求时的稳定表现。两套标准之间的鸿沟,正是「AI已经能做X」这类断言屡屡引发争议的根源。Hacker News 的投票者背景各异,对同一项能力的判断标准可能相差悬殊,这使得聚合后的投票结果难以承载精确的技术含义。
从趣味项目看 AI 认知的变迁
抛开方法论的严谨性,这个项目最大的价值在于提供了一个观察 AI 认知变迁的窗口。过去几年,生成式 AI 在语言、图像、代码等多个领域的突破,确实改写了许多人对技术边界的认知。
曾经被认为「十年内不可能」的任务,如今已成为日常工具的基础功能。这种加速度本身就提醒我们:面对 AI,任何「永远做不到」的断言都应当保持谦逊。技术边界不是固定的,而是在持续被重新定义。
对于关注 AI 发展的从业者而言,与其执着于判断某项能力「能或不能」,不如动态跟踪技术进展,定期校准自己的认知模型。这个小小的投票项目,恰好提供了一种轻量化的校准方式。
生成式AI(Generative AI)的核心突破集中在2022年至今:以GPT-4、Claude、Gemini为代表的大语言模型(LLM)在语言理解与生成上达到了此前难以想象的流畅度;Stable Diffusion、Midjourney等图像生成模型则将「AI作画」从研究原型变成大众工具;Copilot类产品将AI代码辅助推入主流开发工作流。这一轮加速的底层驱动力是「scaling law」(规模定律)——模型参数量、训练数据量与算力的同步扩张带来了涌现能力(emergent capabilities),即在规模跨越某个阈值后,模型突然具备此前从未展现的新能力。这种非线性的能力跃升,正是为何许多「十年内不可能」的预言在两三年内即告落空,也是为何静态的「能力清单」会持续失效。
结语
这是一个简单却有启发性的社区实验。它用投票的方式,把技术社区对 AI 的集体预判摆上台面接受检验。尽管投票结果的客观性有限,但它引发的反思——关于我们如何评估技术边界、如何避免被当下局限所束缚——远比投票数字本身更有价值。
(注:该项目目前在 Hacker News 上热度有限,相关讨论仍在早期阶段。)
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。