后Transformer架构全景:2026年主流模型对比

Reddit对比表梳理了Mamba、RWKV、Titans等后Transformer架构的核心机制与落地取舍。
文章基于Reddit社区发布的架构对比表,系统梳理了后Transformer时代的主要技术路线。Transformer的瓶颈在于注意力的平方复杂度和KV Cache开销,因此SSM/RNN复兴(Mamba、RWKV、xLSTM)、线性与softmax混合架构(Qwen3-Next、Kimi Linear、Jamba)、以及测试时记忆机制(Titans、BDH、HRM)同时涌现。这些架构并非互斥,多数SSM底层可归约为线性注意力,混合比例是当前最活跃的实验变量。工程上还出现了硬件在环搜索驱动的设计(LFM2)和大量“继承组件”的务实派。作者提醒,现有对比多停留在机制层面,缺乏严格控制变量的实验,能否在同算力下真正超越调优后的Transformer仍是未解问题。
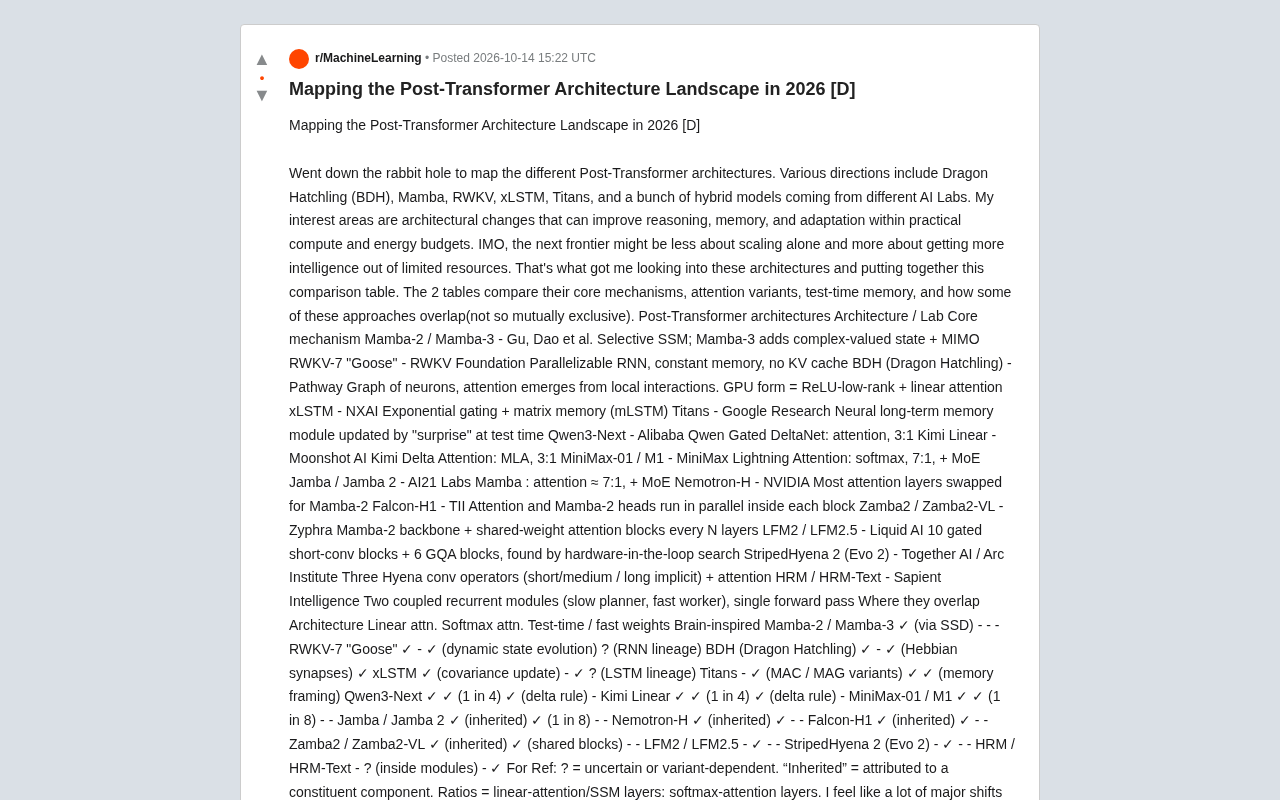
2026年,Transformer架构的统治地位正在被一批新兴设计所撼动。从Mamba、RWKV到Titans、BDH,不同实验室给出了截然不同的替代方案。Reddit社区最近发布的一张对比表将这些架构的核心机制、注意力变体与测试时记忆能力进行了系统梳理,勾勒出一幅后Transformer时代的技术全景。
为什么要超越Transformer?
Transformer的核心瓶颈并不在表达能力,而在资源效率。标准注意力机制的计算复杂度随序列长度平方增长,KV Cache的内存开销在长上下文场景下急剧膨胀。当推理、记忆和持续学习成为AI系统的关键能力时,这些约束变得尤为突出。
Reddit作者的兴趣点很明确:在"实用的算力和能耗预算内"提升推理、记忆与适应能力。他的判断是,下一个前沿可能不再单纯依赖规模扩展,而是从有限资源中榨取更多智能。这一视角与当前业界对Scaling Law边际效益递减的讨论高度契合,也解释了为什么状态空间模型(SSM)、线性注意力、混合架构等方向会同时涌现如此多的尝试。
核心技术路线的分化
状态空间模型与RNN复兴
Mamba系列(来自Gu、Dao等人)走的是选择性状态空间模型路线。Mamba-2引入SSD框架让训练可以并行化,Mamba-3进一步加入复数值状态和MIMO结构。RWKV-7 "Goose"则代表了并行化RNN方向——它保持恒定内存占用,完全不需要KV Cache,在推理效率上有先天优势。xLSTM来自NXAI,用指数门控和矩阵记忆(mLSTM)重新激活了LSTM的血统。
这几条路线的共同点是:用递归或状态空间替代全注意力,在推理时保持恒定的内存开销。代价是在某些需要精确长距离检索的任务上,可能不如全注意力稳定。
状态空间模型(SSM) 来源于控制论,用一个隐状态向量 (h_t) 描述系统随时间的演化:(h_t = A h_{t-1} + B x_t),输出 (y_t = C h_t)。其核心优势是线性时间与恒定内存——每一步只依赖前一步的状态,无需保存全部历史。早期 SSM(如 S4)使用结构化矩阵(如 HiPPO 初始化)让长程依赖可被稳定建模,但系数 (A, B, C) 与输入无关,导致模型无法根据内容“选择”记忆什么。Mamba 的关键创新是让 (B, C) 和步长 (\Delta) 成为输入的函数(即“选择性”),从而在保留线性复杂度的同时获得内容感知的门控能力。
Mamba-2 提出的 SSD(State Space Duality) 框架则揭示了一个更深的联系:带特定结构的 SSM 在数学上等价于一种掩码化的线性注意力,这使训练可以像注意力一样用矩阵乘法并行化,而不必按 RNN 方式串行展开。理解这一点是理解后文“多数 SSM 底层使用线性注意力”的前提。RWKV 则走另一条路:它在时间维度上用可并行化的 WKV 算子训练,在推理时退化为逐 token 的递归形式,因此天然不需要 KV Cache,内存占用与序列长度无关。
混合架构的工程折中
更多实验室选择了一条务实路线——保留部分softmax注意力层,其余替换为线性注意力或SSM层。Qwen3-Next和Kimi Linear都采用3:1的线性对注意力比例,MiniMax-01和Jamba则把这个比例推到7:1或8:1。NVIDIA的Nemotron-H几乎把所有注意力层都换成了Mamba-2。
这种混合策略的逻辑很直接:softmax注意力在少数关键层承担精确检索的职责,其余层用更高效的机制处理大部分计算。MiniMax-01和Jamba还额外叠加了MoE结构,在参数效率上再做一层优化。Falcon-H1的设计稍有不同,让注意力头和Mamba-2头在同一block内并行运行,而非分层替换。
记忆与测试时适应
Titans(Google Research)引入了一个神经长期记忆模块,在测试时根据"惊讶度"更新记忆。BDH(Dragon Hatchling,来自Pathway)的思路更为激进——用神经元图结构让注意力从局部交互中涌现,其GPU实现形式等价于ReLU低秩加线性注意力。HRM(Sapient Intelligence)则用两个耦合的递归模块分别充当慢速规划器和快速执行器,在单次前向传播中完成推理。
这三者的共同方向是让模型在推理阶段具备某种形式的"学习"能力,而不只是静态地调用训练时固化的权重。BDH明确借鉴了Hebbian突触的神经科学概念,Titans使用了记忆框架的隐喻,HRM则更接近认知架构中双系统理论的工程实现。
测试时记忆(Test-Time Memory / Test-Time Training) 与常规推理的区别在于:模型在生成过程中会修改自身的部分参数或记忆状态,而不仅是更新上下文缓存。传统 Transformer 在推理时权重冻结,所有“适应”都发生在上下文窗口内;而 Titans 这类方法维护一个可写可读的神经记忆矩阵,根据输入的新颖程度(“惊讶度”,通常用梯度大小或预测误差度量)决定写入强度。这相当于在推理阶段做一次小规模的在线学习。
Hebbian 学习 是神经科学中的经典规则,常概括为“一起激发的神经元连在一起”(fire together, wire together),即突触权重随前后神经元的同步激活而增强。BDH 借用这一概念,用神经元图结构中的局部交互来让类似注意力的行为涌现,而不显式定义 Q/K/V。双系统理论(Kahneman 提出)则把认知分为快速直觉的系统 1 与慢速推理的系统 2;HRM 的两个耦合递归模块正是这组概念的工程映射,一个负责慢速规划,一个负责快速执行。理解这些隐喻有助于判断各架构“测试时学习”的激进程度:Titans 修改记忆状态,BDH 依赖结构涌现,HRM 靠模块分工。
架构重叠与互补关系
对比表的第二个维度揭示了这些架构并非互斥。多数SSM和线性注意力模型在底层都使用了线性注意力机制——Mamba-2通过SSD结构实现,xLSTM通过协方差更新实现。Titans反而保留了softmax注意力,但在其上叠加了测试时记忆模块。
BDH是唯一同时触及线性注意力、测试时权重和神经科学灵感三个维度的架构。Qwen3-Next和Kimi Linear同时包含线性与softmax注意力,并都使用delta规则进行测试时更新。LFM2(Liquid AI)则走了一条独特的硬件搜索路线——10个门控短卷积块加6个GQA块的结构是通过硬件在环搜索发现的,而非人工设计。
StripedHyena 2(Together AI / Arc Institute)用三种不同尺度的Hyena卷积算子(短、中、长隐式)配合注意力,其Evo 2版本专注于基因组学应用。Zamba2(Zyphra)的设计是Mamba-2骨干加每隔N层插入的共享权重注意力块,在参数效率上做了针对性优化。
工程落地的现实约束
说个细节,对比表中多条路线标注了"inherited"——即其线性注意力能力来自组成组件而非原生设计。Nemotron-H、Falcon-H1、Zamba2都属此类。这意味着它们的实际性能高度依赖所继承组件的成熟度。
另一个关键变量是硬件在环搜索的引入。LFM2的结构不是由研究者手工设计的,而是通过硬件感知的搜索过程找到的。这暗示未来架构创新可能越来越多地由自动化工具驱动,而非纯粹的直觉驱动。
实际的部署选择往往取决于具体场景:需要极低推理延迟和恒定内存的场景适合RWKV-7或纯SSM架构;需要精确长距离检索的场景仍需保留softmax注意力层;需要持续适应新信息的场景则可能需要Titans或BDH这类带测试时记忆的方案。
硬件在环搜索(Hardware-in-the-Loop Search) 指把目标硬件的真实性能指标(延迟、吞吐、能耗、内存带宽)接入到架构或超参的搜索循环中,让搜索算法直接针对实际部署环境优化,而不是只优化参数量或困惑度等代理指标。LFM2 用这种方法同时决定层的类型、数量和排列方式,所以它的结构往往不符合人类设计直觉。
这带来两个后果:其一,搜索结果高度依赖目标硬件,换芯片可能需要重新搜索,可移植性下降;其二,架构可解释性变差,研究者难以说明“为什么是 10 个门控短卷积加 6 个 GQA 块”。与之相对,“inherited”(继承) 标注提示了另一种现实:很多混合架构的线性注意力能力并非原创,而是直接采用了已有组件(如 Mamba-2 的 SSD 或 GLA 等),因此它们的性能上限受制于这些组件的成熟度,创新更多体现在组合比例与层间编排上。这也解释了为什么混合比例(3:1 到 8:1)会成为当前实验最密集的变量之一。
下一步观察什么
Reddit作者邀请社区补充遗漏的架构并指出分歧,这本身就说明这个领域远未收敛。几个值得跟踪的信号:Mamba-3的复数值状态能否在语言建模上带来实质提升;混合比例是否存在某个最优区间;测试时记忆机制在多大程度上可以替代传统的上下文窗口扩展。
更根本的问题是,这些架构能否在同等算力下真正超越精心调优的Transformer。目前多数对比仍停留在机制层面,缺乏严格的控制变量实验。当这些架构进入更大规模的生产验证时,答案才会逐渐清晰。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。