后训练不改变模型表征,而是改变其读取方式

后训练改变的是模型读取内部表征的方式,而非表征内容本身。
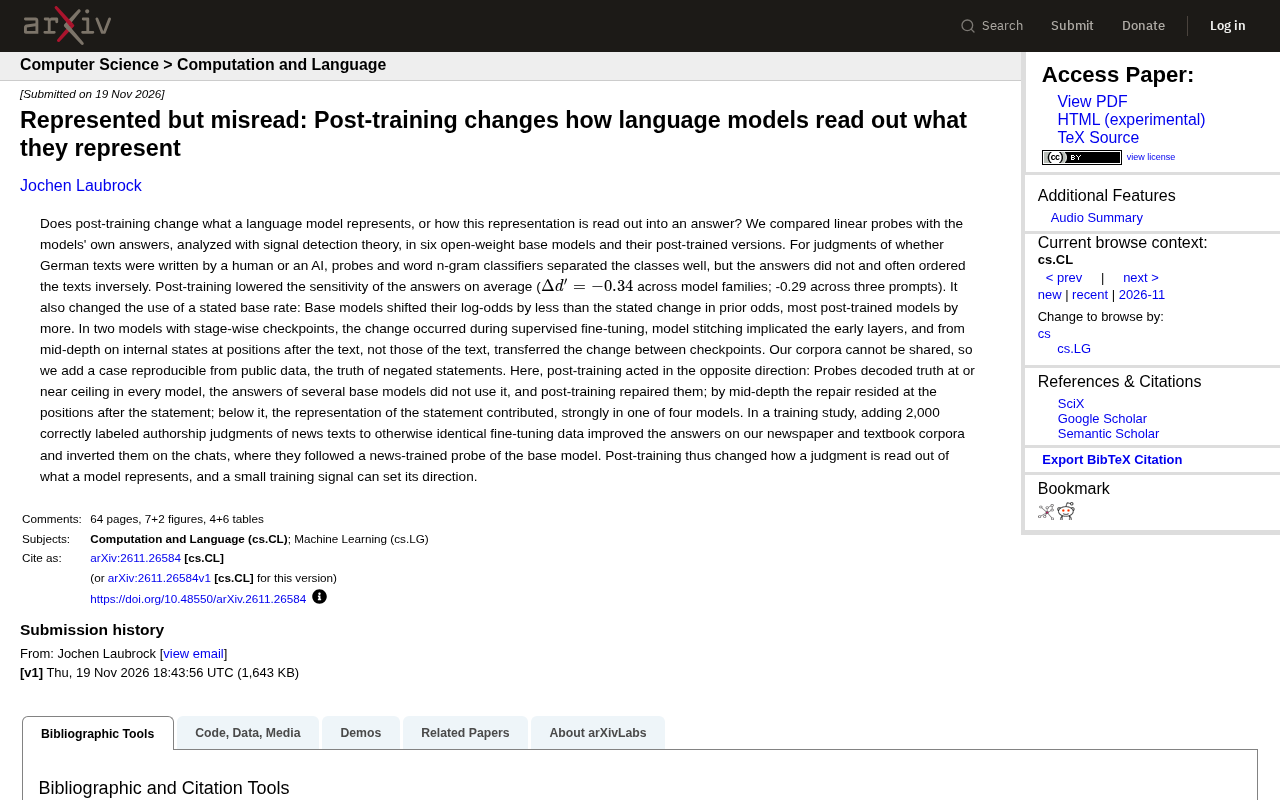
一项新研究通过线性探针与信号检测理论,比较了六个开源基础模型及其后训练版本。在判断德语文本作者(人类或AI)的任务中,线性探针和n-gram分类器能很好区分两类文本,但模型答案表现差甚至顺序反转,说明内部表征含有信息但被误读。后训练平均降低答案敏感度(Δd'=-0.34),并改变基率使用:基础模型偏移不足,多数后训练模型偏移过度。变化发生在监督微调阶段,模型拼接指向早期层,中间深度后文本之后位置的内部状态传递了变化。否定陈述真实性任务中后训练方向相反,修复了读取缺陷。少量正确标注数据即可设定读取方向,在部分语料改善答案、在聊天语料反转。研究提示仅凭输出评估内部知识可能误导,微调数据分布会系统性改变读取方向。
语言模型经过后训练(如监督微调、RLHF)后,行为会发生显著变化。但一个核心问题长期悬而未决:后训练究竟改变了模型内部表征的内容,还是仅仅改变了模型将已有表征“读取”为答案的方式?一项新研究通过线性探针与信号检测理论,对六个开源基础模型及其后训练版本进行了系统比较,给出了明确的答案:模型知道的东西往往比它说出来的多,而后训练改变的是“读出口”的方向。
实验设计:探针与答案的分离
研究团队选择了一个二元判断任务:判断一段德语文本是由人类还是AI撰写。他们对比了两类信号:一是线性探针——从模型内部状态中直接解码类别标签;二是模型自己生成的答案。同时,他们还训练了词级n-gram分类器作为基准。
结果呈现出明显的分离。探针和n-gram分类器都能很好地区分人类与AI文本,但模型的答案却表现不佳,甚至经常以相反的顺序排列文本。这意味着模型内部表征中编码了可用于判断的信息,但模型在生成答案时没有正确利用它。这正是“表征存在但被误读”的典型场景。
信号检测理论的分析进一步量化了这种差距。后训练平均降低了答案的敏感度(d'),跨模型家族的平均变化为-0.34,跨三个提示的平均变化为-0.29。换言之,后训练让模型在答案层面变得更不善于区分这两个类别,尽管内部表征仍然包含区分信息。
线性探针(linear probe)是机制可解释性研究中的常用工具,指在模型某一层的内部状态上训练一个简单的线性分类器(如逻辑回归),用以检测该状态中是否线性编码了某个特定概念或标签。探针的准确率高,说明信息在表征中线性可分;但它只反映“信息是否存在”,并不代表模型在生成答案时会使用该信息。
信号检测理论(Signal Detection Theory, SDT)用两个指标刻画判断行为:敏感度 d'(d-prime)衡量区分两类信号的能力,计算为信号与噪声分布均值之差除以共同标准差;判断标准(criterion)则反映决策偏向。d' 下降意味着区分能力减弱,而标准偏移则对应先验或基率整合的变化。本文用 d' 的变化量化后训练对答案敏感度的影响。
基率使用:后训练放大了先验偏移
实验还考察了模型对明确给出的基率(base rate)的使用。在判断任务中,如果提示中告知了人类文本与AI文本的先验比例,理想情况下模型的对数几率应随先验几率的改变而同比例移动。
基础模型的表现是偏移不足:它们的对数几率变化小于所声明的先验几率变化。而大多数后训练模型则偏移过度,变化大于先验变化。这说明后训练不仅影响敏感度,也改变了模型对先验信息的整合方式。
变化发生在哪:监督微调与中间层
通过两个具有分阶段检查点的模型,研究定位了变化发生的训练阶段:监督微调。模型拼接(model stitching)实验进一步将责任指向早期层。从中间深度开始,在文本之后的位置(而非文本本身的位置)的内部状态,能够在检查点之间传递这种变化。
这一发现与机制可解释性中的“读取位置”概念相呼应:模型对文本的判断并非直接从文本 token 的表征中读出,而是从文本之后某些位置(如序列末尾或特定分隔符后)的聚合状态中读出。后训练改变的正是这一读取路径。
模型拼接(model stitching)是一种用于定位表征与计算差异的实验技术:将模型 A 的早期层输出接入模型 B 的后续层(中间插入一个可训练的线性或轻量拼接层),考察拼接后的模型能否恢复原有性能。若拼接成功,说明两模型在拼接点处的表征足够兼容;若失败,则表明差异发生在拼接点之前。本文利用该技术判断后训练的改动主要位于早期层还是后期层。
读取位置(readout position)指模型在生成答案时,从序列的哪个位置提取用于决策的内部状态。对于分类或判断任务,模型往往不是直接读取被判断文本本身的 token 表征,而是读取文本之后的位置(如序列末尾、分隔符后)的聚合状态。后训练对读取路径的调整,正体现在这些位置的表征变化上。
可复现案例:否定陈述的真实性判断
由于原始语料无法共享,研究者补充了一个可从公开数据复现的案例:判断否定陈述的真实性。在这个任务中,后训练的作用方向与作者判断任务相反。
探针在所有模型中都能以接近 ceiling 的水平解码真实性,但多个基础模型的答案并未利用这一信息,后训练则修复了它们。按深度分析,修复在中间深度位于陈述之后的位置;在更浅层,陈述本身的表征也有贡献,但在四个模型只有一个中贡献较强。
同一套机制——读取位置与后训练对读取路径的调整——在两个方向相反的任务中都得到了验证,增强了结论的稳健性。
训练信号的定向作用
在一项训练研究中,研究者向原本相同的微调数据中加入 2000 条正确标注的新闻文本作者判断,结果模型在报纸和教科书语料上的答案得到改善,但在聊天语料上却出现反转——聊天语料上的答案跟随了基础模型上训练的新闻探针的方向。
这表明,少量训练信号就能设定判断被读取出来的方向。后训练并非简单地“增强”或“削弱”某个能力,而是将读取路径导向特定数据分布所偏好的方向。这解释了为何微调数据的选择会如此关键:它不仅在教模型新知识,更在重新校准模型如何读取已有知识。
对模型评估与对齐的启示
这项研究对实践有多重含义。首先,仅凭模型输出评估其内部知识可能产生误导——探针显示模型“知道”的信息,答案可能完全误读。其次,后训练数据的分布会系统性改变读取方向,这要求在对齐和微调时更加关注数据代表性。最后,机制层面的定位(监督微调、早期层、文本后位置)为干预提供了具体靶点。
模型表征与答案之间的鸿沟,不是简单的能力缺失,而是读取机制的偏移。理解这一点,才能更准确地诊断模型行为,并设计更有针对性的训练策略。
基率(base rate)指在判断任务中各类别出现的先验比例。理想贝叶斯观察者会将先验几率(odds)按比例整合进后验判断,即对数几率的变化应与先验几率的变化同幅。基础模型的“偏移不足”指其对数几率调整幅度小于先验变化,表现为对先验信息利用不充分;后训练模型的“偏移过度”则指调整幅度大于先验变化,表现为过度依赖提示中给出的基率。这一现象与信号检测理论中的判断标准偏移相对应,说明后训练改变了模型整合先验信息的方式。
相关推荐
多模态图像编辑的安全盲区:文本敏感、视觉失明
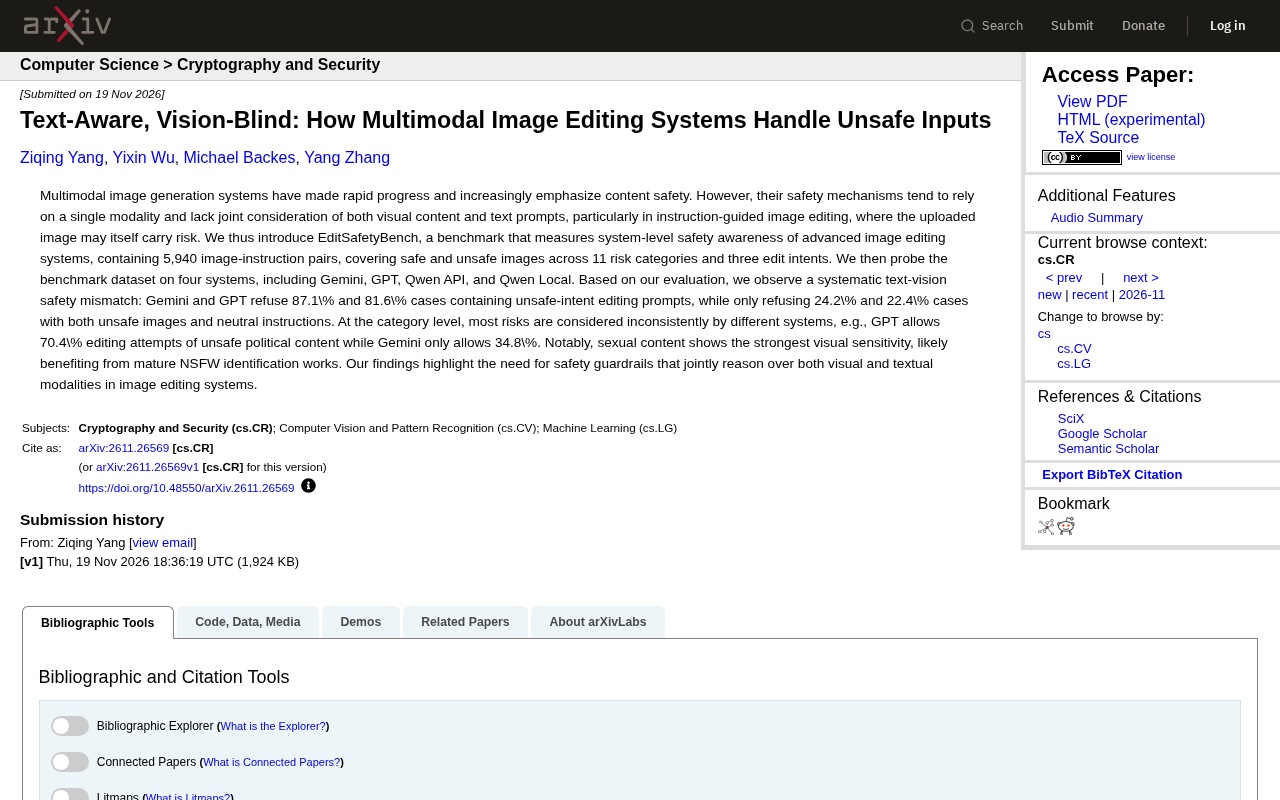
EditSafetyBench基准测试Gemini、GPT、Qwen等图像编辑系统,发现文本-视觉安全错配:系统对不安全提示拒绝率高,对不安全图像却大幅放行,呼吁多模态联合安全护栏。
GLiDE:从推理教师蒸馏的快速校准决策模型
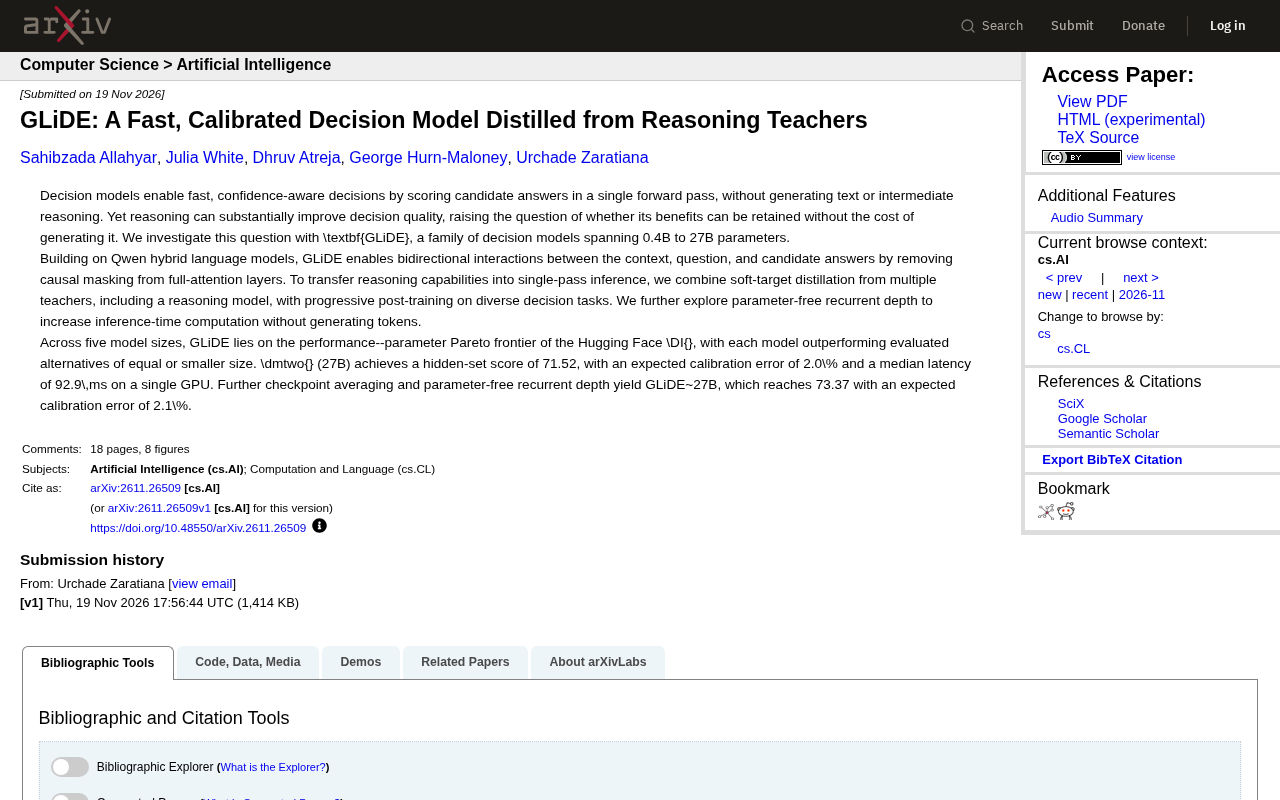
GLiDE 是一系列从推理教师蒸馏而来的决策模型,参数覆盖 0.4B 到 27B,通过移除因果掩码和软目标蒸馏实现单次前向的快速校准决策,27B 模型隐藏集得分 71.52,校准误差 2.0%,延迟 92.9ms。
用Claude Code几分钟搭建专业网站:五步实战指南
详解如何用Claude Code在几分钟内搭建专业网站:从规划提示词、精准迭代、MCP接入图片生成,到参考图重做设计与一键发布上线的完整五步流程。