互斥锁(Mutex)原理详解:从银行取款到原子交换

互斥锁通过原子交换指令保护临界区,需注意自旋开销、内存顺序和死锁预防。
文章基于 Computerphile 的视频《Mutex Explained》,以银行取款为例讲解了互斥锁的必要性:多线程同时执行“检查-修改”逻辑会导致数据不一致,因此需要互斥锁确保临界区一次只被一个线程执行。互斥锁的实现依赖硬件提供的原子交换指令(如 xchg),通过原子地读写内存实现锁状态切换,形成自旋锁。自旋锁简单但浪费 CPU,现代操作系统会在自旋一段时间后挂起等待线程。此外,内存屏障防止编译器和 CPU 重排指令,确保锁的正确性;多锁场景下需按固定顺序获取锁以避免死锁。文章最后总结了互斥锁的关键要点,强调正确使用锁需要关注自旋开销、内存顺序和死锁预防。
在并发编程中,多个线程或进程同时访问共享资源时,很容易出现数据不一致的问题。Computerphile 的视频《Mutex Explained》用一个生动的银行取款例子,深入浅出地讲解了互斥锁(Mutex)的工作原理、实现机制以及实际使用中的陷阱。
为什么需要互斥锁?
视频从一个经典的并发问题开始:假设有一个银行账户,取款函数会先检查余额是否充足,如果足够则扣除相应金额并吐钞。代码逻辑大致如下:
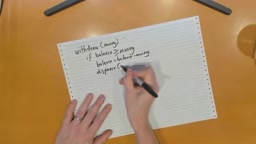
当两个线程同时执行这段代码时,它们可能都检查到余额充足,然后都执行扣款,导致账户被透支。这个问题不仅出现在单个 CPU 上,也存在于分布式系统中,比如两个人同时从同一账户取钱。
互斥锁的作用就是确保这段“检查-修改”的代码一次只能被一个线程执行。就像公共卫生间门上的锁:里面有人时,外面的人必须等待;里面的人出来后,锁释放,其他人才能进入。
临界区(Critical Section) 是并发编程中的核心概念,指一段访问共享资源(如银行账户余额)的代码。互斥锁的目的正是保证同一时刻最多只有一个线程能进入临界区。典型情况下,临界区涉及“读取-修改-写回”序列,例如先检查余额、再扣款、最后写回结果。若多个线程交错执行这些步骤,就会导致竞态条件(Race Condition)。临界区必须尽可能小,只包裹真正需要互斥的操作,以减少锁的持有时间,提升并发性能。
互斥锁的实现:原子交换指令
最直观的实现思路可能是用一个变量表示锁的状态,然后检查并设置。但这样做会陷入同样的竞争条件:两个线程可能同时看到锁是空闲的,然后都认为自己获取了锁。
因此,硬件必须提供一种原子操作,让读取和写入不可分割。视频中介绍了常见的原子交换指令(如 xchg):
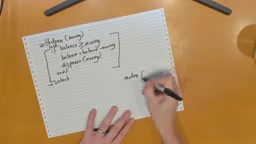
具体做法是:内存中有一个 mutex 变量,初始为 0。加锁时,执行原子交换,将 1 写入 mutex 并返回旧值。如果旧值为 0,说明之前无人持有锁,当前线程成功获取;如果旧值为 1,说明锁已被占用,当前线程需要继续尝试(自旋)。解锁则简单地将 mutex 置为 0。
这种基于原子交换的锁被称为自旋锁(spinlock),因为等待锁的线程会不断循环检查。
自旋锁(Spinlock) 是一种基于忙等待的锁实现:线程在获取锁失败时,会反复执行原子交换指令(或测试-设置指令),直到成功获取锁为止。其优点是避免了操作系统上下文切换的开销,在锁持有时间极短且竞争不激烈的场景下性能出色。然而,自旋锁的缺点也很明显:等待线程持续消耗 CPU 周期,若锁被长时间持有,会浪费大量计算资源。因此,自旋锁通常用于多核处理器上的短临界区,或者内核中禁止睡眠的上下文。
自旋锁的代价与操作系统优化
自旋锁虽然简单,但存在明显缺陷:等待锁的线程会持续消耗 CPU 资源。视频中用“不停敲门问好了没”来比喻这种忙等待,既惹人烦又浪费计算资源。
现代操作系统通常会在自旋几次后,将等待的线程挂起(睡眠),让出 CPU 给其他任务。解锁时,操作系统还需要负责唤醒等待的线程。
这种机制虽然更复杂,但能显著提升系统整体效率,尤其是在锁竞争激烈时。
内存顺序与编译器屏障
另一个容易被忽视的问题是内存顺序。编译器和 CPU 都可能对指令进行重排优化,导致加锁和解锁之间的代码被错误地提前或延后执行。例如,可能在获取锁之前就读取了共享数据,或者在解锁之后才写入数据。
因此,原子交换指令通常附带内存屏障(memory barrier)语义,防止编译器和 CPU 越界重排。x86 架构对内存顺序较为严格,而 ARM 等架构则更宽松,需要开发者显式处理。
内存屏障(Memory Barrier) 是一种硬件或编译器指令,用于强制规定内存操作的顺序。在锁的实现中,获取锁(如原子交换)通常需要“获取语义”(acquire semantics),确保之后的读写操作不会重排到锁获取之前;释放锁则需要“释放语义”(release semantics),确保之前的读写操作不会重排到锁释放之后。x86 架构提供了较强的内存顺序保证(如 TSO 模型),而 ARM、PowerPC 等弱内存模型架构则需要显式的内存屏障指令(如 DMB、ISB)来保证顺序。C++11 及后续标准引入了 std::atomic 和内存序(memory order)参数,让开发者可以精确控制这些语义。
多锁场景与死锁风险
当程序需要多个锁时(比如转账需要同时锁定两个账户),死锁风险随之而来。假设线程 A 锁定账户 1 后尝试锁定账户 2,而线程 B 锁定账户 2 后尝试锁定账户 1,两者就会互相等待,永远无法继续。
这就是经典的死锁问题,类似于“哲学家就餐”。视频中提到一种常见解决方案:为所有锁定义全局顺序(如按账户编号排序),所有线程都按相同顺序获取锁,从而避免循环等待。
此外,数据库系统常采用超时回滚机制来应对死锁,但根本的预防仍依赖于良好的锁获取纪律。
死锁(Deadlock) 的发生需要同时满足四个必要条件:互斥、占有且等待、不可抢占、循环等待。破坏其中任一条件即可预防死锁。按全局顺序获取锁实际上破坏了“循环等待”条件。此外,常见的应对策略还包括:使用超时机制(如 try_lock 带超时)打破“不可抢占”条件;使用资源一次性分配(如 std::lock 同时锁定多个互斥量)来避免“占有且等待”;或者通过死锁检测算法定期检查资源分配图。数据库系统中,死锁检测与回滚是常见做法,而在通用并发编程中,预防性设计(如锁顺序)往往是更可靠的选择。
总结与延伸
互斥锁是并发编程的基石,通过硬件提供的原子交换指令,我们可以在软件层面构建出可靠的锁。然而,正确使用锁需要关注自旋开销、内存顺序和死锁预防等多个方面。Computerphile 的视频以直观的类比和清晰的代码逻辑,帮助开发者理解这些底层机制,为编写安全的并发程序打下基础。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。