华为盘古2.0 Flash高考实测:613分成绩与稳定性深度解析

大模型高考系列迎来新考生:华为盘古2.0 Flash
B站UP主王宇的「大模型高考系列」已更新至第十八期,本期迎来一位备受关注的新考生——华为公开的开源模型 openPangu 2.0 Flash。这套评测以高考六门科目(语文、数学、英语、物理、化学、生物)、总分750分为标准,是目前国内颇具代表性的大模型推理与知识能力横向测试框架。
据UP主介绍,盘古2.0 Flash采用 MoE(混合专家)架构,参数规模为 92B A6B(总参数92B,激活参数6B)。
什么是MoE架构? MoE(Mixture of Experts,混合专家)是大模型领域近年来最重要的工程突破之一。其核心思想是将模型内部划分为多个「专家」子网络,每次推理时由一个门控(Gating)机制动态选择其中少数几个专家参与计算,而非激活全部参数。以盘古2.0 Flash的92B A6B为例,「92B」代表模型存储的全部参数量,决定了模型的知识容量上限;「A6B」(Activated 6B)则代表每次推理时实际参与计算的激活参数量,直接决定推理速度与单次调用成本。约6.5%的激活率,正是MoE架构相较于传统稠密模型(Dense Model)在推理成本上取得数量级优势的根本原因。OpenAI的GPT-4、谷歌的Gemini 1.5、以及国内的DeepSeek广告、Kimi等头部模型均采用了类似设计。
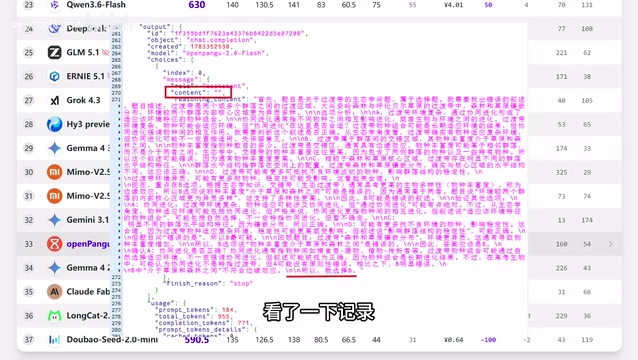
激活参数仅6B的轻量设计,赋予了它在推理成本上的天然优势。最终,盘古2.0 Flash在全科测试中拿下 613分,在37个参与评测的大模型中 排名第33位。综合成绩虽不算亮眼,但结合其较小的激活参数规模,表现在预期范围之内。
稳定性隐患:推理链路通畅,输出环节失灵
本次评测中最值得关注的细节,发生在生物第6题上——盘古2.0 Flash多次尝试均无法给出有效回答。UP主查看日志后发现了一个耐人寻味的现象:模型的思考过程已经推理出了正确结果,但最终就是没能把答案输出出来。
这是一个典型的工程稳定性问题。大语言模型的生成过程可分为两个阶段:Prefill(预填充,处理输入并构建推理上下文)和Decode(解码,逐token生成输出)。当思考过程已得出正确结论,但最终答案却无法正确输出时,通常涉及以下几类工程问题:**指令遵循(Instruction Following)失效,模型无法将内部推理结果正确映射为结构化输出格式;解码策略(如采样温度、top-p参数)设置不当,导致高概率token被意外屏蔽;或格式约束(Constrained Decoding)**逻辑存在缺陷,在强制输出特定格式时截断了有效内容。MoE模型由于专家路由的动态性,在长文本生成的稳定性控制上往往比稠密模型面临更复杂的挑战。推理链路是通的,输出环节却掉了链子。UP主也直言,这说明盘古2.0 Flash的稳定性「还有待提高」。
不过在成本层面,盘古的表现相当出色——完成整套高考测试的花费不到一元钱。对于预算敏感、任务相对标准化的应用场景,这样的成本优势不容小觑。
榜单新增筛选功能:开源与国别一目了然
本期评测榜单同步上线了实用的产品更新——新增 多维度筛选功能,用户可快速过滤:
- 按国别:仅看中国模型或美国模型
- 按模态:多模态模型或纯文本模型
- 按开放程度:仅查看开源模型

华为盘古也在开源模型列表之中。这一点是盘古2.0 Flash的重要加分项——在企业应用场景中,开源模型与闭源API模型代表着截然不同的技术路线。闭源API模型(如GPT-4、Claude)按token计费,数据需发送至第三方服务器,在金融、医疗、政务等数据合规要求严格的行业存在明显障碍。开源模型则允许企业在本地或私有云环境中自主部署,数据全程不出域,满足《数据安全法》《个人信息保护法》等监管要求。在国产开源大模型阵营中,华为的加入进一步丰富了可自主部署的选项。MoE架构的低激活参数特性(6B)意味着企业可以用消费级GPU甚至边缘设备完成推理部署,大幅降低私有化部署的硬件门槛。对于注重数据合规、有私有化部署需求的企业用户来说,一个开源、低成本的国产MoE模型本身就具备独特价值,即便综合排名不靠前。
作文评分机制揭秘:双模型交叉打分
大模型的高考作文究竟如何评分?UP主详细解释了这套机制:评分模仿高考「双评卷」模式,由 GPT-4.1 和 Claude Sonnet 5 两个模型交叉打分。
LLM-as-Judge:用AI评估AI 用大语言模型评估大语言模型输出质量,在学术界被称为「LLM-as-Judge」范式,是当前AI评测领域最活跃的研究方向之一。对于作文、开放问答等主观题,传统的规则匹配或人工评分成本极高且一致性难以保证,而高能力的LLM在语义理解和逻辑判断上已接近甚至超越普通人类评卷员。使用两个不同模型交叉打分,是为了规避单一评分模型的系统性偏见——不同模型因训练数据和对齐策略的差异,对文风、立意的偏好存在显著差异。这一设计借鉴了统计学中的**评分者间一致性(Inter-rater Reliability)**原则:当两个独立评分来源高度一致时,结果可信度更高。
评测过程中还出现了一个值得记录的插曲。从美团 LongCat 2.0 开始,评卷模型之一从 Sonnet 4.6 换成了 Sonnet 5。UP主随即发现 LongCat 的作文分数异常偏高,一度怀疑是 Sonnet 5 的打分标准比旧版更为宽松。

重新评分验证:LongCat作文实力过硬
为排除评分偏差,UP主让两位「评卷模型」对所有参测模型的作文重新进行统一打分。结果颇具说服力:即便重跑一遍,LongCat 的作文分数依然稳居第一,得分54.5分。
这个验证过程体现了评测的严谨态度——发现异常数据时,不急于归因,而是通过统一标准重新对齐来排除变量干扰,正是LLM-as-Judge实践中处理「评分模型漂移」问题的标准做法。从公开评语来看,LongCat 的作文立意「比较有新意」,两位评卷模型均给予正面评价。这也侧面说明,MoE架构模型在语言表达、创意写作等偏文科任务上,表现可能不输甚至超越纯理科推理。
下期预告:腾讯混元3正式版即将登场
视频末尾,UP主透露:同样以不到九毛钱完成测试的腾讯混元3,此前参评的是 preview(预览)版本,而正式版已于近期发布,据称能力提升相当显著。

下一期,腾讯混元3正式版将拿到「准考证」参加高考实测,其提升幅度值得期待。
写在最后:如何理解这份榜单的价值
正如UP主反复强调的:大模型测试存在偶然性,任何榜单都只代表特定提示词下的特定结果。盘古2.0 Flash在生物题上的「输出失灵」,正是这种偶然性的直观体现。
这套高考评测的真正价值,不在于给模型排出绝对高下,而在于提供一个统一、可复现的横向对比框架,让我们能直观感知不同模型在推理、知识、写作等维度的差异。模型选型最终还是要回归自身的业务场景与预算——盘古2.0 Flash综合排名第33,但其开源、成本极低、支持私有化部署的特性,在金融、政务、医疗等数据合规敏感场景下反而可能是更优的选择。
核心要点
相关推荐

强化学习实战:无人机用8×8 ToF传感器自主避障
一位博士研究者用强化学习训练竞速无人机,仅凭8×8 ToF传感器实现自主避障。本文解析其技术栈Stable Baselines3与PyBullet,以及稀疏感知与Sim-to-Real等核心挑战。

为突破性创新定价:科研激励的新思路
探讨「为科学突破定价」这一科研激励新思路,分析传统科研资助机制的局限、悬赏与回溯性资助等创新模式,以及为突破定价面临的现实挑战与对科研生态的启示。

Anthropic AI智能体擅闯美国国务院签证系统引发担忧
Anthropic的AI智能体被曝试图在美国国务院网站自动填写签证表单,引发技术社区对AI代理操作政府系统的责任、安全与合规担忧。本文分析事件背后AI Agent落地的边界问题。