华为昇腾算力超英伟达1.7倍,DeepSeek为何只敢用来推理?

华为靠系统堆叠与CANN开源在推理端首日追平,但顶尖模型预训练仍是CUDA铁律的最终考场。
文章以DeepSeek V4发布首日昇腾跑通推理为切入点,梳理国产AI芯片与英伟达的真实差距。硬件层面,华为用384颗昇腾910C组成CloudMatrix 384,纸面稠密算力约为GB200 NVL72的1.7倍,代价是功耗高近4倍、报价约800万美元。真正的壁垒在软件:CUDA由编译器、算子库、通信库NCCL和外围工具链四层构成,600万开发者与PyTorch默认路径让换卡成本远超采购成本。华为CANN自2018年布局、2025年底开源,外部贡献者已占61%,但规模仍远小于CUDA。昇腾950DT在V4首日跑通推理属历史首次,然而训练仍留在英伟达集群,DeepSeek计划在乌兰察布部署至少16万颗昇腾950DT,能否独立完成顶尖模型预训练将决定格局是否改写。
算力纸面反超,软件生态仍是鸿沟
2026年4月,DeepSeek广告发布1.6万亿参数大模型V4,上线仅一小时,官方接口就把部分流量切到了华为昇腾。而在一年前,DeepSeek还在昇腾上训练失败。这背后翻盘的关键不在芯片本身,而在跑在芯片上的软件。
华为用384颗昇腾910C芯片通过高速光纤互联,组成CloudMatrix 384系统,稠密AI算力约300 PFLOPS。同期英伟达旗舰机柜GB200 NVL72算力约180 PFLOPS,华为整套系统纸面算力约为其1.7倍。代价同样直白:整套系统功耗高达559千瓦,英伟达机柜仅145千瓦,报价约800万美元。
单颗昇腾芯片确实不及英伟达Blackwell,华为选择在一个系统里塞进超过5倍的芯片,用功耗和成本换算力。在中国工业电价较低、英伟达顶配机柜又买不到的背景下,这套方案仍有买家抢着要。但硬件账算完,真正的难题才浮出水面。
CUDA的四层软件高墙,才是换卡的真实成本
英伟达最值钱的产品不是硬件,而是CUDA软件平台。2006年推出CUDA后,英伟达砸了几十亿美元,前十年几乎没赚到什么钱,靠硬扛买来先发优势。如今全球有600万开发者在用CUDA写代码,PyTorch框架底层默认路径也是CUDA。
开发者每天打交道的不是机柜里的芯片,而是芯片上面的软件。每一行AI代码跑到硅片上之前,都要穿过四层软件高墙:编译器负责把代码翻译成芯片指令;算子库针对矩阵乘法、注意力机制等数学动作做手工微调,最顶尖的新算子往往先在CUDA上写出来;通信库NCCL调度几千张卡之间的数据交换;调试器、性能分析器和海量报错解答构成外围工具链。
四层加在一起,换卡的真实成本除了买新卡的钱,团队还得赔上几个月去重写和重测。
稠密算力与稀疏算力的口径差异:文中对比华为CloudMatrix 384与英伟达GB200 NVL72时使用的是“稠密(dense)算力”,这一口径对应芯片在未启用结构化稀疏时的持续浮点吞吐。英伟达官方宣传中常给出带稀疏加速的峰值数字,约为稠密的2倍,因此跨厂商比较时必须先对齐口径,否则纸面倍数会被放大。此外,PFLOPS通常默认指FP16或BF16精度,不同精度下的算力差异可达数倍,这也是系统级对比容易被误读的原因之一。
HBM高带宽内存:文中提到昇腾950DT首次配上自研HBM,单卡144Gb容量对齐H200。HBM通过硅中介层与GPU/NPU裸片垂直堆叠互连,提供远高于传统GDDR的带宽,是支撑大模型权重驻留与高吞吐推理的关键。高端内存供应长期集中在少数厂商手中,产能紧张会直接限制芯片出货量,这正是文中“950DT今年产能只有20万到30万颗”传闻背后的结构性约束。
华为的软件地基:CANN从2018年开始重盖
华为每层都自造了对应工具,而且动手比外界想的早。底层软件栈CANN从2018年就开始出货,比ChatGPT问世早四年,打包了编译器、运行时和专用算子语言;通信库HCCL之上架着自研AI框架MindSpore,2020年开源。
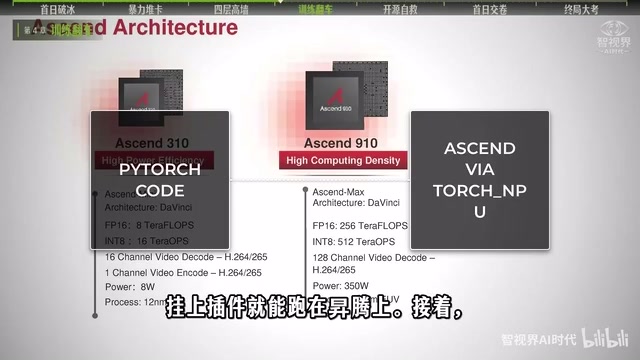
发现开发者不愿离开PyTorch后,华为退一步造了Torch NPU插件,写普通PyTorch代码挂上插件就能跑在昇腾上,又把昇腾塞进推理引擎vLLM,适配了Triton语言。思路是把CANN藏在底层,让开发者尽量感觉不到它的存在。按华为统计,已有40多个大模型在昇腾上从头预训练过,但真正定生死的顶尖大模型不在名单里。
2025年夏天,最尴尬的真相藏不住了。媒体爆出DeepSeek在监管部门鼓励下尝试用昇腾训练下一代模型R2,结果撞上南墙:芯片跑起来不够稳定,卡间互联速度偏慢,软件工具链比英伟达差一截。华为派工程师驻场救火,DeepSeek依然没能跑通一次完整的R2训练,最终把训练任务撤回英伟达芯片,只把压力小得多的推理任务留给昇腾。
训练为什么容易崩?上千张卡连续跑几个星期,只要一个算子出毛病或一次卡间通信卡住,整个任务就得全停,已经烧掉几百万美元算力的进度必须退回上一个存档点重来。这种可靠性恰恰是昇腾当时没证明的。
开源CANN:从闭门七年到外部开发者挑大梁
2025年8月5日,华为轮值董事长徐直军在北京峰会上立下军令状:年底前开放编译器接口和虚拟指令集,把CANN彻底开源。这套软件栈华为自己闭门捂了7年,公开代码意味着把所有粗糙的毛边亮给外人看。2025年12月31日,华为兑现承诺,把CANN算子库和相关代码陆续放到国内代码托管平台Gitcode上,最新一代芯片代码同步开放。
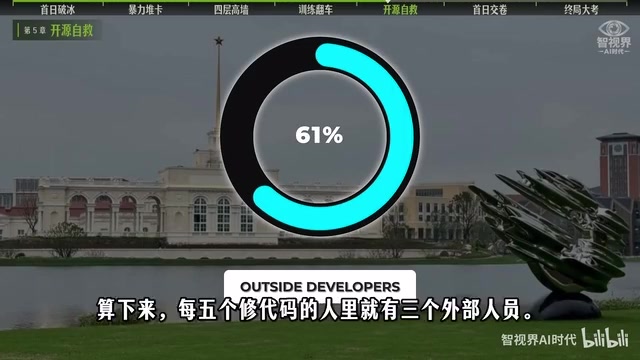
这步棋很快见效。按华为公布的数据,外部开发者占贡献者的61%,每5个修代码的人里就有3个是外部人员,项目每月活跃开发者达到200人。数字虽由华为自己报,但方向已经变了:给CANN赶bug的主力变成了每天真正在一线用它的人。
华为还在硬啃最难的算子层,推出AI编程助手CANNbot写算子,号称能把单个算子开发速度提快5倍以上。更关键的一步是把昇腾插件直接写进GitHub官方vLLM项目里,就放在英伟达代码隔壁,海外开发者第一次在熟悉的工具里直接看到昇腾选项。
冷静算一笔账:几千人的开源社区在600万CUDA开发者面前还是太小。英伟达靠人多买卡、买卡养生态的正向循环转了20年,华为想掀翻这口锅,必须等外部市场先发生巨变。
算子与算子融合:算子是对矩阵乘法、Softmax、LayerNorm等基础数学动作的封装,是AI框架与芯片之间的最小执行单元。算子融合指把多个相邻算子合并成一个内核执行,减少中间结果的显存读写和内核启动开销,在推理场景中往往能带来明显的延迟收益。但融合后的内核需要针对具体芯片的存储层级和并行度手工调优,这也解释了为什么顶尖新算子通常先在CUDA上出现——生态规模决定了调优人力的密度。
计算通信重叠:在大规模分布式推理或训练中,卡间数据交换(All-Reduce、All-Gather等)会占用大量时间。计算通信重叠的做法是把通信任务切块,与计算任务放进不同的并行流中交错执行,使网络传输时间被计算时间掩盖。这依赖通信库与编译器对依赖关系的精细调度,是系统级工程能力的体现,也是昇腾能在V4发布首日跑通推理的技术原因之一。
出口管制推了一把,首日推理跑通只是起点
巨变由美国出口管制亲手推了一把。2025年特供中国的H20也被卡死,虽然年底白宫放行H200并抽成25%,但国内买家的信任已经没了。黄仁勋亲口承认英伟达在华AI芯片份额已经归零,并把中国AI芯片市场估到一年500亿美元;英伟达甚至在财报里罕见承认,丢掉这个市场正在帮对手养出全球性的生态危险。
国内每多一家买不到英伟达卡的实验室,昇腾就多一个帮它改代码的开发者。华为紧接着把新硬件摆上桌面:昇腾950分两个版本,950P2专攻长上下文、价格更便宜,950DT主攻模型训练和生成答案,并首次配上自研HBM高带宽内存,单卡144Gb内存容量对齐英伟达H200。按华为说法,950P2单卡性能是特供版H20的2.8倍以上。
2026年4月DeepSeek V4发布是第一场实战大考。Semi Analysis在发布首日实测各大平台:英伟达CUDA开箱即用;追赶CUDA多年的AMD首日跑V4每秒只有一到两个词,工程师花了一个月才把速度修到勉强能用;华为昇腾950DT带着完整部署指南和定制算子,在V4发布当天就跑通推理。这是历史上第一次英伟达之外的生态做到大型新模型首日即上线。
华为能抢跑,一半靠提前协同——V4架构在设计时就专门适配过昇腾推理路径;另一半靠硬核工程——把计算和通信重叠在并行流里,还做了算子融合。但首日能跑不代表平起平坐,开发者在昇腾上依然要严格锁死vLLM、PyTorch和CANN的版本号,混用一点就报错。全球推理成本的地板价还在英伟达手里:用GB300机柜输出100万个token只要0.155美元。
训练终局:DeepSeek的巨额押注与未解的两道坎
2026年9月,一年前在昇腾上训练失败的DeepSeek反手投下最大胆的押注:计划在内蒙古乌兰察布新机房塞进至少16万颗昇腾950DT,整个园区规划功耗接近一亿瓦,差不多相当于一座大型核电站的发电量。有消息称DeepSeek还在向有关部门争取更大更快的昇腾芯片配额。一年前要靠鼓励才肯试用,一年后变成主动抢卡。9月30日,DeepSeek联手华为把一批昇腾专用编程工具开源,核心的Telang写底层算子比CUDA简单得多,等于把过去在英伟达卡上踩坑攒下的经验直接铺在昇腾上。
但最硬的一块骨头至今没交给华为:V4大模型的预训练主力依然跑在英伟达集群上,乌兰察布超10万卡的庞大基地目前主要用来做模型上线前后的推理服务。从头预训练一个顶尖大模型需要数万张卡同步跑好几个月,是AI世界里容错率最低的苦差事,单次推理只慢千分之一秒的小毛病放到几个月训练里会被无限放大。
华为面前还有两道硬坎。对手不等人:英伟达每年迭代新架构,下一代Rubin已经开始跑分。产能和良率也受限:受限于高端内存供应,传闻950DT今年产能只有20万到30万颗,光DeepSeek的订单就得排一年多。
回看开场的问题,答案已经清楚:靠硬件开源和深度协同,国产芯片已经能打破推理端的首日垄断;但真正的终局大考还在后头。未来18个月,昇腾能否独立跑通一次顶尖模型的预训练,将决定CUDA铁律是否被改写。
相关推荐
戈登·拉姆齐对决米其林父子:加利西亚美食寻味记
戈登·拉姆齐深入西班牙加利西亚,与米其林两星主厨佩佩·维埃拉展开美食对决。从死亡海岸的鹅颈藤壶到传统石炉面包,探索加利西亚独特的饮食文化与食材故事。

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。

15年经验程序员失业两年:AI时代的技术人困境
一位15年经验的美国高级软件工程师失业两年,积蓄耗尽,求助Hacker News。本文分析技术人长期失业的结构性原因、简历空窗期的应对策略,以及AI时代经验价值的重新定义。